
RabbitMQ 面试
RabbitMQ 简介
【简单】RabbitMQ 是什么?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:5 min | 🏷 标签:RabbitMQ / 基础概念
💎 关键结论
RabbitMQ 是基于 AMQP 协议、用 Erlang 实现的开源消息中间件,由 Broker 通过「交换机 + 绑定 + 队列」完成消息的接收、路由与存储。选它是因为投递可靠(Confirm + 持久化 + 仲裁队列)、路由灵活、延迟低,适合解耦、削峰、异步化等业务消息场景。
⚡ 记忆卡片
- 口诀:一协议(AMQP)、一代理(Broker)、路由三件套(交换机—绑定—路由键)
- 关键词:AMQP / Broker / Exchange / Queue / Binding / Routing Key / VHost
- 链路:生产者带路由键发消息 → 交换机按绑定规则匹配 → 消息进入一个或多个队列 → 消费者订阅消费 → 手动 ACK → Broker 删除消息
📖 核心知识
RabbitMQ 是一个开源的消息队列中间件,基于 AMQP(Advanced Message Queuing Protocol,高级消息队列协议)标准实现。
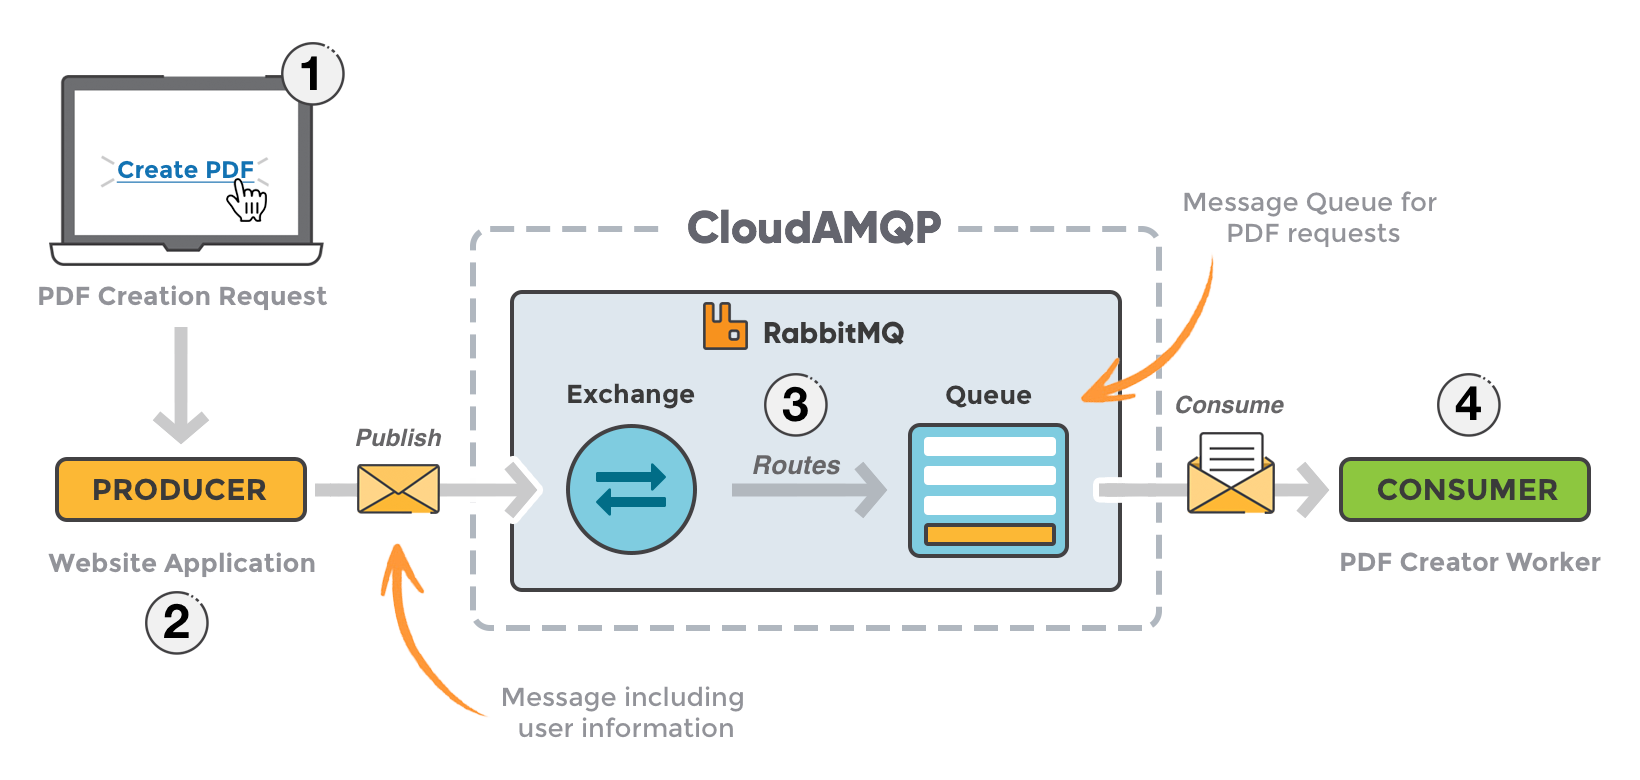
RabbitMQ 的核心概念
- 生产者(Producer):发送消息的应用。
- 消费者(Consumer):接收和处理消息的应用。
- 消息代理(Broker):负责接收、路由和存储消息。
- 交换机(Exchange):消息路由中心,根据规则将消息发到不同队列。
- 队列(Queue):存储消息的缓冲区。
- 绑定(Binding):定义交换机与队列的映射关系(含路由键规则)。
- 路由键(Routing Key):生产者发送时指定的关键字,用于交换机匹配队列。
- 虚拟主机(VHost):逻辑隔离单元(类似命名空间),不同 VHost 的队列/交换机互不可见。
- 死信队列(DLX):用于存放处理失败或过期消息的“垃圾回收站”或“隔离分析区”。
- AMQP:RabbitMQ 的核心通信协议,定义消息格式与交互规则。
🔀 发散问题
Q:RabbitMQ 基于 AMQP 协议,而 Kafka 使用自定义二进制协议,这两种协议设计选择对各自适用场景有什么影响?
→ AMQP 是标准化协议,定义了丰富的路由模型(Exchange/Binding)、确认和事务语义,使 RabbitMQ 天然支持复杂路由和跨平台互操作,但协议开销较大。Kafka 的自定义协议极简高效,围绕 Topic-Partition 的追加写和拉取设计,牺牲了灵活路由能力,换来了极高的吞吐量和低延迟,适合日志和流数据场景。
Q:RabbitMQ 的 VHost 隔离机制能否替代多集群部署?在安全要求较高的多租户场景中有什么局限?
→ VHost 提供逻辑隔离,不同 VHost 的 Exchange、Queue、用户权限完全独立,能满足一般的多应用资源隔离需求且无需额外集群开销。但在安全要求较高的场景中,VHost 共享同一 Broker 的 CPU、内存和网络资源,无法做到资源配额硬隔离和故障隔离,因此金融级多租户通常需要独立集群部署。
【简单】RabbitMQ 有哪些核心组件?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:5 min | 🏷 标签:RabbitMQ / 架构组件
💎 关键结论
RabbitMQ 的核心组件可概括为「三类角色 + 一条链路」:生产者/消费者/Broker 三类角色,消息沿 Producer → Exchange →(Binding)→ Queue → Consumer 链路流动,而 Connection/Channel 承载通信、VHost 承载隔离。记住这条链路就能串起全部组件。
⚡ 记忆卡片
- 口诀:生产消费靠 Broker,路由绑定连队列,连接信道走消息,虚拟主机做隔离
- 关键词:Producer / Consumer / Exchange / Queue / Binding / Routing Key / Virtual Host / Connection / Channel
- 链路:Producer 经 Connection 上的 Channel 发消息 → Exchange 依据 Binding 与 Routing Key 路由 → Queue 存储 → Consumer 经 Channel 拉取/推送消费
📖 核心知识
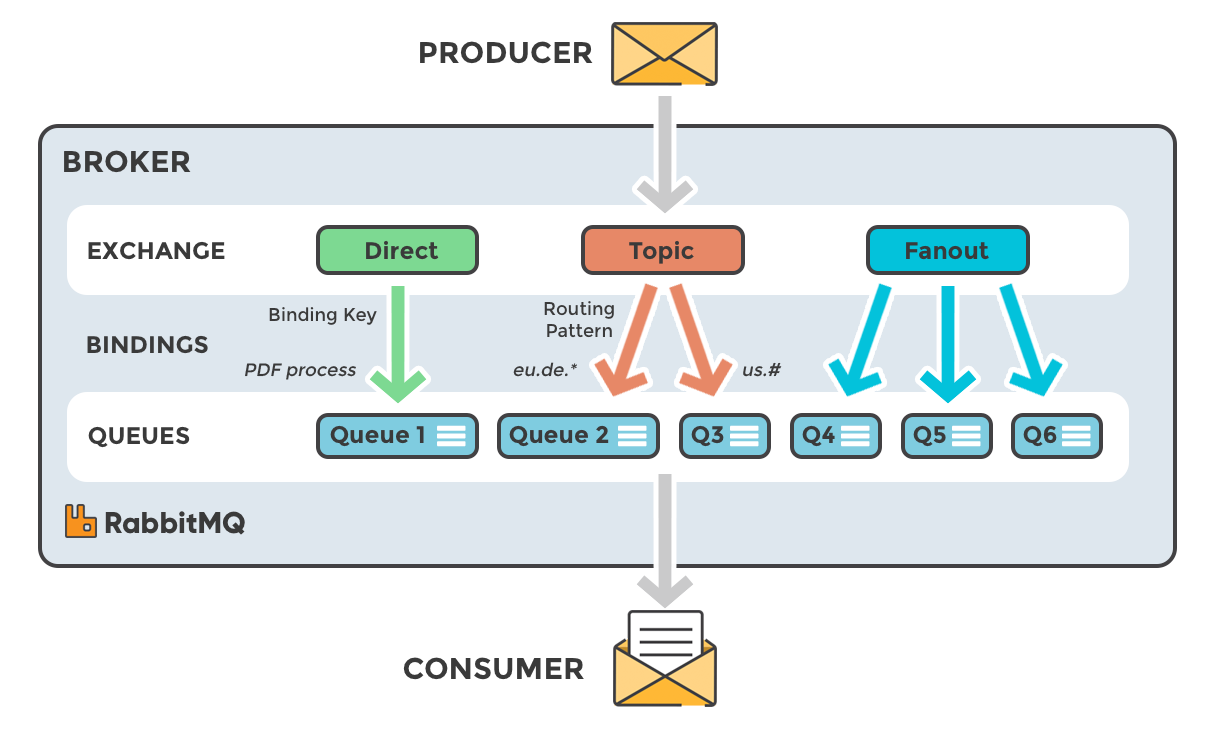
RabbitMQ 的基本架构主要由以下核心组件组成:
- Producer(生产者):负责发送消息到交换机。
- Consumer(消费者):接收并处理队列中的消息。
- Exchange(交换机):接受并路由消息到队列,根据绑定键将消息分配到一个或多个队列。
- Queue(队列):消息的存储地点,消费者从队列中读取消息。
- Binding(绑定):定义交换机和队列之间的路由规则。
- Routing Key(路由键):用于交换机到队列的路由规则。
- Virtual Host(虚拟主机):逻辑分组,用于隔离不同应用的资源。
- Connection(连接):RabbitMQ 的客户端与服务器之间的网络连接。
- Channel(信道):在连接中的虚拟连接,进行消息的读写操作。
🔀 发散问题
Q:为什么 RabbitMQ 要设计 Connection 和 Channel 两层抽象?如果每个线程都创建独立 Connection 会有什么问题?
→ Connection 是底层 TCP 连接,建立和维持的开销较大(TCP 三次握手 + TLS + AMQP 握手),且操作系统对文件描述符数量有限制。Channel 是 Connection 上的轻量级逻辑信道,多个 Channel 复用同一条 TCP 连接,既实现了线程隔离又避免了连接数爆炸,是 RabbitMQ 高并发场景下的关键性能优化。
Q:Exchange 的四种路由模式(Direct/Fanout/Topic/Headers)分别适用于什么业务场景?如何用 Topic Exchange 实现多级路由?
→ Direct 适合精确路由(如订单服务按订单号分发);Fanout 适合广播(如缓存同步通知所有节点);Topic 适合按通配符匹配的多级分类路由(如
order.east.*);Headers 适合基于消息属性键值对的复杂条件路由。Topic Exchange 通过.分隔的多级路由键和*(匹配一个单词)、#(匹配零或多个单词)通配符,可以灵活实现按地域、业务类型等多维度路由。
【中等】RabbitMQ 中 Connection 和 Channel 有什么区别?⭐⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:10 min | 🏷 标签:RabbitMQ / 客户端通信
💎 关键结论
Connection 是客户端与 Broker 之间的 TCP 物理连接,开销大;Channel 是 Connection 上的轻量逻辑信道,所有 AMQP 操作都在 Channel 上完成。原因是 TCP 建连昂贵且操作系统限制连接数,用多 Channel 复用一条连接才能兼顾性能与隔离。
⚡ 记忆卡片
- 口诀:连接物理信道虚,一线一信道,长连复用不能少
- 关键词:TCP 物理连接 / 虚拟信道 / 多路复用 / 线程隔离 / 长连接
- 链路:建立 TCP Connection(三次握手)→ 按需创建多个 Channel → 各线程独占 Channel 收发 → Channel 关闭而 Connection 保留 → 应用停机才断连
📖 核心知识
- Connection:客户端与 Broker 之间的 TCP 物理连接,开销大(建连、握手、心跳维护)。
- Channel:Connection 上的 虚拟连接(逻辑信道),AMQP 操作(发布、消费、声明队列)都在 Channel 上进行。
为什么要引入 Channel?
- TCP 连接昂贵:每次创建 TCP 连接都需要三次握手,且操作系统对连接数有限制。
- 多路复用:一个 Connection 上可以创建多个 Channel,共享 TCP 连接,减少网络开销。
- 线程隔离:多线程环境下,每个线程使用独立的 Channel,避免并发冲突。
使用建议
| 场景 | 建议 |
|---|---|
| 短连接 vs 长连接 | 生产环境必须使用长连接,避免频繁建连 |
| Channel 复用 | 不要每次操作都创建 Channel,应复用 |
| 线程与 Channel | 每个线程独占一个 Channel,Channel 不是线程安全的 |
| Connection 池 | 高并发场景使用连接池(如 Spring AMQP 的 CachingConnectionFactory) |
| Channel 数量 | 单 Connection 上 Channel 数不宜过多(建议 ≤ 100),否则增加 Broker 压力 |
案例:长连接 + 多 Channel 的正确用法(Java)
// 正确用法:长连接 + 多 Channel
Connection connection = factory.newConnection(); // 复用连接
Channel channel1 = connection.createChannel();   // 线程1 使用
Channel channel2 = connection.createChannel();   // 线程2 使用
// 使用完毕后关闭 Channel,但保持 Connection
channel1.close();
channel2.close();
connection.close(); // 应用关闭时才关闭连接
🔬 扩展知识
【L3】Channel 上限与资源协商
详情
客户端与 Broker 在连接握手时通过 channel_max、frame_max、heartbeat 三个参数协商资源上限。channel_max 限定单连接最大 Channel 数(0 表示无限制,服务端通常配置上限),每个 Channel 在 Broker 端对应独立的 Erlang 进程与状态,Channel 过多会放大 Broker 的进程与内存压力,这也是「单连接 Channel 不宜过多」的底层原因。
【L4】多路复用设计的类比
详情
Connection/Channel 的「一条物理连接复用多个逻辑流」与 HTTP/2 的 Connection/Stream、TCP/IP 的端口复用是同一思想:把昂贵的内核级资源(socket、文件描述符)收敛到少量物理连接上,用轻量的协议级逻辑单元承载并发。理解这一点可以解释为什么 RabbitMQ 官方 Java 客户端中 Connection 是线程安全的而 Channel 不是——复用层做全局协调,逻辑层为性能放弃锁。
📚 延伸阅读:RabbitMQ Connections 官方文档
⚠️ 常见误区
详情
常见误区:
- ❌ “每次发消息都新建一个 Connection,用完就关” → 错误。TCP 建连 + AMQP 握手开销大,且 Broker 对连接数敏感,必须长连接复用,频繁建连是 RabbitMQ 客户端最常见的性能反模式。
- ❌ “多个线程共享一个 Channel 加锁就行” → 不推荐。即使加锁保证正确性,串行化也抹掉了并发收益,且 Channel 异常会波及所有线程;正确做法是每线程独占 Channel。
- ❌ “Channel 和 Connection 一样重,都要池化” → 不准确。需要池化(或缓存)的主要是 Connection;Channel 创建成本低,按需创建、用完关闭即可,Spring AMQP 中也是缓存 Connection、按需创建 Channel。
🔀 发散问题
- Channel 为什么不是线程安全的?
Channel 内部维护发布序号、未确认消息表等有状态结构,多线程并发写入会破坏帧的完整性与序号连续性。官方客户端选择不在 Channel 内加锁,把并发控制权交给使用者(每线程一个 Channel),以换取单线程场景下的极致性能。 - Spring AMQP 中如何配置连接与 Channel 的缓存?
CachingConnectionFactory默认缓存 Connection 并按需缓存 Channel,可通过connectionCacheSize、channelCacheSize调整缓存规模;当 Channel 缓存不够时会频繁开关 Channel,可观察channelCacheSize命中率来调优。 - 消息的发布与消费分别在什么层完成?
见本文档『RabbitMQ 如何通过交换机与绑定实现消息路由?』:发布走 Exchange 路由,消费走 Queue 订阅,二者都以 Channel 为操作入口。
RabbitMQ 存储
【中等】RabbitMQ 如何声明队列并配置持久化、容量与消息过期策略?⭐⭐⭐
🎯 目标等级:L2-L3 | ⏱ 建议用时:15 min | 🏷 标签:RabbitMQ / 队列声明与存储策略
💎 关键结论
用 queueDeclare 定义队列身份与生命周期,用 arguments 或策略限制容量和消息存活时间。durable 只保队列元数据;消息持久化、副本和确认要分别配置,不能把一个开关当成完整可靠性方案。
⚡ 记忆卡片
- 口诀:名称三布尔加参数,持久不等于副本;容量看 ready,双 TTL 取小
- 关键词:queueDeclare / durable / exclusive / autoDelete / x-max-length / x-message-ttl / expiration
- 链路:声明并校验属性 → 消息按持久化与副本策略存储 → 容量或 TTL 触发清理 → 按 overflow 与 DLX 配置处理
📖 核心知识
声明的五个参数:Java 使用
queueDeclare(queue, durable, exclusive, autoDelete, arguments);不存在则创建,已存在则检查等价性。参数 含义与边界 queuevhost 内的队列名称;空串由 Broker 生成名称,须使用返回值获取实际名称 durable是否保存队列元数据,使队列定义可在重启后恢复;不是消息持久化开关 exclusive是否只允许声明它的连接使用;绑定的是 Connection 而非 Channel,该连接关闭后删除 autoDelete曾有消费者的队列,在最后一个消费者取消订阅或断开后删除;从未有消费者时不能依赖它清理 arguments可选扩展,如队列类型、容量、消息 TTL、DLX 等;无扩展可传 null声明校验与生命周期:同名队列的 durable、exclusive、autoDelete 或需等价检查的参数冲突,会产生
PRECONDITION_FAILED并关闭 Channel,而不是覆盖存量定义。支持动态调整的属性优先用 Policy;不可变属性需新建队列迁移,直接删除重建会丢失存量消息。独占临时队列适合 RPC 回调,不能靠durable=true抵消其连接关闭即删除的语义。分开理解元数据、消息与副本:
durable=true保存队列定义;经典队列中的消息需deliveryMode=2才请求持久化,并等待 Publisher Confirm 确认对应持久化条件。队列副本另由队列类型决定,durable 的经典队列仍可只有单副本;非持久化队列不能在重启后恢复,但不等于其消息从不写盘。容量限制的是待投递消息:
x-max-length限制 ready 条数,x-max-length-bytes限制 ready 消息体总字节数,两者同时设置时任一触顶均生效;unacked 不计入,消息属性、头部和存储开销也不计入字节上限。可通过客户端 arguments、管理界面或rabbitmqctlPolicy 配置。x-overflow达到容量限制后的行为 drop-head(默认)淘汰队首最旧的待投递消息;配置 DLX 时可转死信,否则丢弃 reject-publish拒绝新消息;启用 Publisher Confirm 后用 Nack 告知发布方 reject-publish-dlx拒绝新消息并尝试转 DLX;并非所有队列类型支持,Quorum 不支持此值 消息 TTL 与队列过期分开配置:
x-message-ttl是该队列内所有消息的 TTL,数值单位为毫秒;单条消息用字符串属性expiration表示毫秒,二者同时设置取较小值。过期消息不会再正常投递,但清理、死信转发未必准点;已交给消费者的 unacked 消息不靠消息 TTL 撤回。x-expires则表示队列闲置多久后删除整个队列,不是消息 TTL。
案例:声明持久化队列并配置容量和双 TTL(Java)
import com.rabbitmq.client.AMQP;
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.Connection;
import com.rabbitmq.client.ConnectionFactory;
import java.nio.charset.StandardCharsets;
import java.util.HashMap;
import java.util.Map;

public class DeclareQueueExample {
    public static void main(String[] args) throws Exception {
        ConnectionFactory factory = new ConnectionFactory();
        factory.setHost("localhost");
        try (Connection connection = factory.newConnection();
             Channel channel = connection.createChannel()) {
            String queueName = "order_queue";
            boolean durable = true;
            boolean exclusive = false;
            boolean autoDelete = false;
            Map<String, Object> arguments = new HashMap<>();
            arguments.put("x-queue-type", "classic");
            arguments.put("x-max-length", 1000);
            arguments.put("x-max-length-bytes", 10 * 1024 * 1024);
            arguments.put("x-overflow", "reject-publish");
            arguments.put("x-message-ttl", 60000);
            channel.queueDeclare(queueName, durable, exclusive, autoDelete, arguments);

            channel.confirmSelect();
            AMQP.BasicProperties props = new AMQP.BasicProperties.Builder()
                .deliveryMode(2)
                .expiration("30000") // 队列 60 秒、单消息 30 秒,实际取 30 秒
                .build();
            channel.basicPublish("", queueName, props,
                "Hello, World!".getBytes(StandardCharsets.UTF_8));
            channel.waitForConfirmsOrDie(5000); // 示例同步等待,不替代路由失败监听
        }
    }
}
参数仅为配置演示,不代表生产容量建议;示例不配置 DLX,过期消息会被丢弃。生产者还须按可靠性需求设置 mandatory、处理 Return,相关确认逻辑见本文档『RabbitMQ 如何确认消息并处理未确认投递?』。
案例:容量为 10 的队列与连接独占临时队列(Python/Pika)
import pika

connection = pika.BlockingConnection(pika.ConnectionParameters('localhost'))
try:
    channel = connection.channel()
    channel.queue_declare(
        queue='my_queue',
        durable=True,
        exclusive=False,
        auto_delete=False,
        arguments={'x-max-length': 10},
    )
    # 空名称让 Broker 生成名字;独占队列只允许当前连接使用。
    result = channel.queue_declare(
        queue='', durable=False, exclusive=True, auto_delete=True
    )
    callback_queue = result.method.queue
finally:
    connection.close()  # 独占回调队列随连接关闭删除,my_queue 不会因此删除
my_queue 默认使用 drop-head:第 11 条 ready 消息到达时会淘汰最旧的待投递消息。若已存在同名但属性不同的队列,不能用再次声明强行修改。
🔬 扩展知识
详情
- 【L3】过期不等于精确定时:逐条 TTL 不同会出现队首阻塞,例如 5 秒 TTL 消息排在 60 秒消息后面,可能早已过期却要等到队首才被移除或死信转发;Quorum 也不能消除这一限制。统一队列 TTL 可避免这种由不同 TTL 顺序造成的阻塞,但不提供精确调度保证;多档延迟可用不同 TTL 队列承载。
- 【L3】容量不是内存预算:ready 上限不限制消费者已取得的消息,也不覆盖元数据开销;还需配合 prefetch、节点内存与磁盘水位。多队列路由时,一个队列拒收导致 Confirm Nack,不代表其他队列没有接收,重发须考虑重复。
- 【L3】闲置队列与动态策略:
x-expires计时要求队列没有消费者,且在期限内没有重新声明或调用basic.get;删除整个队列不会把其中消息逐条转 DLX。可变 TTL、容量、DLX 优先用 Policy 管理,避免将可运营参数全部硬编码为声明属性;策略不能改变队列类型等不可变属性。 - 【L4】Lazy 的历史边界:旧版经典队列的
x-queue-mode=lazy让消息更积极地写盘以减少内存驻留,但并不保证任意积压下不告警,也不意味着每条消费都必读盘。RabbitMQ 3.12 起不再支持单独的 Lazy 模式,该参数被忽略;经典队列已采用类似的磁盘优先行为,不应继续将开启 Lazy 当成新版调优建议。 - 【L4】Quorum 的持久化约束:3.8 引入的仲裁队列必须声明为 durable、非独占,消息按其存储模型持久化并复制;不能用
deliveryMode=1把它变成纯内存队列。多数派确认解决副本一致性,不代表能抵御多数副本永久损毁、误删或错误的业务处理。 - 【L4】持久化不等于同步刷盘:经典队列的持久化消息先写入内存页,再异步批量落盘;小于
queue_index_embed_msgs_below(默认 4096 字节)的消息直接嵌入队列索引文件,省去一次独立 IO。「持久化」只描述存储路径与意图,生产者要确认消息真正安全,仍须依赖 Publisher Confirm——对持久化队列中的持久化消息,Confirm 会等到消息落盘(Quorum 则是多数派复制)后才发出,不能假设每条消息写入时都同步执行了 fsync。
📚 延伸阅读:Queue Length、TTL、Lazy Queues
⚠️ 常见误区
详情
常见误区:
- ❌ "durable 会把所有消息持久化并复制,非 durable 就纯内存" → 元数据恢复、消息持久化和副本是三个维度,不能由 durable 推导物理存储位置或绝不丢失。
- ❌ "exclusive 只限制当前 Channel,autoDelete 在队列变空时生效" → exclusive 属于连接;autoDelete 看曾有消费者后的最后一次取消订阅,不看消息数量。
- ❌ "队列上限包含 unacked,TTL 到期就立刻清空" → 容量统计 ready;消息过期后的物理清理存在队首等时机限制,TTL 也不是消费处理超时。
- ❌ "任何 overflow 都会把消息送进死信队列" → 要区分淘汰旧消息和拒绝新消息,且需有效 DLX 配置;
reject-publish不会自动死信新消息,Quorum 不支持reject-publish-dlx。
🔀 发散问题
Q:非持久化队列还有什么用途?
→ 用于允许随连接或节点生命周期丢弃的临时订阅、监控快照缓冲和测试通道,RPC 回调常使用独占队列。选择依据是生命周期与可丢弃性,不是保证纯内存或固定性能优势。
Q:持久化队列中的消息一定不会丢吗?
→ 不一定,还取决于消息属性、发布确认、副本和消费确认;经典持久化消息的 Confirm 同样有持久化语义,并非只有 Quorum 才能等待落盘。详见《MQ面试》『Kafka、RocketMQ、RabbitMQ 如何存储数据与持久化?』及『如何保证 MQ 消息不丢失?』。
Q:被容量策略淘汰或 TTL 清理的消息如何留痕?
→ 配置 DLX 并保证其可路由到实际队列,才能进行审计、补偿或重试;未配置时不能指望事后找回。见《MQ面试》『什么是死信队列?各 MQ 如何实现死信处理机制?』。
Q:TTL 能实现延迟消息吗?
→ 可以用不挂消费者的 TTL 中转队列,过期后经 DLX 投递到业务队列,但须接受队首及转发时机的影响。见《MQ面试》『MQ 如何实现延迟消息?』;积压与节点水位的治理另见《MQ面试》『如何处理 MQ 消息积压?』。
【中等】什么是 RabbitMQ 中的虚拟主机(vhost)?有什么作用?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:10 min | 🏷 标签:RabbitMQ / 资源隔离
💎 关键结论
vhost 是 RabbitMQ 内部的「命名空间」,每个 vhost 拥有独立的交换机、队列、绑定与权限,用于在同一 Broker 上隔离多个应用或租户。理由是资源隔离 + 权限边界都在 vhost 这一层实现,比逐队列授权简单得多。
⚡ 记忆卡片
- 口诀:vhost 即命名空间,资源隔离权限分,默认根号
/ - 关键词:vhost / 资源隔离 / 权限控制 / 多租户 / 默认
/ - 链路:创建 vhost → 在其中声明交换机/队列/绑定 → 按 vhost 粒度授权用户 → 不同 vhost 资源互不可见
📖 核心知识
RabbitMQ 中的虚拟主机(vhost)是逻辑上的隔离概念,用于隔离不同应用或租户。每个虚拟主机可拥有独立的队列、交换器、绑定、权限等资源,多个独立应用可共存于一台 RabbitMQ 服务器且互不影响,可看作 RabbitMQ 内部的 “命名空间”。
- 资源隔离:不同 vhost 有自己的交换器(exchange)、队列(queue)和绑定(binding),资源在不同 vhost 中互不干扰。
- 安全控制:通过对 vhost 的不同用户角色进行权限管理,细化资源访问控制。
- 管理便捷:使多租户应用管理更便捷,可在同一个 RabbitMQ 实例上运行多个独立应用。
🔬 扩展知识
【L3】权限模型:三元正则
详情
RabbitMQ 的授权以 vhost 为边界,每个用户在每个 vhost 上配置三个正则:configure(可声明/删除哪些资源)、write(可发布到哪些资源)、read(可消费/绑定哪些资源)。这种「vhost + 三元正则」模型使权限管理粒度既足够细,又不必逐队列配置。默认存在 vhost /,guest 用户仅能本地访问。
【L4】vhost 的运维边界
详情
vhost 是逻辑隔离而非物理隔离:所有 vhost 共享同一 Broker 的内存、磁盘与连接资源,一个 vhost 的队列积压触发内存水位后仍会阻塞整个节点的所有 vhost。因此核心业务不仅要分 vhost,还应结合节点级隔离(独立集群或独立节点)来划故障域。
📚 延伸阅读:RabbitMQ Virtual Hosts 官方文档
🔀 发散问题
- vhost 和 Kafka 的 Topic 前缀隔离有什么本质区别?
vhost 是协议级强隔离(跨 vhost 无法寻址),Kafka 的前缀只是命名约定、无权限强制力;前者适合多租户,后者只是组织手段。 - vhost 数量有上限吗?
协议上无硬性上限,但每个 vhost 都有元数据与管理开销,实际受节点内存限制,生产上一般以个位数到十几个为宜,更多隔离需求应拆集群。
RabbitMQ 生产消费
【中等】RabbitMQ 如何通过交换机与绑定实现消息路由?⭐⭐⭐
🎯 目标等级:L2-L3 | ⏱ 建议用时:12 min | 🏷 标签:RabbitMQ / 交换机与消息路由
💎 关键结论
消息先到交换机,再按类型和绑定分发到队列:Direct 精确、Fanout 广播、Topic 通配、Headers 看消息头。交换机负责分发,队列负责存储,发送方因此不用管理每个订阅者。
⚡ 记忆卡片
- 口诀:直连精确、扇出广播、主题通配、消息头比条件,路由绑定二五五
- 关键词:Exchange / Binding / Routing Key / Binding Key / x-match / 255 字节
- 链路:生产者发布到交换机 → 按类型检查绑定规则 → 命中一个或多个队列 → 未命中由 AE 或 mandatory 处理
📖 核心知识
路由与存储分工:生产者指定 Exchange 和 Routing Key;Binding 关联交换机与队列,并携带 Binding Key 或消息头条件。交换机不存储业务消息,命中的各队列独立保存投递状态、独立消费;交换机持久化只保存其定义。
四种交换机按匹配语义选型:
类型 路由规则 Routing Key 是否参与匹配 适用场景 Direct Routing Key 与 Binding Key 完全相等;同一 key 可绑定多个队列 是 精确分类、日志分级 Fanout 广播到全部绑定队列 否,可传空串 事件通知、多服务订阅 Topic 按 .分词,用绑定中的*、#匹配是 订单事件等多维度分类 Headers 比较绑定指定的消息头键值; x-match=all为全部匹配,any为任一匹配否 不适合编码进路由键的多属性条件 Topic 的通配符有明确边界:
*恰好匹配一个词,不能匹配零个或跨越多个词;#匹配零个或多个词。通配规则在 Binding Key 中,不能把 Routing Key 当成正则表达式。长度按字节而非字符计:AMQP 0-9-1 的 Routing Key、Binding Key 都是 short-string,上限均为 255 字节,超限不能正常编码发送;UTF-8 中文通常占多个字节。命名宜简短且稳定,可用
{服务}.{模块}.{事件},避免堆砌字段和宽泛通配。默认交换机仍是交换机:每个 vhost 都有名为
""的 Direct 交换机。声明队列时 Broker 自动以队列名为 key 建立默认绑定,发布到空名交换机、以队列名为 Routing Key,即可投递到该队列,无须手工绑定。
案例:四种交换机的匹配与边界
Direct:Q1 绑定
error、Q2 绑定info,发布error只进入 Q1;若两个队列都绑定error,两者都会收到。Fanout:Q1、Q2、Q3 均绑定后,一条注册事件可同时交给邮件、短信、积分服务,各自用独立队列消费。
Topic:Q1 绑定
order.*,Q2 绑定order.create.#。order.create命中两者,order.create.success只命中 Q2;order.*不匹配order,但order.#匹配order、order.create和order.create.success。*.order.#可匹配user.order.create。Headers:绑定参数
{"x-match":"all","format":"pdf","type":"report"}要求消息同时具有对应的format、type键值;改为any则满足任一条件即可。默认交换机(Java):
channel.basicPublish("", "queueName", null, body);
🔬 扩展知识
详情
- 【L3】空段与全匹配:
order..create中间的空段也参与分词,可被一个*匹配;单独的#可匹配所有 Routing Key,对绑定它的队列形成近似广播效果。应避免依赖不直观的空段命名,并对路由边界编写匹配测试。 - 【L3】预定义交换机与级联:Broker 提供
amq.direct、amq.fanout、amq.topic、amq.headers。Exchange-to-Exchange Binding 可构建级联拓扑;声明internal=true后,该交换机不接受客户端直接发布,只接受 Broker 内部路由,例如来自上游交换机的消息。 - 【L4】匹配成本不等于整体吞吐:Topic 按词组织匹配结构,复杂通配、过多绑定和过大的投递扇出都会增加开销。Fanout 虽省去 key 匹配,但大量下游队列仍有成本;Headers 的成本依赖条件数和绑定规模,不能固定断言它总是最慢或一律禁用,也不应无条件用 Topic 替代所有类型。
⚠️ 常见误区
详情
常见误区:
- ❌ "默认交换机意味着绕过交换机直接写队列" → 仍走 Direct 路由,只是绑定由 Broker 自动建立。
- ❌ "Direct 就是一对一,Fanout 必须设置有效 key" → Direct 可以命中多个同 key 队列;Fanout 完全忽略 key,发布时可传空串。
- ❌ "
#至少匹配一个词,255 表示 255 个汉字" →#允许零个词;长度限制按编码后的字节计算。 - ❌ "Headers 一定最慢,应全部改成 Topic" → 两者表达的条件不同,应先按语义选型,再按实际绑定规模、消息头和扇出压测。
🔀 发散问题
Q:Direct 和 Topic 能互相替代吗?
→ 不含通配符的 Topic 绑定可以表达精确匹配,但 Direct 不能表达 Topic 的通配订阅。精确分类用 Direct,需要分层事件订阅再用 Topic。
Q:一条消息命中多个队列会怎样?
→ 每个命中队列各有一份独立的逻辑投递,某个队列 ACK 不会确认其他队列中的消息。同一队列被多条匹配绑定命中,不会因此重复入队。
Q:没有匹配队列时消息去哪?
→ 未配置兜底时默认丢弃;AE 可继续路由,最终无法路由且设置
mandatory=true时通过 Return 返回生产者。见本文档『RabbitMQ 中无法路由的消息会去到哪里?』。
【中等】RabbitMQ 中无法路由的消息会去到哪里?⭐⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:10 min | 🏷 标签:RabbitMQ / 可靠投递
💎 关键结论
无法路由的消息默认被 Broker 静默丢弃;设置 mandatory=true 时会通过 basic.return 退回生产者,也可用备用交换机(Alternate Exchange)兜底入队。最隐蔽的丢消息点正是默认丢弃,关键业务必须显式处理。
⚡ 记忆卡片
- 口诀:默认丢弃无感知,mandatory 退回生产者,AE 兜底进备用队列
- 关键词:mandatory / basic.return / ReturnListener / Alternate Exchange / immediate 已废弃
- 链路:消息到达交换机 → 无任何队列匹配 → 未设 mandatory 则丢弃 / 已设则 basic.return 退回 → 或路由到 alternate-exchange 指定的备用队列
📖 核心知识
在 RabbitMQ 中,无法路由的消息(即无法被投递到任何队列的消息)的处理方式取决于消息的 mandatory 属性(RabbitMQ 3.0+ 已弃用 immediate),具体规则如下:
默认情况(未设置 mandatory)
- 消息被直接丢弃(即 “静默丢失”)。
- 生产者无感知:Broker 不会返回任何通知。
设置了 mandatory=true
- 若消息无法路由到任何队列,Broker 会通过
basic.return方法将消息返回给生产者。 - 生产者需监听返回消息,适用于需严格确保消息路由成功的业务(如关键订单通知)。
备用交换机(Alternate Exchange)
- 预先声明一个备用交换机,绑定一个队列(如
unrouted_queue)接收无法路由的消息。 - 逻辑:若消息无法通过
main_exchange路由,则自动转发到my_ae,最终进入unrouted_queue。
关键区别
| 处理方式 | 条件 | 结果 | 适用场景 |
|---|---|---|---|
| 直接丢弃 | 默认情况 | 消息丢失,无通知 | 允许消息丢失的非关键业务 |
| 返回生产者 | mandatory=true | 通过 basic.return 回退消息 | 需严格监控路由失败的场景 |
| 转发到备用交换机 | 配置了 Alternate Exchange | 消息存入备用队列 | 需审计或补偿无法路由的消息 |
最佳实践
- 关键消息:始终设置
mandatory=true并监听basic.return。 - 日志与监控:使用备用交换机收集无法路由的消息,便于排查问题。
- 避免消息丢失:确保交换机和队列的绑定关系正确,或使用 死信队列(DLX) 处理异常消息。
案例:mandatory 退回与备用交换机配置(Java)
channel.basicPublish("exchange", "routingKey",
    new AMQP.BasicProperties.Builder().mandatory(true).build(),
    message.getBytes());

// 添加 ReturnListener 监听返回消息
channel.addReturnListener((replyCode, replyText, exchange, routingKey, properties, body) -> {
    System.out.println("消息未被路由:" + new String(body));
});Map<String, Object> args = new HashMap<>();
args.put("alternate-exchange", "my_ae"); // 指定备用交换机
channel.exchangeDeclare("main_exchange", "direct", false, false, args);
// 声明备用交换机和队列
channel.exchangeDeclare("my_ae", "fanout");
channel.queueDeclare("unrouted_queue", false, false, false, null);
channel.queueBind("unrouted_queue", "my_ae", "");📌 注意:RabbitMQ 3.0 起已弃用并移除
immediate参数。按 AMQP 0-9-1 语义,旧版本中immediate=true要求消息必须能立即投递给消费者,否则同样经basic.return退回生产者(而非静默丢弃);因其语义复杂、性能差且与 Publisher Confirm 时序纠缠,RabbitMQ 不再支持。「静默丢弃」只发生在未设mandatory的无法路由场景。
🔬 扩展知识
【L3】Return 与 Confirm 的时序
详情
开启 Publisher Confirms 且 mandatory=true 时,无法路由的消息会先收到 basic.return、后收到 Confirm Ack(Broker 确实接收了消息,只是没进队列)。因此 Confirm Ack 不代表消息入队,二者必须组合监听才能覆盖「到达」与「路由」两个环节。
【L4】AE 的类型与扇出
详情
Alternate Exchange 可以是任意类型,常用 Fanout 挂一个兜底队列做审计;也可以挂 Topic 交换机按原始 routing key 二次分流。注意 AE 只在「首次路由失败」时生效,AE 自身再路由失败则消息仍会丢弃,可继续级联 AE。
🔀 发散问题
- 无法路由和进入死信队列是一回事吗?
不是。无法路由发生在「入队之前」(交换机找不到队列);死信发生在「入队之后」(被拒绝、过期、队列溢出)。两者触发点与配置参数完全不同。 - mandatory 对性能有影响吗?
很小。只是给 Broker 增加「路由失败时回传」的义务,路由成功路径几乎无额外开销,关键业务建议常开。
【中等】RabbitMQ 如何确认消息并处理未确认投递?⭐⭐⭐⭐
🎯 目标等级:L2-L3 | ⏱ 建议用时:15 min | 🏷 标签:RabbitMQ / 发布确认与消费重投
💎 关键结论
Publisher Confirm 确认发布结果,Consumer ACK 确认消费结果,两者相互独立;Return 补充路由失败通知。手动确认下,断连等情况会让未确认消息重投,所以业务完成后再 ACK,并始终保证幂等。
⚡ 记忆卡片
- 口诀:发布 Confirm、路由 Return、消费 ACK;未确认可重投,业务幂等兜底
- 关键词:Publisher Confirm / mandatory / basicAck / basicNack / deliveryTag / unacked / redelivered
- 链路:开启发布确认并监听 Return → Broker 按存储条件确认 → 手动消费 → 成功 ACK,失败选择重入队或死信 → 断连未确认可再次投递
📖 核心知识
发布确认与消费确认正交:
confirmSelect()开启 Publisher Confirm,Broker 用 Ack/Nack 通知发布结果,不等待消费者处理。对于已路由消息,确认取决于目标队列的接收与持久化条件:持久化经典队列中的持久化消息需落盘,Quorum 需满足多数派复制条件;Consumer ACK 则是消费者向 Broker 释放本次投递的责任。Confirm 不能替代 Return:无匹配队列的消息也可能获得 Confirm Ack;设置
mandatory=true并监听basic.return,才能感知最终无法路由。开启两者时,无法路由消息先 Return、后 Confirm Ack,因此不能只按 Ack 将业务状态标为成功。Confirm 使用方式 实现 权衡 同步单条 每条发送后 waitForConfirms()简单,但等待往返使发送串行化 同步批量 发送一批后统一等待 减少等待次数,失败后要辨别或重试一批 异步 addConfirmListener()回调可维持在途窗口,吞吐较好,但需维护未确认集合 三种方式的协议确认语义相同,不能简单按同步或异步给可靠性排名;差别在吞吐、状态管理和失败处理。
消费确认决定何时删除:
autoAck=true不等业务完成,发送后即视为成功,消费者崩溃可能造成消息丢失;可靠消费用autoAck=false,业务副作用成功提交后再确认。方法 参数 行为 basicAckdeliveryTag, multiple确认单条,或批量确认不大于该 tag 的未确认投递 basicNackdeliveryTag, multiple, requeue拒绝单条或批量投递; requeue=true重入队,false 尝试死信或丢弃basicRejectdeliveryTag, requeue仅拒绝单条,重入队选择同上 deliveryTag 是 Channel 级标识:Consumer ACK 必须在接收消息的同一 Channel 上发送;跨 Channel、重复确认或确认未知 tag 会导致通道异常。
multiple=true覆盖该通道截至指定 tag 的所有未确认投递,不只是某个业务批次;Publisher Confirm 的发布序号与消费投递 tag 也不是同一套业务编号。unacked 的归宿与超时:未 ACK 时消息暂归该消费者持有;Broker 检测到 Connection/Channel 关闭后,会将仍可恢复的未确认消息重入队,投递给可用消费者,不保证一定换人。支持消费确认超时的版本与队列类型中,Broker 超时会以
PRECONDITION_FAILED关闭 Channel,并重入队该通道的未确认投递,而不是直接当作消费成功删除。重投带redelivered=true,其 deliveryTag 属于新的投递上下文,不能当作稳定幂等键。
案例:先注册 Confirm 与 Return,再发布(Java)
channel.confirmSelect();
channel.addConfirmListener(
    (publishSeqNo, multiple) -> {
        // 生产实现:清理单条或截至该序号的未确认记录。
        System.out.println("Ack: " + publishSeqNo + ", multiple=" + multiple);
    },
    (publishSeqNo, multiple) -> {
        // 生产实现:将相关记录交给受限重试任务,避免回调中阻塞重发。
        System.out.println("Nack: " + publishSeqNo + ", multiple=" + multiple);
    }
);
channel.addReturnListener((replyCode, replyText, returnedExchange,
    returnedRoutingKey, properties, returnedBody) -> {
    // 用 messageId 关联业务失败状态,后续 Confirm Ack 不应覆盖它。
    System.out.println("Returned: " + properties.getMessageId());
});
AMQP.BasicProperties props = new AMQP.BasicProperties.Builder()
    .deliveryMode(2)
    .messageId(java.util.UUID.randomUUID().toString())
    .build();
// mandatory 是 basicPublish 的布尔参数,不属于 BasicProperties。
channel.basicPublish(exchange, routingKey, true, props,
    body.getBytes(java.nio.charset.StandardCharsets.UTF_8));
这是监听接口示例,不是完整重试器;实际发布前需登记消息与发布序号,记录 Return、超时及重试状态。重试同一业务消息时应复用稳定的业务幂等标识,不能每次重新生成身份。
🔬 扩展知识
详情
- 【L3】异步确认的未确认集合:发布前取得
getNextPublishSeqNo(),用有序集合(如ConcurrentSkipListMap)保存消息;回调multiple=true时清理所有不大于该序号的记录。连接中断或等待超时只说明结果未知,不等于 Broker 未收到;受限重发要与消费端幂等配合,重连后也不能把旧 Channel 序号直接用于新通道。 - 【L3】消费确认超时不是消息 TTL:Broker 的
consumer_timeout默认通常为 30 分钟,按周期检查,并非精确到期;可用配置及支持版本的每队列 Policy/x-consumer-timeout调整。RabbitMQ 4.3 起该超时能力仅支持 Quorum 队列,应按实际版本和队列类型核对,既不能宣称 unacked 永不超时,也不能给所有队列套同一个保证。处理时间应留余量,不能只靠 Spring 消费线程超时替代 Broker 机制。 - 【L3】basicRecover 的适用边界:
basicRecover(true)是 AMQP 0-9-1 的 Channel 级全量重投请求,不能指定单条;RabbitMQ 不支持requeue=false的恢复语义。它常见于旧客户端示例,使用前应核对客户端、Broker 版本与队列类型支持,不能把经典队列示例无条件套到 Quorum 或 Stream;不要与客户端连接自动恢复混为一谈。支持环境中可用于消费逻辑重置、下游依赖恢复后的全量重投,但应避免反复调用造成风暴;逐条失败优先用 Nack/Reject,通道失效则重建连接和消费者。 - 【L4】毒消息与版本化投递计数:经典队列没有仲裁队列式的内建 delivery-limit,应自行计数、退避并转最终失败队列。Quorum 可配置
x-delivery-limit或delivery-limitPolicy,超过限制后丢弃或转 DLX;4.0 起默认限制为 20。4.3 起改按delivery-count而非acquired-count判限,主动重入队与失败重投的计数语义须按版本核验,不能把任意一次 Nack 都当成必然增加一次失败计数。 - 【L4】幂等不能只在 redelivered 为 true 时启用:该标记提示 Broker 重投,不能证明业务一定执行过;生产者因 Confirm 丢失而重发,也可能作为新的投递进入队列。应按消息 ID 或业务唯一键去重,令副作用与去重记录在一致的事务边界中提交,再 ACK。
📚 延伸阅读:Publisher Confirms、Consumers 与确认超时、AMQP 0-9-1 支持边界、Quorum Queues 与投递限制
⚠️ 常见误区
详情
常见误区:
- ❌ "Confirm Ack 就代表已入队、已消费、绝不会丢" → Confirm 不等于路由成功或业务完成;还需 Return、正确的存储副本策略和消费确认。完整方案见《MQ面试》『如何保证 MQ 消息不丢失?』。
- ❌ "autoAck 只是替我在业务成功后 ACK" → Broker 不知道业务是否完成,自动确认会放弃对失败消费的恢复保障。
- ❌ "unacked 永远不会超时,也可以拿 deliveryTag 永久去重" → 支持消费确认超时的配置会关闭通道并重投;tag 只在所属 Channel 的投递上下文中有效,跨通道可以重复数值。
- ❌ "Nack 和 Reject 完全相同,批量 Nack 不影响已成功业务" → Reject 只拒绝单条;批量 Nack 会覆盖范围内仍未确认的投递,可能把已完成业务但尚未 ACK 的消息一起重投。
- ❌ "没收到 ACK 就立即无限 requeue" → 未确认不代表处理失败,无限重试会形成毒消息循环和资源风暴,应采用幂等、退避、次数上限与最终失败处理。
🔀 发散问题
Q:为什么异步 Confirm 通常比逐条同步快?
→ 逐条同步把每次网络往返串行化,异步则允许多条在途消息并处理批量确认。实际收益取决于网络、磁盘、队列类型与窗口大小,不能套固定吞吐倍数。
Q:消费者很慢但连接正常,如何处理?
→ 先检查 unacked、业务耗时和 prefetch,避免取入超过处理能力的消息;再按版本配置合理的 Broker 确认超时,并为应用失败设计有界重试。见本文档『RabbitMQ 的 prefetch_count 有什么作用?如何设置?』。
Q:断连后重投会不会重复扣款?
→ 如果业务已成功而 ACK 丢失,就可能再次收到同一业务消息,必须用订单号、请求号等稳定标识幂等处理。见《MQ面试》『如何保证 MQ 消息不重复?』。
Q:拒绝且不重入队的消息去哪?
→ 配置了有效 DLX 时可转死信,否则会丢弃;毒消息达到重试上限也应进入可审计的最终失败路径。见《MQ面试》『什么是死信队列?各 MQ 如何实现死信处理机制?』。
【中等】RabbitMQ 如何实现消息的批量消费?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:10 min | 🏷 标签:RabbitMQ / 消费模式
💎 关键结论
RabbitMQ 协议层不支持服务端批量推送,批量消费靠客户端实现:Prefetch 预取 + 手动确认,攒够一批后统一处理、统一 ACK。核心前提是业务幂等,否则批量重投会造成重复。
⚡ 记忆卡片
- 口诀:预取攒批、手动确认、批量入库、幂等保底
- 关键词:basicQos / prefetchCount / 手动确认 / 批量 ACK / 幂等
- 链路:basicQos 设置预取数 → 消息暂存客户端缓冲 → 达到批量阈值或超时 → 批量执行业务(如批量入库)→ 批量 basicAck
📖 核心知识
RabbitMQ 协议本身不支持服务端批量推送,但可通过客户端机制模拟批量消费。核心是:开启手动确认,积攒消息,统一处理后再确认。
首选方法:Prefetch(预取) + 手动确认
- 设置预取数量:使用
channel.basicQos(prefetchCount),限制信道上可持有的最大未确认消息数。 - 开启手动确认:消费消息时,不自动确认,由业务逻辑控制。
- 缓存与批量处理:
- 将收到的消息暂存到内存(如列表)。
- 当积攒数量达到
prefetchCount或等待超时时,执行批量业务逻辑(如批量入库)。
- 统一确认:批量处理成功后,对该批所有消息进行手动确认。
优点:实现简单、能进行流量控制、显著提高吞吐量。
关键:业务逻辑必须支持幂等性,以防重复消费。
备选方法:主动拉取
使用 channel.basicGet() 在循环中主动从队列拉取消息,凑够一批后处理和确认。优点:控制更精确。缺点:实现复杂,空队列时效率低。不推荐为首选。
总结建议
- 绝大多数场景下,应使用 Prefetch + 手动确认的方案。
- 牢记幂等性是保证数据准确性的前提。
- 根据业务处理能力和内存情况,合理设置
prefetchCount大小。
🔬 扩展知识
【L3】批量 ACK 的 multiple 语义与失败放大
详情
basicAck(deliveryTag, multiple=true) 可一次确认 ≤ 该 tag 的所有消息,大幅减少 ACK 往返;但批内任一条处理失败时,若整批 Nack(requeue=true) 会导致已成功的消息也被重投,因此批量消费必须幂等,且建议「成功的单条 Ack、失败的单条 Nack 转死信」的细粒度策略。
【L4】prefetch 与批量大小的匹配
详情
预取值应 ≥ 批量大小,否则管道内消息不够一批,批量效果打折;但 prefetch 过大会把大量未确认消息压在单个消费者内存里,宕机时整批 requeue 造成重复与抖动。经验上是「prefetch = 批量大小 × 1~2」并结合单条消息体积评估内存占用。
🔀 发散问题
- 为什么不用 basicGet 做批量拉取?
basicGet 每次只能取一条且空队列时空转,效率低、还拿不到 QoS 保护;仅在需要精确控制拉取节奏的离线批处理中偶尔使用。 - 批量入库失败怎么处理最稳?
先按单条幂等插入(或带唯一索引的批量插入),成功的单独 Ack,失败的单条 Nack(requeue=false) 转死信,避免整批反复重投。 - 发送端怎么攒批提速?
与消费端攒批对应,发送端把多条消息打包成一次网络请求,见《RocketMQ面试》『RocketMQ 如何实现批量消息?』。
【中等】RabbitMQ 有哪些工作模式?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:10 min | 🏷 标签:RabbitMQ / 消费模式
💎 关键结论
RabbitMQ 的工作模式本质是「拓扑组合」:简单、工作队列、发布订阅、路由、主题、RPC 六种,差别只在交换机类型与消费者数量。抓住「用哪类交换机 + 几个消费者」就能推导出任何模式。
⚡ 记忆卡片
- 口诀:单发单收是简单,多消竞争工作队,Fanout 广播、Direct 路由、Topic 通配、RPC 回调
- 关键词:Simple / Work Queue / Publish-Subscribe / Routing / Topic / RPC / reply_to / correlation_id
- 链路:生产者 → (交换机类型决定分发方式)→ 队列 → (单消费/竞争/广播)→ 消费者;RPC 额外用 reply_to + correlation_id 闭环
📖 核心知识
RabbitMQ 有以下几种主要的工作模式:
- 简单模式(Simple)
- 工作队列模式(Work Queue)
- 发布/订阅模式(Publish/Subscribe)
- 路由模式(Routing)
- 主题模式(Topic)
- RPC 模式(远程调用)
以下,对几种工作模式逐一进行说明:
简单模式(Simple)
- 角色:1 生产者 → 1 队列 → 1 消费者
- 特点:单向通信,无路由逻辑,即点对点模式
- 场景:单任务处理(如日志记录)
工作队列模式(Work Queue)
- 角色:1 生产者 → 1 队列 → 多个消费者竞争消费
- 特点:
- 消息轮询分发(默认)或公平分发(需设置
prefetch=1) - 消费者并行处理
- 消息轮询分发(默认)或公平分发(需设置
- 场景:任务分发(如订单处理)
发布/订阅模式(Publish/Subscribe)
- 角色:1 生产者 → Fanout 交换机 → 绑定多个队列 → 多个消费者
- 特点:
- 消息广播到所有队列
- 消费者各自独立接收全量消息
- 场景:事件通知(如系统公告)
路由模式(Routing)
- 角色:1 生产者 → Direct 交换机 → 根据
routing_key路由到特定队列 - 特点:
- 精确匹配路由键
- 支持多队列绑定相同路由键
- 场景:条件过滤(如错误日志分级处理)
主题模式(Topic)
- 角色:1 生产者 → Topic 交换机 → 基于通配符(
*/#)匹配路由键 - 特点:
- 模糊匹配(如
order.*匹配order.create) - 灵活性高
- 模糊匹配(如
- 场景:复杂路由(如多维度消息分类)
RPC 模式(远程调用)
- 角色:客户端 → 请求队列 → 服务端 → 响应队列 → 客户端
- 特点:
- 通过
reply_to和correlation_id关联请求/响应 - 同步阻塞式通信
- 通过
- 场景:服务间调用(需即时响应)
模式对比
| 模式 | 交换机类型 | 路由规则 | 典型应用 |
|---|---|---|---|
| 简单模式 | 无 | 无 | 单任务处理 |
| 工作队列 | 无 | 轮询/公平分发 | 并行任务 |
| 发布/订阅 | Fanout | 广播 | 多系统通知 |
| 路由模式 | Direct | 精确匹配routing_key | 条件过滤 |
| 主题模式 | Topic | 通配符匹配 | 复杂路由 |
| RPC 模式 | 无 | 请求-响应关联 | 同步服务调用 |
选择建议
- 广播需求 → Fanout
- 条件过滤 → Direct/Topic
- 任务并行 → Work Queue
- 服务调用 → RPC
🔬 扩展知识
【L3】工作队列的公平分发细节
详情
默认轮询分发按消息数均分,不考虑消费者处理速度,会造成快消费者空闲、慢消费者积压;设置 basicQos(prefetchCount=1) 后 Broker 只在消费者确认后才发下一条,实现「能者多劳」的公平分发——这也是 prefetch 作为流控与分发双重作用的典型体现。
【L4】RPC 模式的超时与孤儿响应
详情
RPC 模式用 exclusive 临时队列接收响应,靠 correlation_id 匹配;客户端必须设超时,否则服务端崩溃会导致永久阻塞;服务端响应发布失败时客户端也只能靠超时兜底。正因这些脆弱性,生产环境的同步调用更推荐专门的 RPC 框架(如 Dubbo/gRPC)而非 MQ 自建。
🔀 发散问题
- 工作队列模式和工作队列(竞争消费)是一回事吗?
是同一概念的不同叫法:一个队列挂多个消费者竞争消费,消息只会被其中一个处理,与发布订阅的「每人都收全量」形成对照。 - 发布订阅模式下各消费者的消费进度互相影响吗?
不影响。每个消费者绑定自己的独立队列,各自维护 offset/ACK,一个消费者积压不会拖慢其他消费者。
RabbitMQ 集群
【困难】RabbitMQ 集群与队列高可用如何设计和配置?⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:RabbitMQ / 集群与队列高可用
💎 关键结论
集群共享元数据,不会自动复制每条消息。可靠业务通常用多节点集群加 Quorum 队列,再配接入故障转移和客户端恢复;跨地域转发另用 Federation 或 Shovel,不能把它们当作同一套队列副本。
⚡ 记忆卡片
- 口诀:集群管元数据,仲裁管副本;多数派才能写,接入恢复另安排
- 关键词:Erlang Cookie / Quorum / Raft / 多数派 / LB / Policy / Federation / Shovel / Sharding
- 链路:节点认证组集群 → 分散队列副本故障域 → 多数派复制确认 → 故障后选主与客户端重连 → 跨集群按需异步转发
📖 核心知识
集群与队列复制不是一个层次:集群共享队列、交换机、绑定等元数据,客户端通常可接入任一可用节点,由其转发到队列所在节点或 leader;跨节点访问有网络成本。普通经典队列没有消息副本,所在节点不可用时该队列仍会不可用,不能把「多入口」理解成「所有队列都有冗余」。
现代高可用队列优先用 Quorum:多副本以 Raft 复制,依赖队列副本成员的多数派提交与选主;失去多数派时停止提供正常队列服务,不能让少数派单独继续写入。建议将至少 3 个副本分散到独立故障域,但必须核查实际副本成员,集群有 3 个节点不等于每个队列已有 3 副本。
维度 普通经典队列 经典镜像队列(历史) Quorum 队列 消息复制 单副本 按 Policy 配置 leader 与 mirrors 基于 Raft 的副本组 配置入口 普通队列声明 ha-mode等旧策略x-queue-type=quorum故障边界 所在节点故障影响队列 受副本同步状态、提升策略与分区影响 须多数派可用;不能抵御多数副本永久损毁等灾难 版本定位 非复制型队列 2021 年弃用,4.0 移除 3.8 引入,现代复制型队列方案 接入层和客户端也要恢复:用 LB 健康检查屏蔽故障节点,或为客户端提供多节点地址;结合心跳、断连检测、退避重连和拓扑/消费者恢复。LB 不会把已有 TCP 连接无缝搬到另一节点;连接或 Channel 失效后要恢复相应资源,核对未确认发布并幂等重试,不能无限使用旧 Channel。
集群内认证与历史镜像策略分清:同一 RabbitMQ 集群的节点通过一致的 Erlang Cookie 完成节点间认证,还须满足节点名解析、网络连通等条件;Cookie 不是应用的 AMQP 用户密码。历史镜像通过「策略名 + 队列名正则 + 定义」配置,
all复制到全部节点,exactly指定总副本数,nodes指定节点列表;4.0 起这些镜像策略不能再用于创建高可用队列。跨集群转发、分片是可叠加能力,不是四种互斥集群:
能力 职责与边界 Federation( rabbitmq_federation)按交换机或队列进行订阅式跨集群转发,适合多级、多区域拓扑 Shovel( rabbitmq_shovel)在源与目标之间消费并重新发布,适合点对点搬运或迁移 Sharding( rabbitmq_sharding)将逻辑消息流分到多个队列/节点,缓解单队列压力,但不会自动增加消息副本 Federation/Shovel 的两端可以是独立集群,通过 AMQP 凭据、权限及 TLS 等配置连接,不要求共享 Erlang Cookie,也不共享一套元数据或 Raft 多数派。
案例:声明 3 副本 Quorum 队列(Java)
Map<String, Object> arguments = new HashMap<>();
arguments.put("x-queue-type", "quorum");
arguments.put("x-quorum-initial-group-size", 3);
channel.queueDeclare("orders.quorum", true, false, false, arguments);
x-quorum-initial-group-size 是初始副本组大小,不是 x-quorum-queue。需已有足够的可用集群节点,并核查实际成员和健康状态;新增集群节点也不代表已有队列自动达到期望副本数。可靠发布还要启用 Confirm,消费则使用手动 ACK 与业务幂等。
案例:4.0 之前的经典镜像 Policy,仅供存量维护
# 为重要队列设置共 2 个副本,即 1 个 leader + 1 个 mirror
rabbitmqctl set_policy ha-important "^important\." '{"ha-mode":"exactly", "ha-params":2}'

# 为 ha. 前缀队列复制到全部集群节点,副本开销随集群扩大
rabbitmqctl set_policy ha-all "^ha\." '{"ha-mode":"all"}'
旧版也可在管理界面 Admin → Policies 配置。用 important.、critical. 等命名前缀限制匹配范围,避免不必要的全量复制;exactly=2 是历史参数示例,不是现代高可用推荐。只有一个节点时无法产生跨节点冗余。
ha-mode=nodes 配合节点列表控制放置;ha-promote-on-shutdown 控制副本提升条件,不是放置策略。历史 ha-sync-mode 可选手动或自动同步,自动同步可能阻塞队列操作,需安排同步窗口。
🔬 扩展知识
详情
- 【L3】磁盘节点/内存节点属于旧元数据模式:采用 Mnesia 的旧集群可区分 disk 与 RAM 节点,区别主要在元数据驻留方式,不是队列消息是否持久化。RAM 节点重启需要磁盘节点帮助恢复元数据,旧模式至少需要磁盘节点,生产通常采用全磁盘节点,避免单一磁盘节点依赖;不要把这种分类当作现代 Khepri 元数据存储下的通用调优手段。
- 【L3】镜像并非「必定异步、只等主确认」:旧经典镜像队列的 Publisher Confirm 要等待所有当前镜像接受消息,持久化消息还涉及相应的落盘条件。新加入或恢复的镜像可能尚未同步历史内容;若策略允许提升未同步副本,便可能丢失旧消息,而选择仅提升同步副本又可能暂时不可用。应分别讨论实时复制、历史同步与故障提升,不能用一句「异步复制」替代。
- 【L3】分区策略不等于 Raft 多数派:旧式集群的
ignore、pause_minority、autoheal等策略影响节点侧分区处理,不能替代队列复制协议;ignore下的历史镜像可能产生分叉,恢复结果取决于恢复策略,并非必定保留所谓多数派数据。Quorum 的多数派以该队列的副本组为准,少数派不能单独提交新消息,也不能靠强制选主无损恢复。 - 【L4】迁移与版本时间线:3.8 引入 Quorum,不等于同年宣布镜像弃用;镜像于 2021 年弃用,4.0 移除。队列类型不能原地修改,升级前需新建 Quorum、受控停写搬运或有去重保障的双写、切换消费者并核对积压与业务结果,再下线旧队列。管理界面的 definitions 导入导出只搬元数据,不会搬走消息体;存量消息需排空或由 Shovel 等搬运。
- 【L4】同城副本与异地转发的取舍:低延迟、稳定网络下可跨同城故障域部署 Quorum,但要计入多数派复制的网络往返;跨广域网通常采用独立集群加 Federation/Shovel。转发重连后可继续处理尚保留的源消息,但两端确认不是跨地域原子提交,仍需定义 RPO、积压与重复处理策略,不能把「联邦」等同自动多活一致性。
- 【L4】复制与分片的成本独立评估:Quorum 的副本数、磁盘能力、消息大小、Confirm 窗口、网络延迟都会影响性能,不能宣称相对镜像固定下降 30%~50%。分片能提高并行度,却改变单队列顺序与积压观测方式;有业务顺序要求时应按业务键稳定路由,副本、幂等和分片级监控仍要另做。
🏭 实战场景
详情
推演:订单队列需要容忍节点故障,不是生产测量数据。 假设各副本分散在独立故障域,节点的网络、磁盘正常,讨论的是单个队列的副本成员:
| 副本数 N | 提交所需多数派 floor(N/2)+1 | 可容忍同时不可用副本数 |
|---|---|---|
| 3 | 2 | 1 |
| 5 | 3 | 2 |
- 3 副本方案:分布于 A/B/C,A 故障后 B/C 仍构成多数派,可在必要的选主和客户端恢复后继续;再损失一个副本便不能继续提供正常队列服务。3 个副本若共用一台宿主机,不能当成可容忍 1 台宿主机故障。
- 分区推演:发生 2:1 网络分区时,只有含 2 个副本的一侧具备提交条件;接在少数派一侧的客户端必须切换到可用入口。5 副本的 3:2 分区同理,不能让两边同时对同一队列独立确认写入。
- 需求升级:若要求同时容忍 2 个独立副本故障,可评估 5 副本,但复制、磁盘和网络成本增加;单纯把集群扩成 5 节点、不扩队列副本组,仍只有原来的故障容忍能力。
- 验收路径:演练断连接入节点、关闭队列 leader、隔离少数派,记录实际恢复时间、Confirm 延迟、未确认发布及重复消费数量;核对已确认消息与业务处理结果。多数副本永久损毁、误删队列、未确认发布的命运需另有灾备与补偿方案,不能用上述数学推演承诺「绝不丢失」。
⚠️ 常见误区
详情
常见误区:
- ❌ "普通集群会自动把所有消息复制到每个节点" → 集群元数据与队列副本是两层;复制范围由队列类型和实际副本配置决定。
- ❌ "有 LB 就不需要客户端恢复,切主完全无感" → 现有连接可能断开、在途结果可能未知,仍需恢复 Channel、消费者并幂等重试。
- ❌ "3 节点能容忍任意 2 节点故障,Quorum 确认后绝不丢失" → 3 副本需 2 个构成多数派;协议安全保证有故障模型前提,不覆盖误删和多数数据副本永久损毁。
- ❌ "镜像只等主确认、3.8 已弃用,现在仍可作为低延迟首选" → 旧镜像 Confirm 涉及镜像接受与持久化条件;3.8 是 Quorum 引入版本,镜像在 2021 年弃用并于 4.0 移除。
- ❌ "联邦也属于同一个集群,所以必须共用 Cookie" → Federation/Shovel 连接独立 Broker 或集群,使用 AMQP 认证,不要求节点 Cookie 相同。
- ❌ "改 Policy 或导出定义就完成镜像到 Quorum 的消息迁移" → 类型不能原地转换,定义不含消息体,必须设计实际搬运、切流、去重和校验。
🔀 发散问题
Q:普通集群相比单节点还有什么价值?
→ 可以分散连接入口,把不同队列放到不同节点并统一元数据管理,非本地队列访问则需跨节点转发。它扩展的是整体资源与接入,不会自动消除某个单副本队列的故障点。
Q:镜像与 Quorum 可以同时存在吗?
→ 在仍支持镜像的旧版本中,可以有不同类型的队列并存,但同一个队列不能同时采用两套复制机制。迁移期需区分同步状态、确认语义和运维指标,4.0 以后则不能再保留经典镜像功能。
Q:Federation 和 Shovel 怎么选?
→ 多级订阅式拓扑优先评估 Federation,指定源和目的的消息搬运可选 Shovel。两者都要考虑重连、转发确认、源端保留和幂等,不是队列的同步副本替代品。
Q:跨机房高可用只要增加副本吗?
→ 不够,还需验证副本故障域、网络往返、入口健康与客户端恢复;异地独立集群的转发又有自己的 RPO。持久化与发布/消费确认的配合见本文档『RabbitMQ 如何确认消息并处理未确认投递?』。
RabbitMQ 可靠传输
【中等】RabbitMQ 如何实现背压机制?⭐⭐⭐
🎯 目标等级:L2-L3 | ⏱ 建议用时:10 min | 🏷 标签:RabbitMQ / 流量控制
💎 关键结论
RabbitMQ 的背压是一条连锁反应链:消费者 QoS 限流 → Broker 队列积压 → 资源水位触发阻塞生产者连接,把消费端的压力反向传导到生产端。它让系统吞吐由最慢的消费者决定,而非最快的生产者。
⚡ 记忆卡片
- 口诀:QoS 起步,积压传导,水位阻塞生产者
- 关键词:prefetch / unacked / 队列积压 / vm_memory_high_watermark / connection.blocked
- 链路:消费者 prefetch 限制未确认数 → 处理变慢后 Broker 停推新消息 → 队列积压消耗内存/磁盘 → 达阈值后阻塞生产者连接 → 生产者被动降速
📖 核心知识
RabbitMQ 通过一套连锁反应机制实现背压,将消费者的处理压力反向传导至生产者,迫使生产者降速,避免系统被压垮。
背压触发与传导流程
起点:消费者限流
- 机制:消费者设置较小的 QoS 预取值(如
prefetch=1)。 - 效果:当消费者处理变慢,未确认消息数达到上限时,Broker 立即停止向该消费者推送新消息。
- 机制:消费者设置较小的 QoS 预取值(如
中间环节:Broker 积压
- 效果:消息在队列中快速堆积,消耗 Broker 的内存和磁盘资源。
终点:生产者被限速
- 机制:当 Broker 资源(内存/磁盘)达到阈值时,自动阻塞生产者的连接。
- 效果:生产者的发送操作被暂停或变慢,背压成功传导至源头。
关键配置与监控
- 必须使用手动确认模式:这是 QoS 生效的前提。
- 设置小预取值:是启动背压链条的关键(如 1-10)。
- 监控队列长度:队列积压是背压触发的明显信号。
- 监听连接阻塞:生产者通过监听器感知背压,进行日志记录或告警。
核心价值
这套机制确保了系统的吞吐量由最慢的消费者决定,而非由最快的生产者决定,从而优雅地实现了系统自我保护。
一句话总结:通过 消费者 QoS 触发,经 Broker 积压 传导,最终由 Broker 流控 作用于生产者,形成完整的背压闭环。
🔬 扩展知识
【L3】背压信号的观测点
详情
三层背压各有观测手段:消费者层看 unacked 消息数是否长期顶到 prefetch;队列层看 messages_ready 积压量与增长速率;生产者层监听 connection.blocked/unblocked 回调。把三个信号串成告警链,可以在内存水位触发前就发现背压传导。
【L3】完整的四层背压体系
详情
正文的连锁反应是主干,完整的背压其实分四层:
- 消费者侧
prefetch_count(最主要手段):限制单消费者未确认消息数,从源头限制推送速率。 - 节点资源水位阻塞生产者:内存超过
vm_memory_high_watermark(默认为物理内存的 0.4)或磁盘低于disk_free_limit时,Broker 向所有发布连接发送connection.blocked并阻塞发布。这是异步通知,客户端必须注册 BlockedListener/回调处理,否则生产者线程会卡在 socket 写缓冲上「莫名卡死」且无任何报错,这是生产上最难排查的背压症状。 - Credit Flow(Erlang 进程间信用流控):队列进程积压时停止向 Channel 进程发放 credit,Channel 进而反压到 Connection 进程,逐跳限速而不依赖全局水位。
- 队列级上限与溢出策略:
x-max-length/x-max-length-bytes配合x-overflow(drop-head/reject-publish/reject-publish-dlx)在入队口拒收或淘汰,把背压提前到单个队列粒度,避免拖垮整个节点。
【L4】与响应式流背压的对比
详情
RabbitMQ 背压是资源水位驱动的「硬背压」(直接阻塞连接),而 Reactive Streams/Netty 的背压是信用额度驱动的「软背压」(按请求量投递)。前者简单但有全局阻塞副作用,后者精细但需要端到端协议支持;理解差异有助于解释为什么 RabbitMQ 需要配合队列隔离来避免背压互相传染。
📚 延伸阅读:RabbitMQ Flow Control 官方文档
🏭 实战场景
详情
推演案例(数字为示意值,非官方基准或实测数据):订单系统的事件生产者在大促期间发送速率达到 10000 msg/s,而下游消费者(负责写库和发通知)单实例处理能力仅约 700 msg/s,3 个消费者实例合计 2100 msg/s,产消速率差导致队列深度从 0 开始以每秒约 8000 条的速度增长,4 小时内积压到约 1.15 亿条消息,RabbitMQ 节点内存从 2GB 飙升至 8GB 触发 alarm 阈值,所有生产者连接被阻塞(connection.blocked),整个消息系统瘫痪。排查发现队列未配置任何深度限制,且消费者未设置 prefetch_count,单个消费者内存中堆积了数十万条未确认消息。修复措施:为关键队列设置 max-length-bytes=2GB 并配合 overflow=reject-publish,超出限制时消息直接拒绝并返回生产者 nack,防止无限积压;消费者从 3 个实例扩容至 12 个实例,每个消费者设置 prefetch_count=100 防止单消费者内存溢出;同时在生产者侧增加限流,将发送速率限制在消费者可承受的 8000 msg/s 以内,形成完整的背压传导链。
🔀 发散问题
- 背压触发后生产者应该硬重试吗?
不建议。阻塞期间硬重试只会堆积发送线程;应监听 blocked 回调暂停发送、写本地缓冲或降级,unblocked 后限速重放。 - prefetch 设大是不是就绕过背压了?
只是把压力从 Broker 转移到了消费者内存:unacked 消息堆积在客户端,消费者 OOM 后消息整批 requeue,背压问题以更剧烈的形式重现。见本文档『RabbitMQ 的 prefetch_count 有什么作用?如何设置?』。
RabbitMQ 架构
【中等】RabbitMQ 为什么使用 Erlang 语言?有什么优势和劣势?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:10 min | 🏷 标签:RabbitMQ / 架构与语言
💎 关键结论
选 Erlang 是因为它为电信级系统设计:轻量进程 + Actor 模型 + OTP 容错,与消息中间件「高并发、高可靠」的需求天然匹配。代价是语言小众、二开与运维门槛高,且不适合海量堆积场景。
⚡ 记忆卡片
- 口诀:轻量进程百万级,OTP 自愈 let it crash,性能强但生态小
- 关键词:Erlang / 轻量进程 / Actor / OTP / 热升级 / 堆积弱
- 链路:Erlang 轻量进程支撑海量连接 → Actor 消息传递契合 MQ 模型 → OTP Supervisor 自动重启保自愈 → 代价:语言小众、堆积能力弱
📖 核心知识
RabbitMQ 使用 Erlang 语言开发,这是一个由爱立信为电信系统设计的函数式编程语言。这一选择深刻影响了 RabbitMQ 的架构特点和性能表现。
Erlang 的核心特性
| 特性 | 说明 | 对 RabbitMQ 的影响 |
|---|---|---|
| 轻量级进程 | Erlang 的进程极其轻量(约 2KB 栈),单机可创建百万级进程 | RabbitMQ 可为每个连接/信道创建独立进程,隔离性好 |
| Actor 模型 | 进程间通过消息传递通信,无共享内存 | 天然适合消息队列的并发模型 |
| OTP 框架 | 提供 Supervisor 树、GenServer 等成熟模式 | RabbitMQ 具备强大的容错和自愈能力 |
| 抢占式调度 | 调度器按 reduction 计数(每进程约 2000 reductions)强制切换 | 单个慢请求不会阻塞其他请求 |
| 热代码升级 | 支持运行时替换代码 | RabbitMQ 可不停机升级 |
优势
- 高并发:Erlang 的轻量级进程使得 RabbitMQ 在单机上能支持数万并发连接,且延迟低而稳定。
- 高可用与容错:OTP 的 Supervisor 树实现“let it crash”哲学,进程崩溃后自动重启,系统自愈能力强。
- 分布式原生支持:Erlang 内置分布式通信机制,RabbitMQ 集群节点间通信天然高效。
- 低延迟:局域网、小消息场景下消息延迟常见为亚毫秒级,相对以吞吐见长的 Kafka/RocketMQ,RabbitMQ 的差异化优势在低延迟与灵活路由(定性对比,非官方基准)。
劣势
- 学习曲线陡峭:Erlang 是函数式语言,对 Java/Go 背景的工程师不友好,二次开发和深度调优困难。
- 社区规模小:相比 Java/Go,Erlang 开发者少,社区生态有限,问题排查资料少。
- 不适合计算密集型:Erlang 擅长 I/O 密集型场景,但在 CPU 密集型计算上性能不如 Java/Go。
- 堆积能力弱:RabbitMQ 的存储设计不适合海量消息堆积,堆积过多会影响整体性能(与 Erlang 的 GC 机制有关)。
- 运维门槛高:Erlang VM 的调优需要专业知识,普通运维人员难以驾驭。
与其他 MQ 的对比
| 维度 | RabbitMQ (Erlang) | Kafka (Scala/Java) | RocketMQ (Java) |
|---|---|---|---|
| 并发模型 | Actor 模型(轻量进程) | 线程模型 | 线程模型 |
| 延迟 | 微秒级(最低) | 毫秒级 | 毫秒级 |
| 吞吐量 | 万级 | 百万级(最高) | 十万级 |
| 堆积能力 | 弱(万级为佳) | 极强(亿级) | 强(亿级) |
| 二次开发 | 困难(Erlang) | 容易(Java/Scala) | 容易(Java) |
表中延迟/吞吐/堆积的数量级为常见量级示意,非官方基准数据;实际表现取决于消息大小、持久化配置、硬件与网络。Kafka 高吞吐的根因是顺序写 + page cache + 零拷贝(消费走
sendfile,写入是普通write到 page cache),并非 mmap 写消息。
🔬 扩展知识
【L3】let it crash 与队列进程的自愈
详情
RabbitMQ 中每个队列对应一个 Erlang 进程,由 Supervisor 树管理:队列进程异常崩溃时,Supervisor 按策略自动重启并恢复状态(持久化队列从磁盘重建),而不是像线程模型那样让整个服务崩溃。这也是「单队列故障不影响其他队列」隔离性的来源。
【L4】Erlang GC 与延迟的关系
详情
Erlang 采用每进程独立的小堆 + 分代 GC:垃圾回收只停顿单个轻量进程(微秒级),不会出现 JVM 式的全局 STW,这是 RabbitMQ 尾部延迟稳定的重要原因;代价是大量消息驻留内存时(堆积)总内存占用与 GC 压力上升,解释了其堆积能力弱的语言层根因。
🔀 发散问题
- 为什么 RabbitMQ 堆积能力弱也和 Erlang 有关?
消息在 Erlang 进程堆上排队,堆积时内存占用与 GC 压力同步上升;而 Kafka 的页缓存 + 顺序日志把数据交给 OS 管理,语言层无此负担。 - 用 Java 重写一个 RabbitMQ 可行吗?
技术上可行(如 Apache Qpid),但要重新解决海量连接的线程模型、全局 GC 停顿与容错框架问题,这正是 Erlang/OTP 数十年沉淀的护城河。
【中等】RabbitMQ 的 prefetch_count 有什么作用?如何设置?⭐⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:10 min | 🏷 标签:RabbitMQ / 流量控制
💎 关键结论
prefetch_count 是消费者限流的核心参数:限制单个消费者未确认消息的最大数量,达到上限后 Broker 停止推送。设置原则:消费快设大(50100)、消费慢设小(110),必须配合手动 ACK 才生效。
⚡ 记忆卡片
- 口诀:预取限未确认,达上限停推,ACK 一条补一条
- 关键词:basicQos / prefetchCount / unacked / 手动 ACK / 公平分发
- 链路:basicQos 设 N → Broker 推送 N 条处于 unacked → 达到 N 后停推 → 消费者 ACK 一条 → Broker 补推一条 → 维持 unacked ≤ N
📖 核心知识
prefetch_count(预取计数)是 RabbitMQ 消费者限流 的核心参数,通过 channel.basicQos() 设置。
核心作用
限制单个 Channel 上未确认(unacked)消息的最大数量。当未确认消息数达到 prefetch_count 时,Broker 停止向该消费者推送新消息,直到消费者确认部分消息后才会继续推送。
工作原理
- 消费者设置
prefetch_count = N。 - Broker 推送 N 条消息给消费者,这些消息处于
unacked状态。 - 消费者处理完一条消息,调用
basicAck(),Broker 感知后再推送一条新消息。 - 始终保持
unacked消息数 ≤ N。
prefetch_count 取值的影响
| 取值 | 行为 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 未设置(0) | 无限制,Broker 持续推送 | 吞吐量最高 | 消费者可能被压垮,内存溢出 | 不推荐 |
| = 1 | 一次只推送一条,确认后才推送下一条 | 严格限流,公平分发 | 吞吐量低,网络往返开销大 | 顺序消费、消费耗时长的场景 |
| 适中(10~100) | 允许一定数量的未确认消息 | 平衡吞吐与限流 | 需根据业务调优 | 大多数场景推荐 |
| 过大(1000+) | 几乎无限流效果 | 吞吐量高 | 失去限流意义,可能压垮消费者 | 不推荐 |
全局 vs Consumer 级别
basicQos 的 global 参数决定作用域:
// Consumer 级别(prefetchCount 作用于单个消费者,更精细,推荐)
channel.basicQos(10);

// global 参数:false 为 Consumer 级别,true 为 Channel 级别
channel.basicQos(10, true);- Consumer 级别(推荐):每个消费者独立计数,限流更精确。
- Channel 级别:Channel 下所有消费者共享计数,可能导致分配不均。
最佳实践
- 必须配合手动 ACK:
prefetch_count仅在autoAck=false时生效。 - 根据消费耗时调优:
- 消费快(毫秒级):
prefetch_count可设置较大(如 50~100)。 - 消费慢(秒级):
prefetch_count应设置较小(如 1~10)。
- 消费快(毫秒级):
- 避免设置过大:过大的
prefetch_count会导致消息积压在客户端内存中,可能引发 OOM。 - 公平分发:设置
prefetch_count=1可实现公平分发(能者多劳),避免快消费者空闲、慢消费者积压。
🔬 扩展知识
【L3】prefetch 与批量消费的联动
详情
批量消费场景下 prefetch 应 ≥ 批量大小,否则管道内消息凑不够一批;但也不宜过大,避免单消费者 OOM 后整批 requeue。经验值是「prefetch = 批量大小 × 1~2」,并结合单条消息体积估算客户端内存占用。
【L4】prefetch=0 的真实行为
详情
prefetch=0 表示不设限,Broker 会尽可能多推(受内存与调度约束),常被误读为「不推送」;这在慢消费者场景会把队列内存压力转移到客户端,是隐性 OOM 来源。AMQP 规范中 0 的含义是「无限制」,面试中是经典陷阱。
⚠️ 常见误区
详情
常见误区:
- ❌ “prefetch 越大吞吐越高,往大里设” → 错误。过大 prefetch 把未确认消息压在客户端内存,消费者崩溃后整批重投,且失去限流意义;应按消费耗时平衡设置。
- ❌ “autoAck 模式下 prefetch 也生效” → 错误。prefetch 只约束未确认消息,autoAck 推送即确认,无未确认可言,QoS 不生效。
- ❌ “prefetch 限制的是队列总消息数” → 错误。它限制的是每个消费者(或 Channel)的未确认数,与队列长度无关。
🔀 发散问题
- prefetch 和 Kafka 的 max.poll.records 有什么相似之处?
都是消费端批量拉取/推送的上限控制,作用都是平衡吞吐与内存压力;区别在 RabbitMQ 是 Broker 推送模型下的信用额度,Kafka 是客户端拉取模型的批量参数。 - 如何实现「能者多劳」的公平分发?
设置 prefetch=1,Broker 只在消费者确认后才发下一条,快的消费者自然拿到更多消息,避免轮询分发下的忙闲不均。
【中等】RabbitMQ 如何通过插件扩展功能?常用的插件有哪些?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:8 min | 🏷 标签:RabbitMQ / 插件机制
💎 关键结论
RabbitMQ 用 rabbitmq-plugins 工具管理插件,通过 Erlang 的 OTP 应用机制实现不停机扩展。面试重点记住五个高频插件:management(控制台)、federation(跨域)、shovel(搬运)、delayed_message_exchange(延迟)、auth_backend_ldap(认证)。
⚡ 记忆卡片
- 口诀:rabbitmq-plugins enable 启用,五大插件:管理/联邦/铲子/延迟/LDAP
- 关键词:rabbitmq-plugins / rabbitmq_management / rabbitmq_federation / rabbitmq_shovel / delayed_message_exchange / LDAP
- 链路:enable 插件 → Broker 加载 OTP 应用 → 新能力生效(控制台/转发/延迟等)→ disable 反向卸载
📖 核心知识
RabbitMQ 借助插件机制扩展功能,可通过其提供的 rabbitmq-plugins 工具管理插件。
启用插件的命令:
rabbitmq-plugins enable <插件名>禁用插件的命令:
rabbitmq-plugins disable <插件名>常用的 RabbitMQ 插件有:
rabbitmq_management:用于管理 RabbitMQ 的 Web 控制台插件,提供图形界面监控和管理。rabbitmq_federation:允许 RabbitMQ 节点和集群跨广域网通信。rabbitmq_shovel:用于桥接不同 RabbitMQ 节点,实现消息转发。rabbitmq_delayed_message_exchange:支持延迟消息,可在指定时间后投递消息。rabbitmq_auth_backend_ldap:允许 RabbitMQ 通过 LDAP(轻量级目录访问协议)进行用户认证。rabbitmq_prometheus:导出 Prometheus 监控指标,3.8+ 内置,替代旧的社区版 rabbitmq-exporter。rabbitmq_stomp/rabbitmq_mqtt/rabbitmq_web_stomp:协议适配插件,让浏览器、IoT 设备等非 AMQP 客户端接入。rabbitmq_peer_discovery_k8s/_consul/_etcd:集群节点自动发现,K8s 等动态环境下免手工维护节点列表。
🔬 扩展知识
【L3】插件与 RabbitMQ 核心的关系
详情
RabbitMQ 本身是 Erlang/OTP 应用,插件也是 OTP 应用,enable 即启动对应应用及其依赖;部分插件(如 management)需要监听额外端口(默认 15672),部署时需同步放通防火墙。可用 rabbitmq-plugins list 查看全部可用插件及启用状态。
安全边界:management 的 15672 端口直接暴露公网是重大安全隐患(暴露的 Broker 曾多次成为扫描与勒索目标);默认账号 guest/guest 出于安全设计只允许从 localhost 登录,远程管理必须创建专用账号并限制来源网络,或仅经内网/VPN 访问。
【L4】社区插件与版本兼容性
详情
除官方内置插件外,社区插件(如 consistent_hash_exchange、消息轨迹类插件)需从 RabbitMQ 社区仓库下载对应版本编译包,版本必须与 Broker 主版本匹配,否则启动失败;升级 Broker 时插件兼容性检查是标准运维步骤。
🔀 发散问题
- federation 和 shovel 插件怎么选?
订阅式、多级、需断点续传的跨集群转发用 federation;简单的点对点消息搬运用 shovel。见本文档『RabbitMQ 集群与队列高可用如何设计和配置?』。 - 延迟消息插件生产能用吗?
能,但大量延迟消息会占用内存/磁盘,需评估延迟消息存量;金融级精确场景也可用 TTL+DLX 多队列方案对比选型。见《MQ面试》『MQ 如何实现延迟消息?』。