
业务系统设计面试
业务系统设计面试
业务系统
【困难】如何设计一个秒杀系统?⭐⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:系统设计 / 秒杀
💎 关键结论
秒杀应对的是瞬时海量请求,思路是「稳、准、快」:前端静态页 + CDN 挡读流量,答题 + 限流削峰,扣库存用 Redis + Lua 原子操作保证不超卖,只有扣减成功的请求进 MQ 异步建单。最终 DB 写入量等于库存量,而不是请求量。
⚡ 记忆卡片
- 口诀:静态挡、答题缓、限流削、Lua 扣
- 关键词:瞬时海量请求 / 超卖 / 分层过滤 / Redis+Lua / 异步建单
- 链路:前端静态 + CDN → 答题限流 → Redis Lua 扣库存 → MQ 削峰 → 异步建单 → 对账兜底
📖 核心知识
秒杀系统所要应对的场景是:瞬时海量请求。
1. 秒杀的难点
- 高并发:可细分为二:
- 并发读:读取剩余库存量以及商品信息;
- 并发写:下单后写入订单记录。
- 超卖:秒杀商品通常性价比极高甚至赔本赚吆喝,库存 100 件若瞬时下单超过 100 件且处理不当,就会超卖,给商家带来巨大经济损失。
- 恶意请求:有人在多台机器上跑脚本,模拟大量用户抢商品。
- 数据库崩溃:没有 MQ 削峰、没有过载保护,海量请求直接打到数据库,数据库挂掉还会波及其他业务,让整个系统瘫痪。
- 对现有业务造成冲击:秒杀本质是营销活动,不能影响主站。
2. 设计目标:稳、准、快
- 稳(高可用):架构要能撑住活动;
- 准(一致性):减库存方式不能出现超卖;
- 快(高性能):从前端到后端、依赖组件协同优化。
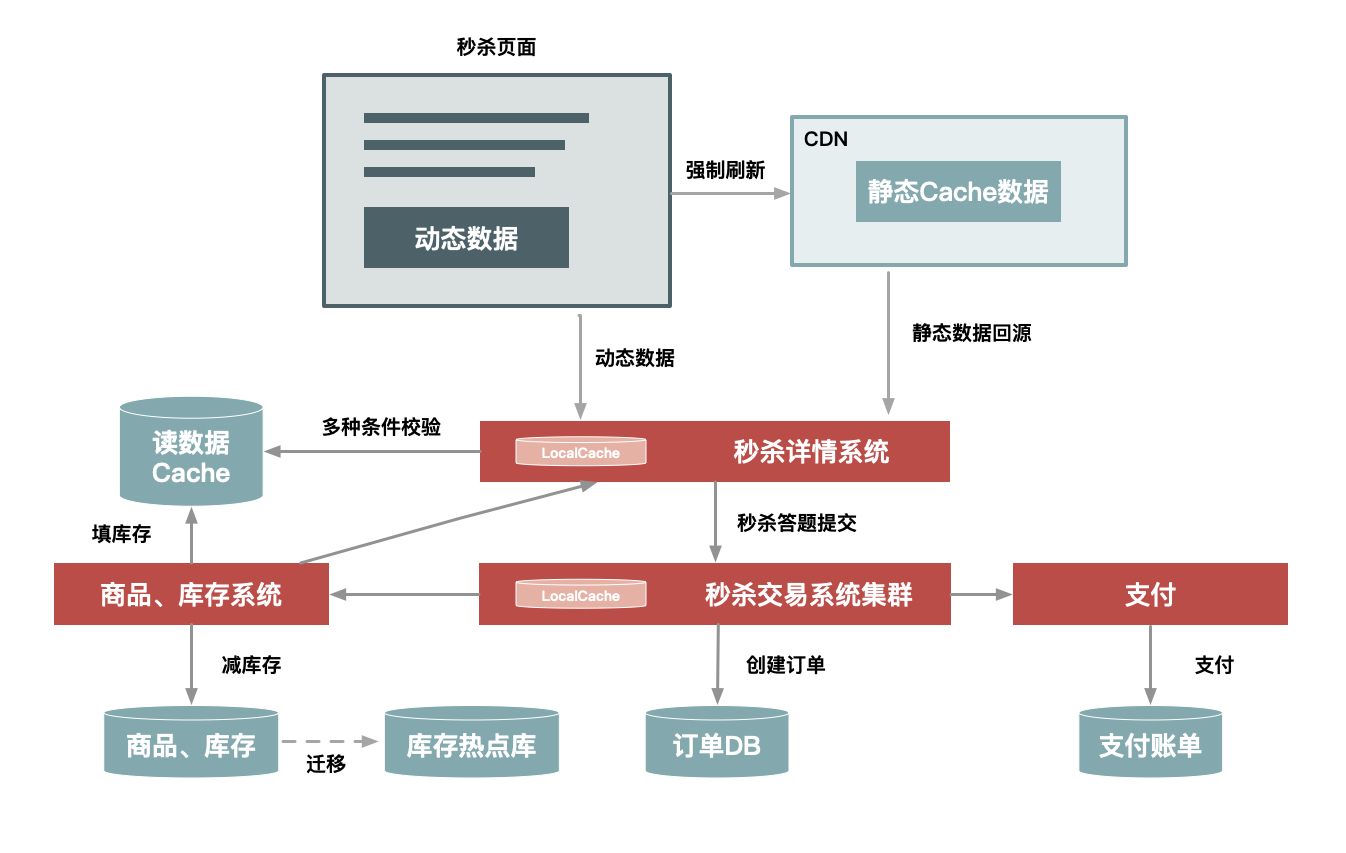
3. 前端优化
- 静态页面:秒杀商品页面静态化,减少查库 IO;静态页做 CDN 缓存,前后端分离时还可在反向代理服务器侧设置静态缓存。商品由 ID 标识(如
http://item.xxx.com/item.htm?id=xxxx),对应页面可提前做前端缓存,无需查商品信息。 - 按钮控制:活动开启前下单按钮禁用;点击后禁用一段时间,防止疯狂输出。
4. 后端优化
- 限流、熔断、降级、隔离:秒杀不应影响现有业务——
- 隔离:秒杀系统、数据与其他正常业务彼此隔离,互不影响;
- 限流:设置阈值,超过阈值拒绝请求,防止数据库被打死;
- 降级:保证核心业务继续工作,非核心业务各安天命;
- 熔断:不影响别的系统。
- 多级缓存:缓存要预热,避免瞬间流量冲击;雪崩、穿透、击穿的常规处理要做好;缓存自身也要高可用。
- 流量削峰:排队、答题、分层过滤——
- 排队:用消息队列缓冲瞬时流量,但 MQ 自身有上限,积压过多也处理不了;
- 答题(摇一摇):限制秒杀器并延缓请求;
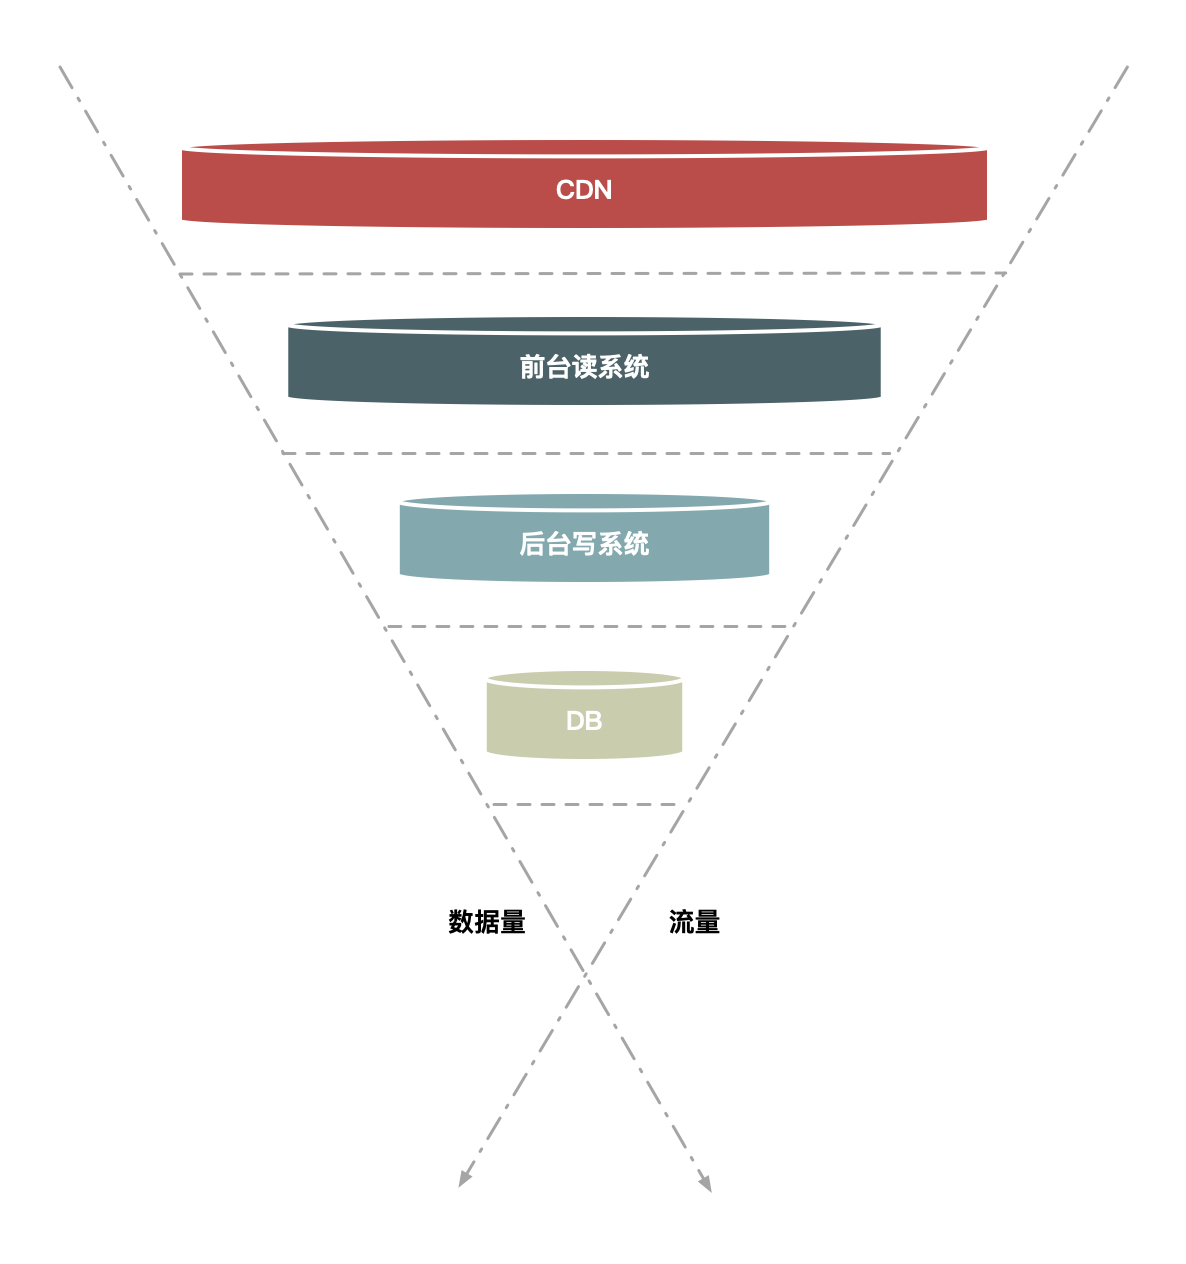
- 分层过滤:漏斗式设计,尽可能拦截无效请求。
- 减库存:
- 恶意下单:结合安全与反作弊——识别频繁下单不付款或重复下单不付款的用户并阻断;限制个人购买数。
- 避免超卖:核心是保证高并发下库存字段不为负数,常见方案:
- 应用程序中通过事务判断,减后库存为负则回滚;
- 数据库字段设为无符号整数,减后小于零直接报错;
- 使用 CASE WHEN 条件更新:
UPDATE item SET inventory = CASE WHEN inventory >= xxx THEN inventory-xxx ELSE inventory END- 库存是交易环节的关键数据也是热点数据,但秒杀不需要精确的一致性读,把库存放到缓存(Cache)中可大大提升读性能。
- URL 动态化:通过 MD5 之类的加密算法加密随机字符串生成 URL,前端获取后经后台校验才能通过,防止提前抢购。
🔬 扩展知识
详情
- 【L3】漏斗模型量化(以 100w QPS 峰值、10w 库存为例):静态页 CDN 挡掉 99% 读请求 → 答题/验证码滤掉 90% → 网关限流到应用承载量 → Redis 扣库存后仅扣减成功的请求进 MQ 建单。最终 DB 写入量 = 库存量(10w),而非请求量(100w)。
- 【L3】库存扣减方案对比:Redis + Lua 原子扣减(主流,
if stock >= n then decr,扣成功才发 MQ 建单,DB 异步落库,需缓存与 DB 对账兜底);数据库乐观锁 CAS(UPDATE stock SET n = n - ? WHERE id = ? AND n >= ?,简单可靠但热点行锁竞争大,适合库存量小、并发中等的场景);分段库存(把 10w 库存拆成 10 个 key 各 1w,随机路由打散热点,需处理段间余量不均——某段扣完可借调或跳转其他段)。 - 【L3】热点隔离与对账:秒杀商品用独立 Redis 实例/独立 DB 库表,与主站数据物理隔离,活动结束资源回收;Redis 库存与 DB 库存定时对账,不一致以 DB 为准修复。
- 【L4】方案权衡:Redis + Lua 扣减性能最高(单实例 8~10 万 QPS)但引入缓存与 DB 双存储一致性问题,需对账兜底;纯 DB 乐观锁无一致性问题但热点行锁竞争下 QPS 只有几千;分段库存解决热点但引入段间不均的管理复杂度。选型看库存量:库存 100 件没必要上 Redis,库存 10 万 + 峰值十万级才需要。
- 【L4】失效场景:MQ 建单积压超容量时用户"抢购成功但无订单",体验崩塌,需积压监控 + 提前告知;答题/验证码环节若被脚本破解,漏斗失效,需风控实时升级难度。
- 【L4】未支付订单的库存回补时序:扣减成功进 MQ 建单后,用户超时未支付(如 15 分钟)应由延时消息触发取消并回补库存;回补动作必须幂等(带订单状态条件更新),且回补记录纳入与扣减记录的对账,防止"已扣减但既未建单也未回补"的库存黑洞;大促前用全链路压测验证漏斗各层阈值与实际容量匹配,而非凭经验拍数。
📚 延伸阅读:如何设计一个秒杀系统、一个秒杀系统的设计思考
🏭 实战场景
详情
某平台周年庆秒杀:100 个 SKU,每个库存 1000 件,预计峰值 50 万 QPS 持续 3 秒,要求不超卖、不影响主站交易。
设计要点:漏斗设计——页面静态化 + CDN 挡掉 95% 读流量,答题/验证码滤掉 90% 无效请求,剩余约 2 万 QPS 进应用层;单 SKU 库存 1000 件无需分段,Redis Lua 原子扣减即可(总写压力 5 万 QPS 内,单 Redis 实例可扛);扣减成功的 10 万件请求进 MQ 异步建单,DB 写入被平滑到几分钟。独立部署秒杀集群 + 独立库表与主站隔离;全链路限流兜底,DB 前置 3000 QPS 保护。
⚠️ 常见误区
详情
常见误区:
- ❌ "在网关加个限流,数据库就不会被打挂" → 限流只控制流速,不减少放大效应;不做静态页 + CDN 拦截,读请求照样压到缓存/DB,必须漏斗式分层过滤。
- ❌ "应用层先查库存再扣减就能防超卖" → 查与扣不是原子操作,高并发下必然超卖,必须用条件更新 SQL 或 Redis + Lua 原子脚本。
- ❌ "秒杀和主站共用部署,加限流就行" → 秒杀流量瞬时放大十万倍,共享资源时拖垮主站交易是大概率事件,应独立部署、隔离故障域。
🔀 发散问题
Q:库存扣完后的几十万"已失败"请求怎么低成本地告诉用户?
→ 库存为 0 后置位 Redis 标志,网关/应用层直接短路返回"已售罄",不再走后续链路;前端按钮置灰 + 轮询/推送结果,避免用户反复刷。
Q:Redis 扣库存成功但建单失败(MQ 丢消息)怎么办?
→ 扣库存与发 MQ 无法原子,需兜底:建单成功后回写"已建单"标记,定时任务扫描"已扣减但未建单"的记录回补库存或重建订单;同时 Redis 与 DB 对账修正总量。异步建单的状态一致性设计与订单系统相关,见本文档「如何设计一个订单系统?」。
Q:秒杀扣库存和优惠券防超发有何异同?
→ 同为 Redis Lua 原子扣预算 + 异步落库 + 对账兜底,但优惠券还要叠加单用户限领与规则互斥校验,见本文档「如何设计一个营销/优惠券系统?」。
【中等】如何设计一个文件上传系统?⭐⭐⭐
🎯 目标等级:L2-L3 | ⏱ 建议用时:15 min | 🏷 标签:系统设计 / 文件存储
💎 关键结论
文件上传核心是四件事:存储选型、大文件分片、去重秒传、限流保护。小厂直接用 OSS 云服务,中大厂可基于 FastDFS、MinIO 自建;超大文件切片并行上传并支持断点续传,用文件哈希判重实现秒传,再用令牌桶限流防带宽被刷。
⚡ 记忆卡片
- 口诀:大分片、重哈希、断续传、刷限流
- 关键词:OSS/MinIO / 分片上传 / 断点续传 / 哈希秒传 / 令牌桶
- 链路:客户端切片 → 哈希判重 → 并行上传 → 服务端合并 → 限流保护
📖 核心知识
1. 存储选型
- 小厂可直接用 OSS 云服务,如阿里云 OSS 或腾讯云 OSS;
- 中大厂可基于 FastDFS、MinIO 等服务自建。
2. 超大文件上传
| 方案 | 实现 | 优势 |
|---|---|---|
| 分片上传 | 客户端切分成片 (1-10MB),并行上传,服务端合并 | 突破单文件大小限制,并行加速 |
| 流式上传 | 边读边传,不落本地磁盘 | 节省客户端内存 |
| 分段合并 | 服务端接收分片,异步合并 | 避免长连接占用 |
3. 断点续传
- 客户端:记录已上传分片列表(localStorage/IndexedDB);
- 上传前:请求服务端获取已上传分片列表;
- 上传时:只传缺失分片;
- 完成:服务端合并。
4. 避免重复文件存储
- 客户端计算文件数字签名(采用 MD5、SHA 等算法);
- 如果文件特别大,可按固定大小切片,针对每个切片取头部固定数量的字节生成签名(即分片哈希);
- 服务端查询文件哈希值是否存在:
- 存在:直接返回已有文件 URL(0 秒完成);
- 不存在:执行正常上传。
哈希碰撞:碰撞概率极低,但不可不防——
- 文件数字签名采用尽可能安全的哈希算法,如 SHA-256;
- 数字签名相同时再对比文件大小,大小不同一定不是同一文件;
- 还可以抽取文件的部分字节内容进行比对。
注意:需记录文件被引用次数,引用数为零时物理删除。文件哈希这种思路不仅可用于避免重复存储,也可用于秒传——发现上传的是重复文件,直接返回上传成功。
5. 限流
限流策略:
- 单用户:10MB/s 或 100 个文件/小时;
- 单 IP:3 个并发上传;
- 单文件大小:100MB(图片)/1GB(视频);
- 集群总带宽:1Gbps(Nginx 限速)。
实现:令牌桶/漏桶算法 + Redis 计数器。
6. 性能设计
| 优化点 | 方案 | 效果 |
|---|---|---|
| 分片并发 | 3-5 片并行上传 | 带宽利用率提升 |
| 压缩传输 | Gzip 压缩文本文件 | 传输量减少 70% |
| CDN 加速 | 上传域名走 CDN 动态加速 | 跨地域延迟降低 |
| 就近上传 | DNS 解析就近上传节点 | 减少网络往返 |
| 内存池 | 复用缓冲区 | GC 压力降低 |
🔬 扩展知识
详情
- 【L3】为什么大文件要用分片哈希?全量文件哈希计算耗时随文件大小线性增长,按分片取头部固定字节生成签名可快速判重;安全上应选 SHA-256 等抗碰撞算法,MD5 已不建议用于安全判重。
- 【L3】容量与带宽估算:例如单文件上限 1GB、日活上传者 1 万、人均上传 100MB,日增存储约 1TB(3 副本则约 3TB);上传集群出口带宽需覆盖并发上传数 × 单用户限速,1000 路并发 × 10MB/s 约需 80Gbps,据此反推节点数。
- 【L3】直传架构:大文件不应经应用服务器中转(带宽双倍占用、应用层成为吞吐瓶颈),应由服务端签发 STS 临时凭证或签名,客户端直传 OSS,上传完成回调注册元数据——与云厂商 OSS 的 Web 端直传/Multipart Upload 模式一致。
- 【L3】安全边界:文件类型校验不能只信扩展名与 Content-Type(均可伪造),需检查文件魔数(头部字节);公网可访问的上传内容要接入病毒扫描与违规内容审核,防止上传通道成为恶意文件分发源。
- 【L4】合并失败与一致性:分片合并耗时长,应异步合并 + 任务表记录 + 失败重试;分片完整性以服务端记录为准,避免"合并完成但分片缺失"的幽灵文件。自建分片上传的本质与云厂商 OSS 的 Multipart Upload API 一致,可参考其分片号、回调与断点协议设计。
🔀 发散问题
Q:如何防止恶意用户刷上传带宽?
→ 多维度限流:单用户限速/限文件数、单 IP 限并发、单文件大小上限、集群总带宽(Nginx 限速),用令牌桶/漏桶 + Redis 计数器实现。
Q:秒传具体怎么实现?
→ 客户端计算文件哈希先查服务端,命中则直接返回已有文件 URL(0 秒完成),只增加一次引用计数,不做物理存储。
Q:哈希碰撞了怎么办?
→ 碰撞概率极低但必须设防:用 SHA-256 等安全算法;签名相同时再比文件大小;必要时抽样部分字节比对。
【中等】如何设计一个单点登录系统(SSO)?⭐⭐⭐⭐
🎯 目标等级:L2-L3 | ⏱ 建议用时:15 min | 🏷 标签:系统设计 / 认证
💎 关键结论
SSO 核心是统一认证中心 + 可信凭证,子系统不存用户信息,只校验凭证。选型上,前后端分离/微服务用 JWT,传统 Web 用 CAS,第三方授权用 OAuth2.0;关键保障是凭证防篡改、登出同步、认证中心多活,避免单点故障。
⚡ 记忆卡片
- 口诀:统一认证、凭证可信、本地验签、黑名单登出
- 关键词:认证中心 / JWT / CAS 票据 / Refresh Token / 黑名单
- 链路:子系统跳转 → 认证中心登录 → 颁发凭证 → 本地验签免登 → 黑名单 + 通知登出
📖 核心知识
1. 核心组件
| 组件 | 作用 |
|---|---|
| 认证中心(SSO Server) | 唯一登录入口,负责用户身份校验、颁发凭证、登出同步 |
| 子系统(SSO Client) | 业务系统(如订单、商品、支付系统),依赖认证中心验证用户身份 |
| 凭证(Token/Ticket) | 认证中心颁发的身份标识(如 JWT、ST 票),用于子系统校验 |
| 用户 | 访问各子系统的终端用户 |
2. 步骤一:选择 SSO 实现方案
| 方案 | 核心逻辑 | 适用场景 |
|---|---|---|
| Token 方案(JWT) | 认证中心生成 JWT Token,子系统本地验签(无需回调认证中心) | 前后端分离、微服务、跨域(APP / 小程序) |
| CAS 协议(票据) | 子系统跳转认证中心登录,认证中心返回 ST 票,子系统回调认证中心验票 | 传统 Web 系统、需严格会话控制 |
| OAuth2.0(授权) | 子系统申请授权,认证中心颁发 Access Token,用于访问用户资源 | 第三方授权登录(如微信 / 支付宝登录) |
3. 步骤二:设计凭证机制(凭证防篡改)
- JWT Token(推荐):
- 结构:Header(加密算法)+ Payload(用户 ID / 过期时间)+ Signature(签名);
- 核心:子系统用公钥验签,无需调用认证中心,性能高;
- 防护:设置短过期时间(如 1 小时),配合刷新令牌(Refresh Token)续期,Token 不可篡改。
- 票据(CAS 方案):
- TGT:用户登录后认证中心生成的会话凭证(存服务端);
- ST:子系统跳转时,认证中心基于 TGT 生成的一次性票据,子系统回调认证中心校验 ST 有效性。
4. 步骤三:设计登录流程(以 JWT 为例)
- 用户访问子系统 A,未登录则跳转至认证中心;
- 用户在认证中心输入账号密码,校验通过后,认证中心生成 JWT Token(含用户 ID、过期时间),返回给用户;
- 用户携带 Token 访问子系统 A,子系统 A 验签通过后,建立本地会话,实现登录;
- 用户访问子系统 B,携带同一 Token,子系统 B 验签通过后,直接免登。
5. 步骤四:设计登出流程(关键防残留)
- 用户在任一子系统发起登出请求,跳转至认证中心;
- 认证中心处理:若用 JWT,将 Token 加入 Redis 黑名单(解决 JWT 无法主动销毁);若用 CAS,销毁服务端 TGT 会话;
- 认证中心通知所有子系统销毁本地会话(如通过 MQ 推送登出消息);
- 子系统校验 Token 时,先查黑名单,失效则拒绝访问。
6. 步骤五:核心防护设计(必做)
- 防伪造:Token 签名加密(如 HS256/RSA),避免篡改;
- 防过期:Refresh Token 机制,Token 过期后自动刷新;
- 防跨域:配置 CORS 白名单,仅允许可信子系统访问;
- 防重放:Token 加入 nonce 随机数,或设置极短过期时间;
- 高可用:认证中心集群部署,Token 黑名单(Redis)做主从同步。
🔬 扩展知识
详情
- 【L3】JWT 无状态的代价:登出/踢人/改密无法立即生效,本质是用黑名单把无状态又变成了有状态——黑名单 key 只存 jti 不存全量 Token,TTL 设为 Token 剩余有效期,控制 Redis 内存。
- 【L3】时钟漂移:验签时 exp 判断加几秒容差(leeway),否则集群机器时钟不同步会导致 Token 忽有效忽失效。
- 【L4】单点登出的最终一致窗口:MQ 通知各子系统销毁会话是异步的,存在秒级窗口;可接受则用短有效期 Token 兜底,不可接受则子系统每次请求回调认证中心校验(牺牲性能换强控)。
- 【L4】方案权衡与事故:JWT 验签无需回调认证中心,每请求省去一次远程调用(约 5~10ms),代价是无法即时废黜(依赖黑名单);CAS 会话集中可控但认证中心成为性能瓶颈与单点,高并发下验票压力需集群抗。曾有线上事故:认证中心单点宕机,所有子系统登录态校验失败,全站不可用 20 分钟——认证中心必须多活 + 子系统本地验签兜底。
- 【L4】规模化估算(集团 20 个子系统、Web + App + 小程序混合、日登录 500 万次、踢人 10 秒内生效):选 JWT + Refresh Token(App/小程序无法用 Cookie 共享),认证中心多活部署 + Redis 黑名单集群;踢人靠黑名单 jti 秒级生效,子系统本地验签缓存 TTL 设 5~10 秒兜底;登录 QPS ≈ 500 万/86400 × 峰值系数 ≈ 几百 QPS,两机房双活轻松承载。关键设计:子系统对认证中心的依赖只有登录/刷新,验签本地完成,认证中心短时抖动不影响存量会话。
🔀 发散问题
Q:JWT 方案下如何实现"踢人下线"?
→ 把被踢用户的 jti 或 userId + 签发时间戳加入 Redis 黑名单(TTL = Token 剩余有效期),子系统验签后查黑名单;若子系统本地缓存了验签结果,需 MQ 广播失效事件,容忍秒级窗口。
Q:跨域场景(app.xxx.com 与 h5.xxx.com)如何共享登录态?
→ 同主域用 Cookie domain=.xxx.com 共享;跨主域只能走认证中心重定向(CAS 式)或 Token 通过 URL/PostMessage 传递后存本地,后者需防 URL 泄露(一次性 code 兑换)。
Q:认证中心 QPS 怎么估算?
→ JWT 方案下认证中心只承担登录/刷新请求(QPS = 登录频次,远低于业务 QPS);CAS 方案要按全量请求验票估算,通常需本地 Session 缓存把验票频率降到会话级,否则认证中心会成为全链路瓶颈。
Q:微信扫码登录和 SSO 是什么关系?
→ 微信扫码属于第三方授权登录(OAuth2.0 授权码模式),可视为 SSO 体系中接入外部认证中心的一种形态,见本文档「如何实现微信扫码登录?」。
【中等】如何实现微信扫码登录?⭐⭐⭐
🎯 目标等级:L2-L3 | ⏱ 建议用时:15 min | 🏷 标签:系统设计 / 第三方登录
💎 关键结论
微信扫码登录本质是 OAuth2.0 授权码模式。微信官方网站应用登录:PC 端内嵌微信 qrconnect 授权二维码(携带 AppID 与 state),用户扫码确认授权后,微信将浏览器重定向回 redirect_uri 并携带一次性 code,后端用 code + AppSecret 换 AccessToken、拉取用户信息,最后颁发自己的 Session 或 JWT 完成登录。面经中广为流传的"自建 UUID 二维码 + Redis 状态 + 前端轮询"是通用扫码登录模型(适用于自建 App 扫码场景),与微信官方流程的差异见扩展知识。
⚡ 记忆卡片
- 口诀:画码、扫绑、轮询换、取信登
- 关键词:UUID / openid / 授权码 code / AccessToken / 轮询
- 链路:生成 UUID 二维码 → 扫码绑定 openid → 回调更新状态 → 轮询得 code → 换 Token → 颁发会话
📖 核心知识
说明:下文按面试常考的通用扫码登录模型(服务端自生成 UUID + Redis 记状态 + 前端轮询)展开三阶段;微信官方网站应用登录实际采用 qrconnect 授权页 + 浏览器重定向回传 code 的方式,无服务器间回调,精确差异见 🔬 扩展知识。
1. 第一阶段:准备阶段(生成二维码)
目标:让 PC 网页拿到一个唯一标识本次登录请求的 UUID,并把它画成二维码。要点:网页后端生成唯一 ID,Redis 记下它状态,URL 塞进二维码里。
- 准备材料:第三方网站需要在微信开放平台提前注册,拿到
AppID和AppSecret; - 请求二维码:用户点击"微信登录",PC 端网页向后端请求一个二维码;
- 生成 UUID:第三方服务器生成一个唯一的、临时的 UUID(或称 state/ticket),并把该 UUID 的状态(如:未扫描)存到 Redis;
- 返回二维码:服务器把包含
AppID、redirect_uri(回调地址)和该UUID的信息包装成一个 URL,返回给前端画成二维码。
2. 第二阶段:扫描阶段(扫码确认)
目标:用户扫码确认,让微信服务器知道"这个 UUID 被这个微信号授权了"。要点:手机扫码读 UUID,微信确认发授权,绑定 UUID 和 openid。
- 扫码:用户打开微信扫一扫,微信 APP 解析出二维码中的
UUID; - 跳转授权:微信 APP 将该
UUID和用户身份信息(openid)发送给微信服务器,并展示授权页面("XX 应用请求获取你的昵称、头像"); - 用户确认:用户点击"确认登录";
- 记录绑定:微信服务器记录
UUID与openid的绑定关系,并通过回调通知第三方服务器该UUID已被授权。
3. 第三阶段:回调阶段(登录成功)
目标:PC 网页得知授权成功,拿到用户信息,完成登录。要点:前端一直轮询,发现授权赶紧换,换到 Token 取信息,生成票据登录。
- 轮询查状态:扫码的同时,PC 前端一直在轮询后端接口:"我这个
UUID的状态变了吗?"; - 状态变更:微信服务器通知授权成功后,第三方服务器把 Redis 中该
UUID的状态更新为"已授权",并准备好code(授权码); - 换取 Token:PC 前端轮询到"已授权",后端立即使用
code+AppSecret去微信服务器换取AccessToken; - 获取用户信息:用
AccessToken调用微信接口,获取用户openid、昵称、头像等信息; - 登录成功:后端用这些信息生成自己系统的
Session或JWT Token返回给前端,登录完成。
🔬 扩展知识
详情
- 【L3】为什么用 code 换 Token,而不是直接把 Token 返回给前端?code 是一次性、短时效的前通道凭证;AccessToken 由后端用 code + AppSecret 通过服务端通道换取,即使 code 被截获,没有 AppSecret 也换不到 Token,避免敏感凭证暴露在前端。
- 【L3】官方流程与通用模型的精确差异:微信 qrconnect 模式下二维码由微信托管(内容是授权 URL,携带 AppID/state/redirect_uri),用户扫码确认后微信以 302 将浏览器重定向到
redirect_uri?code=xxx&state=xxx(前通道回传),并非"微信服务器回调第三方服务器";前端从重定向结果拿 code 交后端换 Token。"UUID 存 Redis + 前端轮询状态"是自建扫码登录(如自家 App 扫 PC 码)的通用模型,两者混谈会被面试官抓住追问。 - 【L3】轮询 vs 长连接:轮询实现简单、兼容性好(间隔 1~2 秒并限制总时长),UUID 状态存 Redis 并设置 TTL(如 5 分钟);大规模场景可升级为 WebSocket/SSE 推送,减少无效轮询请求。
- 【L4】安全要点:UUID 必须随机不可预测,防止他人轮询劫持扫码结果;redirect_uri 需在开放平台配置白名单校验,防止授权码被钓鱼到恶意站点;OAuth2.0 实践中还应带 state 参数防 CSRF。
🔀 发散问题
Q:二维码超时未被扫描怎么办?
→ UUID 状态设置 TTL,过期后端置为失效,前端提示"二维码已失效"并提供刷新按钮,重新生成 UUID 与二维码。
Q:扫码登录成功后,PC 端与移动端如何维持统一登录态?
→ PC 端登录成功后颁发自有 Session/JWT,后续多端登录态维持就是 SSO 问题,见本文档「如何设计一个单点登录系统(SSO)?」。
Q:授权码模式和隐式模式(直接返回 Token)有什么区别?
→ 授权码模式的 Token 走后端通道换取,更安全;OAuth2.0 当前最佳实践推荐授权码模式,不推荐把 Token 直接返回给前端的隐式模式。
【中等】如何设计一个短链服务?⭐⭐⭐⭐
🎯 目标等级:L2-L3 | ⏱ 建议用时:15 min | 🏷 标签:系统设计 / 短链
💎 关键结论
短链服务三个字:生成、存储、重定向。主流方案是自增 ID 经发号器生成后转 62 进制短码,写 MySQL 读 Redis 缓存,用 302 跳转保留点击统计能力;典型读多写少,缓存可挡 99% 请求,布隆过滤器防缓存穿透。
⚡ 记忆卡片
- 口诀:发号取数、62 转码、缓存挡读、302 统计
- 关键词:发号器 / 62 进制 / Redis 缓存 / 302 / 布隆过滤器
- 链路:长链 → 发号器 ID → 62 进制短码 → 写 MySQL → 读缓存 → 302 跳转
📖 核心知识
要点:生成、存储、重定向。
1. 生成:长链变短码
- 哈希:对长链接进行哈希(如
MD5),得到一个 32 位字符串; - 自增 ID:用一个中心服务(如 Redis)生成自增数字 ID(如:100001、100002)。
短链不够短可采用转码:把数值转成 62 进制(用光所有数字 + 大小写字母)。例如 ID 100001 → 短码 aB3。
2. 存储:写 DB,读 Cache
- 写路径:
长链接 -> 发号器拿 ID -> 转短码 -> 存 MySQL(落盘); - 读路径(关键):第一步查 Redis,有就直接用;Redis 没有查 MySQL;查到后回写 Redis,下次就快了。
3. 重定向:301 还是 302?
- 301(永久):浏览器会记住,下次不再访问短链服务器;缺点是没法统计点击次数;
- 302(临时):每次都先找短链服务器再跳转;优点是可以精确计数(点了几次、谁点的)。
- 结论:推荐 302,为了数据和灵活性。
4. 性能设计
- 缓存:缓存挡住 99% 的读请求,不让流量打垮 DB;
- 预发号:短链生成服务不要每次都找发号器,而是一次性生成一批短链(比如 1000 个)放本地内存,用完了再拿,减少对发号器的压力;
- 布隆过滤器:恶意输入不存在的短码(如
aaaaaa)会造成缓存穿透,布隆过滤器像前置"筛查员",快速判断短码肯定不存在并直接拦截,保护后端。
🔬 扩展知识
详情
- 【L3】容量估算:62 进制 6 位短码空间 = 62^6 ≈ 568 亿;日生成 100 万短链可支撑约 155 年,日生成 1000 万约 15 年,不够则升 7 位。
- 【L3】发号器高可用:号段模式,每台发号实例批量取号(如每次 1000 个),DB 只存 max_id,多实例取不同号段防冲突;或用 Redis INCR 但需解决持久化。
- 【L3】哈希冲突:MD5 取前 6 位冲突概率高,需查库判重后重算或拼接重试;自增 ID 转 62 进制无冲突,是更稳的选择。
- 【L4】防枚举与防爬:自增 ID 可被顺序枚举,可对 ID 做位运算混淆或加随机盐后再转 62 进制;监控异常短码扫描行为。
- 【L4】方案权衡与事故:哈希方案无需中心化发号但冲突处理复杂(查库重试),高并发下冲突重试放大延迟;自增 ID 方案无冲突但发号器是单点依赖,需号段模式消除。曾有线上事故:用 MD5 前 6 位做短码未做冲突检测,两条不同长链映射同一短码,导致营销活动跳转到错误落地页——哈希取短必须判重,或直接选自增 ID 方案。
- 【L4】失效场景与大规模估算:布隆过滤器存在误判率(如 1% 误杀真实短码),需控制容量与哈希函数数量;短链服务典型读多写少(100:1 以上),读缓存失效风暴时需互斥重建防击穿。大促示例(日生成 500 万、峰值 5 万 TPS 生成、读峰值 20 万 QPS、防枚举):发号器号段模式多实例(每实例每次取 1 万号段,DB 压力仅几百 QPS);防枚举用自增 ID 先乘一个大质数再异或固定盐后转 62 进制,短码与 ID 无单调关系;读路径 Redis 集群承载(20 万 QPS 约 2~3 个分片实例),长 TTL 命中率 99%+,DB 只做兜底;生成峰值用 MQ 削峰异步落库,同步只返回预取号段生成的短码。
🔀 发散问题
Q:短链服务读 QPS 10 万、缓存命中率 99%,DB 要承受多少?如何再降?
→ 回源约 1000 QPS,单 MySQL 实例可扛;若命中率下降可加本地缓存(短码映射几乎不变,本地缓存命中率极高)再降一个数量级。关键设计:短码 → 长链是不可变映射,缓存可设长 TTL 甚至永不过期。
Q:如何统计点击数据而不拖慢跳转?
→ 302 返回与统计异步解耦:跳转响应先发,点击事件丢 MQ 异步落库/实时计算;统计分析走独立链路(如 Flink 实时聚合),不在跳转主路径同步写 DB。
Q:发号器实例宕机,预取的号段会怎样?
→ 号段在实例内存,宕机丢未用完的号段(如 1000 个),ID 出现空洞但不重复——号段模式天然接受空间浪费换可用性;双 Buffer 下另一个号段仍可用,对业务透明。
【困难】如何设计一个 Feed 流系统(朋友圈/微博)?⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:系统设计 / Feed 流
💎 关键结论
Feed 流本质是读写扩散的权衡:推模式发帖时写入粉丝收件箱,读快写慢,适合普通用户;拉模式读时合并,写快读慢,适合大 V;业界主流是推拉结合。存储用 Redis ZSet 存最近 N 条帖子 ID,历史落盘,读时批量回填内容。
⚡ 记忆卡片
- 口诀:小粉推、大 V 拉、读时合并、ZSet 存
- 关键词:写扩散 / 读扩散 / 推拉结合 / ZSet / 批量回填
- 链路:发帖 → 扩散决策(推/拉)→ 收件箱 ZSet → 读时合并 → ID 回填内容
📖 核心知识
Feed 流核心问题:用户关注 N 个人,如何快速拉出按时间排序的内容流?本质是读写扩散的权衡。
1. 三种模式对比
| 模式 | 原理 | 写开销 | 读开销 | 适用 |
|---|---|---|---|---|
| 推模式(写扩散) | 发帖时写入所有粉丝的收件箱 | 高(粉丝数倍数) | 低(直接读自己的箱子) | 粉丝数小的普通用户 |
| 拉模式(读扩散) | 读时遍历关注人的发件箱合并 | 低 | 高(关注数倍数) | 大 V(千万粉丝) |
| 推拉结合 | 普通用户推,大 V 拉,读时合并 | 中 | 中 | 业界主流(微博) |
量化选型:某用户 100w 粉丝,每天发 10 条 → 纯推模式日写 1000w 条,不可接受;改用拉模式后只在粉丝读时合并。
2. 存储设计
- 收件箱/发件箱:Redis ZSet(score = 发帖时间戳,member = 帖子 ID),只存最近 N 条(如 1000);历史数据落 MySQL/HBase;
- 帖子内容单独存储(帖表),Feed 流只存 ID,读时批量回填(注意用 batchGet 避免 N+1)。
3. 其他要点
- 排序策略:时间序 vs 算法推荐;
- 幂等:客户端生成帖子 ID 防重发;
- 删帖:需异步清理已扩散的收件箱(或读时过滤已删帖子)。
🔬 扩展知识
详情
- 【L3】推拉分界线怎么定:按"写放大 vs 读放大"成本平衡——某用户粉丝 F、日发帖 P,推成本 = F×P 次写/天;关注 K 人的用户拉成本 = K 次合并/刷。一般粉丝超万级转拉模式,具体阈值用实际读写 QPS 比例压测校准,且分界线应可配置化动态调整。
- 【L3】游标分页:以最后一条帖子的时间戳/ID 作为游标,向历史库(MySQL/HBase)拉取更早数据;Redis 只承担"最新一页"的热读,历史读走冷存储,避免 ZSet 无限膨胀。
- 【L4】个性化推荐排序:读时先拉候选集(收件箱 + 大 V 发件箱合并,取最近几百条 ID),再调推荐服务打分重排(召回 + 粗排 + 精排分层);打分服务超时需降级为时间序兜底,不能阻塞 Feed 返回。
- 【L4】方案权衡:推模式的代价是写放大(粉丝数倍数),大 V 发帖一条写百万次,纯推模式在大 V 场景必然失效;拉模式的代价是读放大(关注数倍数),用户关注 500 人时每次刷 Feed 要合并 500 个列表,读 RT 不可接受;推拉结合的分界线(如粉丝 > 1 万走拉)需根据实际读写比例压测定,而非拍脑袋。
🏭 实战场景
详情
朋友圈类场景:用户平均 300 好友(双向关注、无大 V 问题),DAU 1 亿,日发帖 5000 万条,要求刷 Feed P99 < 200ms。
设计要点:好友数小(300)且无超大 V,写扩散可接受——每条帖子平均扩散 300 次写,日写量 5000 万 × 300 = 150 亿次,峰值约 50 万写 QPS,需 Kafka 削峰 + Redis 集群(分片)承载;读路径直接取自己收件箱 ZSet,单次读取 O(1) 命令,P99 可控。权衡点:若写集群成本过高,可退为"活跃用户推、休眠用户拉"——发帖时只扩散给近 30 天活跃好友,大幅削减无效写。
行业教训:某社区纯推模式上线,千万粉大 V 一条帖子触发千万次 Redis 写入,收件箱写队列积压数小时——写扩散必须有粉丝数上限。
⚠️ 常见误区
详情
常见误区:
- ❌ "Feed 流一律用推模式,读性能最好" → 大 V 发帖一次写百万粉丝收件箱,写放大会打垮存储,必须对大 V 切换拉模式。
- ❌ "收件箱里直接存帖子内容,读起来省事" → 扩散会让内容被复制千万份,存储爆炸且更新困难,应只存帖子 ID,读时批量回填。
- ❌ "读扩散慢就多加机器" → 读 RT 随关注数线性增长,关注 500 人就要合并 500 个列表,单请求串行合并的代价加机器解决不了,需并行合并 + 超时截断。
🔀 发散问题
Q:用户关注太多导致 Feed 读取超时怎么办?
→ 拉模式并行合并 + 超时截断(时限内返回已合并的 Top 部分);或限制有效关注数、只拉取近期活跃关注者的发件箱。
Q:删帖后已扩散到百万收件箱的引用怎么清理?
→ 同步清理会被扩散量拖垮,应异步任务清理;清理完成前读时过滤已删帖子兜底。
Q:Feed 流存储和 IM 消息存储有什么共性?
→ 都是"时间线索引 + ID 回填写"模型,用 ZSet/列表存 ID、读时回填内容;IM 还多了会话级 seq 保序与双向扩散问题,见本文档「如何设计一个 IM 即时通讯系统?」。
【困难】如何设计一个 IM 即时通讯系统?⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:系统设计 / IM
💎 关键结论
IM 设计抓四条线:长连接网关无状态水平扩容做接入;ACK + 客户端 msgId + 会话级 seq 保证不丢、不重、不乱序;小群写扩散、大群读扩散;离线消息落库加厂商通道推送。单机网关可撑 10~20 万连接,存储按会话分库分表。
⚡ 记忆卡片
- 口诀:长连接、ACK 认、seq 序、小推大拉
- 关键词:长连接网关 / ACK / msgId / seq / 读写扩散
- 链路:客户端长连 → 网关路由 → 落库 + ACK → 收件箱扩散 → 离线推送
📖 核心知识
1. 整体架构
接入层(长连接网关)→ 逻辑层(消息路由/会话)→ 存储层(消息库/离线库)+ 离线推送。
2. 接入层设计
- 长连接选型:WebSocket / TCP 自定义协议(Netty);心跳保活(30s)检测断连;
- 连接网关无状态水平扩容,维护 userId → 连接所在网关的映射(存 Redis/注册中心),消息路由靠它找到目标用户的连接。
3. 消息可靠性(不丢、不重、不乱序)
- 不丢:发送方 → 服务器 ACK 确认机制,未 ACK 则重发;服务器 → 接收方同样 ACK;服务器落库成功后再 ACK 发送方;
- 不重:客户端生成全局唯一 msgId(会话 ID + 自增序号),服务端去重;
- 不乱序:每个会话维护自增 seq(Redis INCR 或发号器),客户端按 seq 排序;断线重连后用本地最大 seq 拉取增量补齐。
4. 消息存储与扩散
- 单聊/小群(写扩散):消息写入收发双方的会话索引(inbox),群成员少时逐人写;
- 大群(读扩散):消息只写群消息表,成员读时拉取 + 记录个人已读位点,避免百万人群写扩散爆炸;
- 消息库按会话维度分库分表(uid hash);历史消息归档冷存储。
5. 离线推送
用户不在线时消息存离线库,同时通过厂商通道(APNs/华为/小米)推送唤醒通知;上线后拉取离线消息。
🔬 扩展知识
详情
- 【L3】连接容量量化:单机长连接网关基于 Netty 可支撑 10~20 万连接(受文件描述符与内存限制,每连接内存开销几十 KB);千万在线需百台级网关集群。
- 【L3】seq 发放必须中心化:会话级 seq 要用 Redis INCR 等中心化发号器且按会话维度;用网关单机自增,网关重启后 seq 重复会导致客户端消息乱序重排。
- 【L4】扩散模式权衡与失效场景:百万人群若用写扩散,一条消息写百万条 inbox,写放大不可承受,必须读扩散 + 个人已读位点;厂商推送通道有配额与延迟(秒~分钟级),重要消息需多通道冗余。
🏭 实战场景
详情
企业 IM:500 万员工同时在线(工作日早高峰 9 点集中上线),单聊占 70%、千人群占 5%,要求消息端到端延迟 P99 < 500ms、不丢不乱序。
设计要点:接入层 500 万连接 / 单机 10 万 ≈ 50 台网关(预留 30% 冗余),早高峰重连风暴需客户端指数退避 + 服务端渐进注册;单聊写扩散(收发双方 inbox 各写一条,写放大 2 倍可接受);千人群用读扩散(消息只写群表,成员拉取 + 个人已读位点)——若千人群写扩散,一条消息写 1000 条,早高峰必崩;seq 用 Redis INCR 按会话发号,msgId 客户端生成防重;消息落库成功后再 ACK 发送方,保证不丢。
生产事故教训:曾有线上事故——群消息 seq 用单机自增,网关重启后 seq 重复,客户端消息乱序重排。seq 必须用中心化发号器(Redis INCR)且按会话维度。
⚠️ 常见误区
详情
常见误区:
- ❌ "消息发出去就行,不用 ACK" → 网络抖动与客户端崩溃都会导致消息丢失,必须双向 ACK + 未确认重发,服务端落库成功才能 ACK 发送方。
- ❌ "用服务端生成的消息 ID 就能同时保证去重和顺序" → 重发时服务端会生成新 ID,无法去重;应由客户端生成唯一 msgId 供服务端去重,顺序由独立的会话级 seq 保证。
- ❌ "百万人群用写扩散也没问题,就是多写点" → 一条消息写百万条 inbox,写放大直接打垮存储与写链路,大群必须读扩散。
🔀 发散问题
Q:消息已读状态怎么设计?
→ 不逐条标记已读,只存会话级"已读位点"(已读到的最大 seq),未读数 = 最新 seq - 已读位点;群已读回执(如钉钉)是例外,需单独存储已读成员位图,成本高,仅小群可用。
Q:网关重启时如何做到连接不丢消息?
→ 客户端断线重连携带本地最大 seq 向新网关拉取增量(写扩散下消息已落库);服务端连接路由表(userId → 网关)随连接迁移更新;核心是消息落库与 ACK 解耦,重连可补拉。
Q:IM 消息存储量如何估算?
→ 单条消息约 200~500 字节,日活千万、人均 50 条 → 日增约 5 亿条 / 100~250GB,一年数十 TB;需按会话分库分表 + 半年以上消息归档冷存储(对象存储),在线库只保热数据。
Q:IM 的时间线存储和 Feed 流有什么共性?
→ 都是"按会话/用户存 ID 索引 + 读时回填",都需要冷热分层;Feed 流还需处理读写扩散的分界线,见本文档「如何设计一个 Feed 流系统(朋友圈/微博)?」。
【困难】如何设计一个订单系统?⭐⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:系统设计 / 交易
💎 关键结论
订单系统核心是状态机 + 快照 + 分片:状态变更必须带前置条件更新防非法流转,下单时快照商品名与价格隔离后续改价,按买家 ID 分库分表支撑 C 端查询,卖家多维查询靠 ES 异构索引,一致性靠事件驱动 + 对账修复,不追求强一致。
⚡ 记忆卡片
- 口诀:状态机管流转、快照锁价格、买家分片、ES 查卖家、对账兜底
- 关键词:状态机 / 订单快照 / 买家 ID 分片 / 异构索引 / 事件驱动对账
- 链路:建单(快照 + 预占库存)→ 支付回调异步 → 状态机流转 → 买家分片查 / ES 多维查 → 对账修复
📖 核心知识
1. 订单状态机(核心)
- 主状态:待支付 → 已支付 → 待发货 → 已发货 → 已完成;分支:已取消、退款中;
- 所有状态变更必须带条件更新(
UPDATE ... WHERE status = 前置状态)+ 状态机校验,拒绝非法跳转;状态变更流水表完整留痕。
2. 数据模型设计
- 主单/子单拆分:一次下单多商家/多仓拆为多个子单,各自履约;
- 订单快照:商品名称/价格/优惠在下单时快照进订单,后续商品改价不影响历史订单(避免依赖商品表);
- 垂直拆表:订单主表 + 订单明细 + 支付单 + 物流单,避免大宽表。
3. 性能与存储
- 分库分表:按买家 ID 分片(C 端查询主场景);卖家维度查询同步到 ES 异构索引;
- 冷热分离:三个月内热单在在线库,历史单归档到历史库/数仓,在线库保持小体量;
- 写优化:下单链路同步只做最少动作(建单 + 预占库存),支付回调、通知、积分全部异步化。
4. 一致性与兜底
- 幂等:下单幂等键、支付回调幂等(见《功能设计面试》『如何避免用户重复下单』『如何解决订单重复支付情况』);
- 与库存/优惠/支付的状态一致性靠事件驱动 + 对账修复,不追求分布式事务强一致;
- 超时未支付自动取消:延迟消息 + 扫表兜底(见《功能设计面试》『如何实现一个订单超时取消功能?』)。
🔬 扩展知识
详情
- 【L3】快照的代价量化:订单快照避免历史单受商品改价影响,代价是存储冗余(快照字段约占单量 30%)与下单时多一次商品查询——相比改价引发的资损与客诉,这是必须付的成本。
- 【L3】写路径优化:下单同步路径只做建单 + 预占库存,RT 控制在 50ms 内;支付回调、通知、积分、风控全部异步化,DB 单实例写入约 5000 TPS 是常见瓶颈,大促前必须压测 + MQ 削峰。
- 【L4】分片键权衡:按买家 ID 分片对 C 端查询友好但卖家查单困难,需 ES 异构索引(引入同步延迟与运维成本);备选方案有基因法分片(把卖家信息编入订单号,牺牲买家维度灵活性)与数据同步到独立卖家库(链路复杂),主流仍是 ES 异构索引,核心是接受秒级延迟并做对账。
- 【L4】失效场景:ES 异构索引同步延迟时卖家看到旧数据;大促建单洪峰下 DB 写入瓶颈,需提前压测 + MQ 削峰 + 预案降级。
🏭 实战场景
详情
电商平台大促:峰值 5 万 TPS 下单,订单日增 2000 万笔,买家查单占 90% 流量,卖家后台需按店铺/时间多维查询。
设计要点:下单链路同步只做建单 + 预占库存,支付回调/通知/积分全部异步化,同步路径 RT 控制在 50ms 内;订单按买家 ID 分库分表(32 库 32 表起步,预留扩容),买家查单直查分片;binlog 经 Canal 同步到 ES 支撑卖家多维查询,容忍秒级延迟;下单时快照商品名/价格/优惠,历史单不受商品变更影响;三个月以上订单归档历史库,在线库保持轻量。
生产事故教训:曾有线上事故——订单未存快照直接关联商品表,商品改价后历史订单金额展示错乱,引发大量客诉。快照是订单系统的底线设计。
⚠️ 常见误区
详情
常见误区:
- ❌ "订单展示直接查商品表就行,不用存快照" → 商品改价、下架会让历史订单金额与名称错乱,快照是底线设计。
- ❌ "订单状态流转用应用层 if-else 控制就行" → 并发与多入口(回调、定时任务、人工客服)下必然遗漏分支,必须带条件更新 + 合法迁移表,非法跳转直接拒绝并告警。
- ❌ "用分布式事务保证订单、支付、库存强一致" → 高并发下强一致的性能代价不可承受,业界主流是事件驱动 + 对账修复的最终一致性。
🔀 发散问题
Q:订单状态机如何防止并发下非法流转?
→ 更新语句带前置状态条件(
WHERE status = 前置态)+ 影响行数判断,并发下只有一个变更能成功;状态机定义合法迁移表,非法跳转直接拒绝并告警,不依赖应用层 if-else 判断。Q:卖家维度查询除了 ES 还有什么方案?各自代价?
→ 异构索引(ES/双库双写,延迟与一致性成本)、基因法分片(把卖家信息编入订单号,牺牲买家维度灵活性)、数据同步到独立卖家库(链路复杂)。主流是 ES 异构索引,核心是接受秒级延迟并做对账。
Q:订单表多大需要分库分表?分片后如何支持多维查询?
→ 单表超 5000 万行或单库写入超几千 TPS 时考虑;分片键选最高频查询维度(买家 ID),其余维度(卖家、手机号、时间范围)靠异构索引,不要在分库表上做全表扫。
Q:订单幂等和支付回调幂等的共性是什么?
→ 都是业务唯一键(下单幂等键、渠道交易号 + 支付单号)+ 唯一索引去重 + 状态机条件更新,见本文档「如何设计一个支付系统?」。
【困难】如何设计一个营销/优惠券系统?⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:系统设计 / 营销
💎 关键结论
优惠券本质是钱,设计核心是资产安全 + 高并发发放 + 规则正确:发放用 Redis Lua 预算前置扣减防超发,计算用分(long)+ 分摊算法保证实付不为负,状态变更全程记流水,每日对账保证账实相符。
⚡ 记忆卡片
- 口诀:发放先预扣、计算用分、分摊归尾、对账保平
- 关键词:预算前置 / Redis Lua / 分(long)/ 分摊尾差 / 唯一索引幂等
- 链路:创建模板 → Redis 预扣发放 → MQ 异步落库 → 下单锁定 → 支付核销 → 对账修复
📖 核心知识
优惠券本质是钱,设计核心是资产安全 + 高并发发放 + 规则正确。
1. 生命周期与状态机
创建(活动模板)→ 发放 → 领取 → 锁定(下单占用)→ 使用/解锁(取消退回)→ 过期;每次状态变更写流水表,可审计对账。
2. 高并发发放(防超发)
- 预算前置:活动总预算预扣到 Redis,Lua 脚本原子扣减(
if remain > 0 then decr),扣成功才写领取记录; - 领取限流:单用户限领 N 张(Redis 计数);风控前置(设备指纹/黑名单防羊毛党);
- 异步落库:领取事件入 MQ 批量入库,Redis 与 DB 定时对账。
3. 优惠计算引擎(最容易出错)
- 优惠层级:商品级(直降)→ 订单级(满减)→ 支付级(立减),层级内互斥/叠加规则配置化;
- 金额计算红线:用分(long)计算不用浮点;分摊算法保证"各商品分摊之和 = 总优惠"(尾差归到最后一件);实付永不为负;
- 规则引擎化:互斥组、优先级、适用商品圈(类目/商品白名单)配置化,避免硬编码。
4. 资产安全
- 使用/退回必须幂等(订单 ID + 券 ID 唯一索引);退款时券是否退回按业务规则配置;
- 每日对账:发放量 = 领取量 + 过期量 + 使用量,不平则告警人工介入。
🔬 扩展知识
详情
- 【L3】发放性能量化:Redis Lua 预扣性能最高(单实例 8~10 万 QPS)但需与 DB 对账保一致性;纯 DB 领取(唯一索引防重)无一致性问题但峰值几千 QPS 就是瓶颈——大促领券必须预算前置到 Redis。
- 【L3】规则引擎设计:互斥组、优先级、适用商品圈全部配置化而非硬编码;规则变更走审批 + 灰度发布,避免运营误配置直接放大成资损。
- 【L4】失效场景:Redis 预算与 DB 记录不一致时(如异步落库丢消息),需对账任务修正;退款时券是否退还需按活动规则配置,默认不退易引客诉。
- 【L4】资损防线设计:"实付不为负 + 优惠总额不超商品价"必须是代码级硬校验,不能依赖运营配置正确——配置只能决定优惠怎么组合,资金红线必须由代码兜底。
🏭 实战场景
详情
618 大促:平台券 1000 万张,开场 10 秒内领取峰值 8 万 QPS,单用户限领 3 张;券可与商品直降叠加但不可与店铺券叠加。
设计要点:发放——券模板总预算 + 单用户限额全部前置 Redis,Lua 原子扣减(单实例 8~10 万 QPS 可扛,或拆两个分片),扣减成功发 MQ 异步落领取记录,同步接口 RT < 20ms;核销——下单时券状态置"锁定"(订单 ID 唯一索引防重),支付成功转"已使用",取消退回;优惠计算引擎硬校验实付 ≥ 0 + 互斥组规则,配置变更需审批;每日对账发放 = 领取 + 过期 + 使用,不平告警。
生产事故教训:曾有线上事故——满减与店铺券叠加规则未配置互斥,两者叠加后实付为负,被羊毛党刷单数万元。"实付不为负 + 优惠总额不超商品价"必须是代码级硬校验。
⚠️ 常见误区
详情
常见误区:
- ❌ "优惠券金额用浮点数算,简单直观" → 浮点精度丢失会导致分摊出现分级误差与账不平,必须以"分"为单位用 long 整型计算。
- ❌ "互斥规则靠运营配置正确就行" → 配置错误不可避免,实付不为负、优惠总额不超商品价必须做代码级硬校验兜底。
- ❌ "Redis 扣预算成功就完事,不用和 DB 对账" → 异步落库可能丢消息,预算与实际领取量会不一致,必须定时对账,不平告警人工介入。
🔀 发散问题
Q:优惠分摊尾差问题怎么解?举例。
→ 满 100 减 10,三件商品 33.33/33.33/33.34,按比例分摊每件减 3.33/3.33/3.34,尾差归最后一件;单件退款时按分摊后金额退,保证总账平衡。用分(long)计算避免浮点精度丢失。
Q:领券峰值 10 万 QPS,如何防止单用户超领?
→ Redis 原子计数
INCR coupon:{id}:{userId}前置判断(超过限额拒绝),Lua 脚本内合并"预算扣减 + 个人限额判断"保证原子性;异步落库后用 DB 唯一索引(券 ID + 用户 ID)做最后防线。Q:优惠计算引擎如何保证规则变更不出错?
→ 规则配置化 + 变更审批 + 发布前用历史订单回放验证(同样输入对比新旧引擎结果);金额计算模块单测覆盖率要求 90%+,覆盖分摊、互斥、边界(实付为 0/优惠超商品价)用例。
Q:优惠券防超发和秒杀扣库存有什么异同?
→ 同为 Redis Lua 原子扣减 + 异步落库 + 对账兜底,优惠券多了单用户限领与互斥组校验;秒杀则多了漏斗式流量过滤,见本文档「如何设计一个秒杀系统?」。
【困难】如何设计一个支付系统?⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:系统设计 / 支付
💎 关键结论
支付系统第一原则是资金安全大于一切,宁可慢不可错。核心三模块:支付网关屏蔽渠道差异、支付单与业务订单解耦、账务复式记账;可靠性靠回调幂等 + 主动查单 + 日终对账三层兜底;金额全链路用分(long),余额只允许通过流水变更。
⚡ 记忆卡片
- 口诀:网关屏蔽、支付单解耦、复式记账、三层兜底
- 关键词:支付网关 / 支付单 / 复式记账 / 回调幂等 / 对账
- 链路:支付请求 → 网关路由渠道 → 支付单状态机 → 回调/查单确认 → 账务记账 → 对账核验
📖 核心知识
支付系统的第一原则:资金安全大于一切,宁可慢不可错。
1. 核心模块
- 支付网关:统一对接微信/支付宝/银联等三方渠道,屏蔽差异(协议、回调格式、对账文件),支持通道路由与自动切换;
- 支付单:与业务订单解耦(一笔订单可对应多笔支付单:重试、换渠道、拆单);状态机:待支付 → 支付中 → 成功/失败/关闭;
- 账务系统:复式记账(每笔交易借贷平衡),余额变更只允许通过账务流水,禁止直接改余额字段。
2. 关键设计
- 回调幂等与状态驱动:三方回调可能重复/乱序到达,以渠道交易号 + 支付单号幂等去重;只允许"待支付 → 成功"单向迁移,终态后拒绝任何变更;
- 主动查单兜底:回调丢失时定时任务主动调渠道查单接口补状态(注意频率限制);
- 对账体系(资损最后防线):每日拉取渠道账单与本地流水逐笔核对,分差错账/长短款处理;实时对账监控金额突变;
- 金额处理:全链路用分(long);退款金额校验 ≤ 已付金额;手续费/分账规则单独建模;
- 安全:签名验签、防重放(见《安全设计面试》『如何设计一个接口签名验证机制?』);支付回调接口只信任服务端签名,不信任前端传参;密钥托管 KMS。
3. 性能量化
大促支付峰值可达几十万 TPS,核心靠异步化(支付请求入 MQ 串行化处理同一用户)+ 渠道连接池复用 + 降级预案(非核心校验可关闭)。
🔬 扩展知识
详情
- 【L4】主动查单的成本权衡:主动查单是回调不可靠的必要兜底,但渠道查单接口有频率限制(通常每单每分钟几次),需控制扫描频率与优先级——刚发起的订单高频查,久未完成的降频。
- 【L4】复式记账的价值:比单表余额更新复杂得多,但它是账务可审计、可对账的唯一途径;绕过流水直接改余额,一旦并发出错将无法追溯,只能人工逐笔对账修复。
- 【L4】失效场景:渠道侧回调与查单结果不一致时(如回调说成功、查单说处理中),以查单为准并进入差错账人工处理;跨时区/跨渠道对账文件格式差异需适配层统一解析。
- 【L4】变更安全与资损熔断:支付核心链路发布必须可灰度、可监控、可回滚(变更三板斧);预置资损熔断开关——一键关闭某渠道支付并降级到剩余渠道,实时对账监控到金额突变时自动熔断 + 告警,而不是等 T+1 对账或人工发现。
🏭 实战场景
详情
电商平台双 11:支付峰值 10 万 TPS,对接微信/支付宝/银联三渠道,要求资损零容忍、渠道故障 1 分钟内可切换。
设计要点:支付请求入 MQ 按用户维度串行化(同一用户顺序处理防并发双付);支付网关维护渠道健康度(成功率/RT 实时统计),渠道故障自动路由切换 + 人工一键切换开关;回调幂等(渠道交易号 + 支付单号唯一索引)+ 主动查单兜底 + T+1 三方对账;账务复式记账保证借贷平衡,日切对账不平即告警;10 万 TPS 下应用层无状态水平扩容,瓶颈在渠道侧配额,需提前与渠道报备扩容。
生产事故教训:曾有线上事故——直接 UPDATE 余额字段绕过账务流水,一次并发下余额错乱且无法追溯,最终人工逐笔对账修复。余额只允许通过流水变更。
⚠️ 常见误区
详情
常见误区:
- ❌ "支付回调可信,收到成功回调直接改单即可" → 回调可能丢失、延迟甚至伪造,必须签名验签 + 幂等去重 + 主动查单 + 日终对账多层兜底。
- ❌ "余额字段直接 UPDATE,比复式记账简单" → 绕过流水的余额无法审计、无法对账,并发下错乱不可追溯;余额只允许通过账务流水变更。
- ❌ "退款按用户申请金额直接退就行" → 必须校验累计退款 ≤ 已付金额(应用层 + DB 带条件更新双层校验),并联动发票、已享优惠的业务规则。
🔀 发散问题
Q:支付回调丢失或延迟的完整兜底链路?
→ 三层:回调幂等去重 → 未终态支付单定时主动查单(优先级:刚发起的订单高频查,久未完成的降频)→ 日终对账拉渠道账单逐笔比对,长短款进差错账人工处理。
Q:用户支付中重复点支付按钮怎么办?
→ 同一订单已存在"支付中"支付单时,不新建支付单而是返回原支付单(唤起同一渠道交易),渠道侧也以商户单号幂等;超时未完成的支付单自动关闭后才能换渠道重发。
Q:退款如何保证不超额?
→ 退款单关联原支付单,累计退款额 ≤ 已付额在应用层 + DB 双层校验(
UPDATE ... WHERE 已退 + 本次 <= 已付带条件更新);部分退款需校验与已开发票、已享优惠的联动规则。Q:支付幂等和订单幂等的设计共性是什么?
→ 都是业务唯一键 + 唯一索引 + 状态机单向迁移,终态后拒绝任何变更,见本文档「如何设计一个订单系统?」。
【困难】如何设计一个多租户 SaaS 系统?⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:系统设计 / SaaS
💎 关键结论
多租户 SaaS 的核心挑战是在共享基础设施上实现租户间的数据隔离、资源隔离与安全隔离。数据隔离有三种策略:共享表(tenant_id 字段,成本最低隔离最弱)、独立 Schema(同库不同 Schema,中等)、独立数据库(最强隔离最贵);元数据驱动架构让一套代码通过配置差异化服务不同租户;安全隔离要做到认证鉴权租户化、资源配额防"吵闹邻居"。
⚡ 记忆卡片
- 口诀:共表独库分三级、元数据驱动一套皮、吵闹邻居要隔离、灰度按租户灰
- 关键词:数据隔离三级 / 元数据驱动 / 吵闹邻居 / 租户配额 / 灰度发布
- 链路:租户元数据 → 数据隔离策略选型 → 资源配额管控 → 安全隔离 → 灰度升级
📖 核心知识
1. 数据隔离策略
| 策略 | 实现 | 优势 | 劣势 |
|---|---|---|---|
| 共享表 | 所有租户数据存同一张表,通过 tenant_id 区分 | 成本最低、运维简单 | 隔离最弱,查询须带条件 |
| 独立 Schema | 同库不同 Schema,每租户一个 Schema | 中等隔离、逻辑清晰 | Schema 数量多时管理复杂 |
| 独立数据库 | 每租户一个独立数据库 | 最强隔离、可独立备份 | 成本最高、运维复杂 |
选型原则:小客户共享表、中客户独立 Schema、大客户独立数据库——按付费等级与合规需求分级。
2. 元数据驱动架构
- 核心:一套代码服务所有租户,差异化通过配置实现;
- 租户元数据表:存储每个租户的版本号、功能开关、配额限制、自定义配置;
- 业务代码:读取当前租户上下文(TenantContext)后决定逻辑分支或功能可见性;
- 版本升级:通过功能开关按租户灰度——先内部租户、再白名单客户、最后全量。
3. 安全隔离
- 认证隔离:每租户独立用户体系,支持自定义登录页 / SSO 对接 / LDAP 集成;
- 授权隔离:租户管理员自定义角色与权限,不同租户的"管理员"权限范围不同;
- 数据防泄漏:查询层强制注入 tenant_id 条件(框架层拦截器自动拼接),避免开发者遗漏导致跨租户数据泄露;
- 资源配额:每租户设置存储上限、API 调用频次、并发连接数,防止"吵闹邻居"影响其他租户。
4. 资源隔离
- 计算隔离:关键租户分配专属计算资源(独立线程池 / 容器),普通租户共享资源池;
- 限流:按租户维度限流,某租户流量突增不影响其他租户;
- 存储隔离:大租户的文件存独立 Bucket / 目录,按租户设置容量上限。
🔬 扩展知识
详情
- 【L3】租户上下文传递:请求入口解析 tenantId(从域名 / Header / Token 中提取),存入 ThreadLocal,全链路(Service → DAO → MQ)自动携带;DAO 层通过 MyBatis 拦截器自动拼接
WHERE tenant_id = ?,避免开发者遗漏。 - 【L3】吵闹邻居(Noisy Neighbor)防护:按租户维度限流 + 资源配额(CPU / 内存 / 连接数 / 存储空间),关键租户分配专属资源池;监控每租户的 P99 延迟与错误率,异常时自动降级该租户的非核心功能。
- 【L4】方案权衡与事故:共享表方案运维最简单但隔离最弱,曾有线上事故——某报表查询漏写
tenant_id条件,返回了全量租户数据——查询层必须框架级强制注入租户条件,不能依赖开发者手动添加。独立数据库方案隔离最强但成本最高,适合金融 / 医疗等合规场景。 - 【L4】规模化估算(500 租户、5 万 DAU、日增 10GB 数据):小租户(400 个)共享表 + 共享资源池,中租户(80 个)独立 Schema + 独立限流配额,大客户(20 个)独立数据库 + 专属计算资源;租户元数据存 Redis 缓存(TTL 5 分钟),变更通过 MQ 广播刷新。
🏭 实战场景
详情
B2B SaaS 平台:500 家企业租户、5 万日活用户、日增数据 10GB,要求租户间数据零泄漏、大客户 P99 < 200ms 不受小租户影响。
设计要点:小租户(400 家)共享数据库 + tenant_id 隔离,应用层 TenantContext 拦截器自动注入租户条件,DB 层索引按 (tenant_id, business_key) 联合索引保证查询效率;中租户(80 家)独立 Schema,满足财务审计需求;大客户(20 家)独立数据库 + 专属资源池,满足合规要求。资源管控:按租户维度令牌桶限流 + 存储配额,超限自动降级非核心功能。灰度发布:新功能先对内部租户开放,再推白名单客户,最后全量。
⚠️ 常见误区
详情
常见误区:
- ❌ "SQL 都带了 tenant_id 就安全了" → ORM 关联查询、原生 SQL、后台任务容易遗漏租户条件,必须在框架层(拦截器 / MyBatis 插件)自动注入,不能依赖开发者手动添加。
- ❌ "所有租户共享资源,省钱" → 大租户的批处理任务可能占满连接池导致小租户无法访问,必须按租户维度做限流和配额管理,必要时做计算资源隔离。
- ❌ "多租户就是多套系统部署" → 违背 SaaS 成本分摊的核心理念,应通过配置化和插件化满足定制需求,而非为每个租户独立部署。
🔀 发散问题
Q:租户数据备份恢复怎么做?
→ 共享表方案下备份通常是全库级别,恢复单租户需从全量备份中筛选(复杂且慢);独立 Schema / 独立库方案可单独备份恢复,这也是大客户选择独立部署的原因之一。
Q:如何评估一个租户是否该升级到独立部署?
→ 看几个指标:数据量超过阈值(如 100GB)、QPS 超过阈值(如 1000)、有合规要求(如金融 / 医疗)、付费等级达到某级别——满足任一条件即触发升级评估。
Q:多租户 SaaS 的计费系统有什么特殊之处?
→ 每租户计费维度与单价不同(按用户数 / API 调用量 / 存储空间等),需在租户元数据中配置计费规则,用量数据按租户维度采集,计费任务按租户隔离执行避免互相影响。
【中等】如何设计一个 API 开放平台?⭐⭐⭐⭐
🎯 目标等级:L2-L3 | ⏱ 建议用时:15 min | 🏷 标签:系统设计 / 开放平台
💎 关键结论
API 开放平台的核心是「安全 + 易用 + 可控」。身份认证用 OAuth 2.0 的应用级凭证(AppKey/AppSecret),流量管理靠 API 网关统一限流、熔断与鉴权,后端通过服务路由转发到业务服务;安全防护做请求签名、传输加密与防重放,开发者体验靠文档、SDK 与沙箱环境,商业变现靠调用计费与阶梯定价。
⚡ 记忆卡片
- 口诀:认证 OAuth、网关限流、签名防篡改、沙箱给开发
- 关键词:OAuth 2.0 / API 网关 / 请求签名 / 开发者门户 / 调用计费
- 链路:开发者注册 → 获取凭证 → 签名请求 → 网关鉴权限流 → 路由后端 → 计量计费
📖 核心知识
1. 身份认证与权限
- 应用级凭证:每个接入方分配 AppKey + AppSecret,通过 OAuth 2.0 授权码模式(用户授权)或客户端凭证模式(服务端对服务端)获取 Access Token;
- Scope 权限:细粒度权限控制,如
read:orders、write:products,接入方只能调用已授权的 API; - Token 管理:Access Token 短时效(2 小时),Refresh Token 长时效(30 天),支持主动吊销。
2. API 网关(核心组件)
- 统一入口:所有外部请求经网关,内部服务不直接暴露;
- 安全校验:签名验证(HMAC-SHA256)、HTTPS 强制、IP 白名单、参数校验防注入;
- 流量管理:多维度限流(应用级 + 接口级 + 用户级)、熔断降级(后端故障时快速失败);
- 协议转换:外部 HTTP/REST → 内部 gRPC/Dubbo,屏蔽内部协议差异;
- 日志审计:全量请求日志,支持追溯与对账。
3. 安全防护
- 请求签名:AppSecret + 请求参数 + 时间戳拼接后 HMAC-SHA256 签名,服务端验签防篡改;
- 防重放:请求带 timestamp + nonce,服务端校验时间窗口(±5 分钟)+ nonce 去重;
- 传输加密:HTTPS 强制,敏感字段(如手机号)额外 RSA 加密;
- 防注入:参数白名单校验、长度限制、特殊字符过滤。
4. 开发者体验
- 开发者门户:API 文档(OpenAPI/Swagger 自动生成)、在线调试、SDK 下载;
- 沙箱环境:独立测试环境 + 模拟数据,开发者无需对接真实业务即可调试;
- 错误码体系:统一错误码规范(如 10001 = 签名错误、20001 = 库存不足),附排查建议;
- 技术支持:工单系统 + 开发者社区 + 在线答疑。
5. 计量与计费
- 计量:每次 API 调用记录(应用 + 接口 + 时间 + 状态码),异步写入计量库;
- 计费:按调用次数阶梯定价(如 0~10 万次 0.01 元/次、10~100 万次 0.005 元/次);
- 对账:每日生成账单,支持开发者自助查询与申诉。
🔬 扩展知识
详情
- 【L3】OAuth 2.0 四种授权模式选型:授权码模式(最安全,适合 Web 应用)、客户端凭证模式(适合服务端对服务端)、密码模式(仅限第一方应用,不推荐第三方)、隐式模式(已不推荐,Token 暴露在前端)。
- 【L3】API 网关限流算法:滑动窗口(比固定窗口避免边界突发)、令牌桶(允许突发但限制总量)、漏桶(强制平滑速率)——按场景组合使用,如应用级用令牌桶、接口级用漏桶。
- 【L4】API 版本管理:URL 路径版本(/v1/、/v2/)最直观,Header 版本(Accept: application/vnd.xxx.v2+json)更优雅但调试不便;旧版本设定废弃时间表(如 6 个月后下线),新版本上线时灰度发布(10% → 50% → 100%)。
- 【L4】方案权衡与事故:曾有线上事故——某接入方 AppSecret 泄露后大量调用消耗配额,导致其他接入方被限流——AppSecret 泄露的应急预案必须提前演练,包括一键吊销 + 通知受影响方 + 自动补发新凭证。
🏭 实战场景
详情
企业开放平台:5000 个接入应用、日均 10 亿次 API 调用、峰值 QPS 10 万,要求 99.99% 可用、安全防护、精细化流量治理。
设计要点:API 网关独立集群部署(不与业务混部),Redis 集群做多维度限流计数(应用 + 接口组合粒度),OAuth 2.0 + JWT 做身份认证与细粒度权限(Scope 控制到接口级),请求签名用 HMAC-SHA256 防篡改,计量数据异步写 Kafka → Flink 实时聚合 → MySQL 落库,开发者门户提供 OpenAPI 文档 + 沙箱 + 自助排查工具。
⚠️ 常见误区
详情
常见误区:
- ❌ "网关做了限流就安全了" → 限流只控制总量,不做应用级隔离时某应用的流量洪峰仍可能影响其他应用,必须应用级 + 接口级多维度限流。
- ❌ "API 幂等性不重要,重试就行" → 网络重试可能导致重复扣款或重复下单,写接口必须做幂等(requestId 去重),网关层可统一做请求去重。
- ❌ "内部 API 直接暴露给外部" → 内部 API 的数据结构和错误码不适合外部开发者,应在内部 API 前加一层 BFF(Backend for Frontend)做协议转换与数据裁剪。
🔀 发散问题
Q:第三方应用密钥泄露如何应对?
→ 应急预案:立即吊销该应用凭证 → 通知受影响用户 → 审计日志追溯影响范围 → 补发新密钥;长期方案:短期 Token + 自动轮换机制,减少密钥暴露窗口。
Q:开放平台的计费系统如何保证不漏计?
→ 每次 API 调用异步记录到 MQ → 定时任务消费 MQ 聚合后写 DB → 对账(MQ offset vs DB count);短期用 Redis 计数器做实时限流,长期以 DB 计量为准做计费。
Q:API 网关和内部 RPC 网关有什么区别?
→ API 网关面向外部开发者,协议 HTTP/REST,重点在安全、鉴权、计费;RPC 网关面向内部微服务,协议 gRPC/Dubbo,重点在服务发现、负载均衡、链路追踪。
【困难】如何设计一个低代码平台?⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:系统设计 / 低代码
💎 关键结论
低代码平台的核心是「组件化 + 可视化 + 可渲染」:物料层提供标准化组件协议,搭建层通过可视化编辑器拖拽生成 JSON Schema,渲染层解析 Schema 并渲染为可交互页面。关键挑战是组件生态的丰富度、渲染性能、以及逻辑编排的表达力。
⚡ 记忆卡片
- 口诀:物料标准化、搭建可视化、Schema 驱动、渲染多端
- 关键词:组件协议 / JSON Schema / 可视化编辑器 / 渲染器 / 逻辑编排
- 链路:组件注册 → 可视化拖拽 → Schema 输出 → 渲染执行 → 逻辑编排
📖 核心知识
1. 组件体系(物料层)
- 组件协议:每个组件遵循统一协议,定义 props(输入属性)、events(输出事件)、methods(可调用方法)、slots(可插入位置);
- 基础组件库:按钮、输入框、表格、表单等原子组件;
- 业务组件库:用户选择器、审批流组件、图表组件等封装业务逻辑的复合组件;
- 物料市场:支持第三方组件接入,提供在线预览与一键安装。
2. 页面搭建(搭建层)
- 可视化编辑器:拖拽组件到画布,配置属性面板,设置事件绑定;
- Schema 输出:编辑器将页面结构序列化为 JSON Schema(组件树 + 属性 + 事件 + 数据绑定);
- 撤销/重做:基于操作历史栈实现,每次操作记录 diff;
- 协同编辑:多人同时编辑同一页面,需冲突解决(可参考实时协作系统的 CRDT/OT 方案)。
3. 页面渲染(渲染层)
- Schema 解析:渲染器递归遍历 Schema 树,实例化组件并注入属性与事件;
- 数据绑定:支持声明式数据绑定(
{{dataSource.field}}),数据变更自动触发组件重渲染; - 多端适配:同一 Schema 可被不同渲染器解析——Web 端用 Virtual DOM、小程序端用模板引擎、Native 端用原生视图。
4. 逻辑编排
- 可视化流程编排:拖拽式流程图,支持条件分支、循环、异步调用、定时触发;
- 表达式引擎:支持简单逻辑(如
{{price * count}}),复杂逻辑用自定义 DSL 或 JS 沙箱执行; - 内置函数库:常用操作(数据请求、表单校验、消息提示)封装为内置动作,用户直接调用。
5. 数据层
- 数据模型定义:通过 Schema 定义数据结构,自动生成 CRUD 接口;
- 数据源适配:支持对接 REST API、GraphQL、数据库等多种后端;
- 表单与数据联动:声明式绑定 + 校验规则 + 联动逻辑(如"省"变更自动加载"市"列表)。
6. 扩展性设计
- 自定义组件:用户可开发私有组件接入平台;
- 自定义渲染器:支持新终端(如 IoT 设备屏幕)接入;
- 插件机制:编译时插件(修改 Schema)+ 运行时插件(拦截渲染过程);
- OpenAPI:平台的组件管理、应用发布等能力开放给外部系统。
🔬 扩展知识
详情
- 【L3】Schema 设计的关键决策:组件嵌套用树形结构(parent-children),数据绑定用表达式引用(
{{model.field}}),事件绑定用动作列表(onClick → [setVariable, requestAPI]);Schema 版本化(v1/v2)保证旧页面在新版平台仍可渲染。 - 【L3】渲染性能优化:Schema 节点过多(>1000)时渲染卡顿,优化手段包括虚拟列表(只渲染可见区域)、懒加载(滚动到视口时才渲染)、增量更新(只更新变更的子树而非整页重渲染)。
- 【L4】方案权衡:低代码平台的核心竞争力不在编辑器(编辑器是交互层,可替换),而在组件生态(物料丰富度决定平台价值)和渲染性能(大页面不卡顿是用户体验底线)。曾有线上案例:某低代码平台组件库只有 30 个基础组件,用户不得不大量使用"自定义代码块",低代码退化为 ProCode——物料丰富度是低代码平台的生命线。
🏭 实战场景
详情
企业级低代码平台:支撑 2000 个内部应用、300 个组件、50 个租户,日活用户 3 万。
设计要点:组件协议标准化(props/events/methods/slots 五要素),团队基于协议开发组件并接入物料市场;渲染层采用 Virtual DOM + 增量更新,长列表用虚拟滚动(只渲染可视区域 20 条),大数据表格用虚拟列渲染;逻辑编排用可视化流程编辑器 + 自定义表达式引擎(沙箱执行 JS 子集,限制执行时间防死循环)。
⚠️ 常见误区
详情
常见误区:
- ❌ "低代码平台不需要开发者" → 低代码降低的是重复劳动的门槛,复杂业务逻辑仍需专业开发者编排;定位是"让开发者聚焦业务而非重复造轮子"。
- ❌ "低代码可以替代所有开发" → 低代码适合中后台、表单、流程等标准化场景,复杂交互(如游戏、设计工具)不适合,过度追求"万能"会导致平台臃肿且体验差。
- ❌ "编辑器最重要,做好编辑器就行" → 编辑器只是交互入口,组件协议才是生态基础——协议决定了组件能否被编辑器识别、渲染器渲染、逻辑引擎调用,协议设计不好,生态无法扩展。
🔀 发散问题
Q:低代码和 ProCode 的边界怎么划分?
→ 一般规律:表单 / 表格 / 流程等 CRUD 场景用低代码,复杂交互 / 定制化需求用 ProCode;边界不是固定的,随着组件能力增强,低代码能覆盖的场景会扩大。
Q:组件协议应该包含哪些核心字段?
→ 最少五个:name(组件标识)、props(输入属性定义)、events(输出事件定义)、methods(可调用方法)、slots(可插入位置);props 定义"组件长什么样",events 定义"组件能通知什么",methods 定义"外部能控制什么"。
Q:低代码平台的渲染性能瓶颈在哪?
→ 主要在 Schema 树的递归渲染——节点数超过千级时容易卡顿,优化手段:虚拟列表(只渲染可见区域)、增量渲染(只更新变更子树)、Web Worker(将 Schema 解析放到 Worker 线程避免阻塞主线程)。
【困难】如何设计一个实时协作系统?⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:系统设计 / 协作
💎 关键结论
实时协作系统的核心是「最终一致性 + 低延迟同步」:用 CRDT 或 OT 算法解决多端并发编辑的冲突,WebSocket 长连接实现毫秒级消息广播,在线状态(presence)管理用户的"谁在线/光标在哪"信息,冲突解决依赖向量时钟或 Lamport 时间戳定序。
⚡ 记忆卡片
- 口诀:CRDT 合、WebSocket 推、presence 显、向量钟定序
- 关键词:CRDT/OT / WebSocket / presence / 向量时钟 / 最终一致性
- 链路:编辑操作 → CRDT/OT 转换 → WebSocket 广播 → 客户端合并渲染 → 离线缓存上线同步
📖 核心知识
1. 协同算法选型
| 算法 | 原理 | 优势 | 劣势 |
|---|---|---|---|
| OT | 操作变换,中心服务器协调操作顺序 | 成熟(Google Docs 采用) | 依赖中心服务器,实现复杂 |
| CRDT | 无冲突复制数据类型,每个节点独立运算合并 | 适合 P2P / 离线优先 | 实现复杂,元数据开销大 |
- OT(Operational Transformation):适合有中心服务器的场景,中心服务器做操作变换保证一致性;
- CRDT(Conflict-free Replicated Data Type):适合 P2P 或弱网场景,每个节点可独立运算合并,无需中心仲裁。
2. 实时通信
- WebSocket 长连接:全双工通信,毫秒级延迟;
- 消息协议:自定义二进制协议(如 Protocol Buffers)减少带宽,或 JSON(开发效率高);
- 消息类型:编辑操作(insert/delete/update)、光标移动、presence 更新、ACK 确认。
3. 在线状态(Presence)
- 在线列表:显示当前文档/房间的所有在线用户;
- 光标同步:实时显示其他用户的光标位置与选区;
- 实现:每个客户端定时上报心跳 + 光标位置,服务端广播给所有协作者;用户离开时服务端通知移除。
4. 冲突解决
- 向量时钟:每个节点维护版本号数组,用于判断事件的因果关系(先于/后于/并发);
- Lamport 时间戳:逻辑时钟,保证全序但可能误判并发关系;
- 最后写入胜出(LWW):简单但可能丢数据,适合低冲突场景。
5. 离线支持
- 本地缓存:离线时操作存 IndexedDB / LocalStorage;
- 上线同步:重连后按时间顺序回放本地操作,CRDT 自动合并无冲突,有冲突需用户手动解决;
- 冲突提示:合并后如存在语义冲突(如两人同时修改同一段文字),高亮提示用户选择。
🔬 扩展知识
详情
- 【L3】OT vs CRDT 的选型决策:有中心服务器且需要强控制(如审计日志)选 OT(如 Google Docs);P2P / 弱网 / 离线优先选 CRDT(如 Figma);CRDT 的实现复杂度更高但去中心化特性适合现代分布式架构。
- 【L3】WebSocket 网关设计:连接管理(userId → 连接映射)、消息路由(找到目标用户所在网关节点)、跨节点广播(Redis Pub/Sub 或 Kafka);水平扩容时网关节点无状态,连接映射存 Redis。
- 【L4】向量时钟 vs Lamport 时间戳:向量时钟能准确判断"并发"关系(两个事件互不知晓对方),Lamport 时间戳只能给出全序但可能将并发的两个事件排成先后——代价是向量时钟的空间开销随节点数线性增长。
🏭 实战场景
详情
在线文档编辑器:支持 100 人同时编辑同一文档,同步延迟 < 1 秒,要求 99.9% 可用、支持离线编辑。
设计要点:协同算法用 CRDT(如 Yjs 库的 YXmlText 类型),每个客户端独立运算合并无需中心仲裁;WebSocket 长连接 + 心跳保活(30 秒一次),断线时本地缓存操作(IndexedDB),上线后批量同步;presence 服务用 Redis Hash 存储每个文档的在线用户列表与光标位置,Pub/Sub 广播变更。
⚠️ 常见误区
详情
常见误区:
- ❌ "OT 比 CRDT 成熟,一定选 OT" → 选择取决于部署模式:有中心服务器且需强控制选 OT,P2P 或弱网选 CRDT;CRDT 在 Figma、Yjs 等产品中已验证可用。
- ❌ "实时协作必须强一致" → 大多数协作场景最终一致即可,强一致意味着每次操作都要等网络往返,体验极差;应优先保证本地操作即时反馈(乐观更新),再异步同步。
- ❌ "WebSocket 断线重连后全量同步最简单" → 文档大时全量同步带宽消耗巨大,应记录版本号(或操作日志位点),断线重连后只同步增量(从上次版本号到最新)。
🔀 发散问题
Q:Google Docs 和 Figma 的协作方案有什么区别?
→ Google Docs 用 OT 算法,需要中心服务器协调操作顺序;Figma 用 CRDT 变体,每个客户端可独立运算合并,离线支持更好。
Q:大规模协作(如千人同时在线)怎么优化?
→ 分区广播(只广播给关注同一区域的用户,如文档的同一章节)+ 操作合并(短时间内的多个操作合并为一条消息减少广播量)。
Q:离线编辑冲突如何处理?
→ CRDT 能自动合并无冲突的操作(如两人编辑不同段落),有语义冲突时(如两人同时修改同一段文字)需用户手动选择保留哪个版本,提供版本对比 UI 辅助决策。
架构模式
【困难】如何设计一个高并发系统?⭐⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:架构设计 / 高并发
💎 关键结论
高并发设计没有银弹,核心方法论是:尽量减少请求、让请求更快、把压力摆平,可归纳为六字诀——缓、异、池、拆、预、水。最有效的优化是把请求消灭在入口(缓存与前端拦截),其次异步化摆平峰值;选型前必须先逐层量化每一层承受的压力,再选手段。
⚡ 记忆卡片
- 口诀:能挡就挡(缓存),能异步就异步,能拆就拆,先量化再选型
- 关键词:多级缓存 / MQ 削峰 / 池化 / 无状态拆分 / 预计算 / 水平扩容
- 链路:减少请求 → 异步摆平 → 池化复用 → 拆分散压 → 预计算 → 扩容兜底
📖 核心知识
高并发设计可归纳为六字诀:缓、异、池、拆、预、水。
一、减少请求(最有效的优化)
- 前端拦截:静态化 + CDN、按钮防重、本地缓存;秒杀场景 99% 请求应在到达后端前被拦截。
- 多级缓存:浏览器缓存 → CDN → 网关缓存 → 本地缓存(Caffeine)→ 分布式缓存(Redis),层层挡住读流量。
- 读写分离:主库写、从库读;读多写少的系统收益最大。
二、异步化(把同步变异步,把峰值摆平)
- MQ 削峰填谷:下单、发短信、发积分等非核心链路异步化。
- 同步调用链能并行就并行(CompletableFuture 聚合多下游)。
三、池化与复用:线程池、连接池、对象池,避免频繁创建销毁的资源开销。
四、拆分(水平扩展的前提)
- 服务拆分:无状态化才能随意水平扩容;有状态部分外置(Session、计数器进 Redis)。
- 数据拆分:分库分表打散写入热点;热点数据单独隔离部署。
五、预计算/预加载:提前算好结果(如大促前预热缓存、提前生成静态页),把实时计算变为查表。
六、水平扩容 + 容量水位:无状态服务按需扩容,配合限流兜底;日常水位控制在 50%~60%,给突发留余量。
量化示例:某读接口 10w QPS,多级缓存命中率 95% 后仅 5k 打到 DB;写接口 1w QPS 经 MQ 削峰后按 2k/s 平滑消费——先算清楚每一层要承受多少压力,再选手段。
🔬 扩展知识
详情
- 【L3】系统做到什么程度算"扛住了"?给出三层数字:容量(单机 1500 QPS × 20 台 × 60% 水位 ≈ 1.8 万安全 QPS)、实测(全链路压测拐点值)、余量(目标流量的 2 倍以上)。汇报口径是"可承载 X 倍峰值,瓶颈在 Y,扩容弹性为 Z"。
- 【L3】优化手段中哪类收益最大、哪类最容易翻车?收益最大的是缓存与前端拦截(把请求消灭在入口,量级削减);最易翻车的是异步化与分库分表——异步引入一致性/积压问题,分库分表引入跨片查询与扩容困难,都要有配套兜底方案才敢上。
- 【L4】无状态化改造的具体做法?Session/登录态、计数器、本地文件、定时任务锁都要外置到 Redis/调度平台;本地缓存可保留但只做加速副本。判断标准:任意实例被随机杀掉,用户请求不受影响,即为无状态。
- 【L4】全链路压测与容量常态化运营:生产环境压测依赖流量染色(压测流量打标)+ 影子库/影子表(压测写落影子存储,不污染生产数据)+ 第三方通道 Mock;压测数据需可构造、可清理。容量评估应做成持续运营体系——容量水位看板、变更前容量验证卡点、扩缩容联动,而不是大促前的一次性压测。
🏭 实战场景
详情
失效场景与踩坑:缓存命中率一旦从 95% 跌到 50%(如缓存集群故障),DB 流量翻倍以上,未做限流兜底会直接雪崩——缓存是最脆弱的依赖,必须有降级预案;MQ 削峰的前提是消费端能消化,消费速度 < 生产速度时积压会反噬(磁盘写满、重投风暴)。某次大促因未对缓存击穿做兜底,单热点 key 过期瞬间数万 QPS 穿透到 DB,接口全面超时——热点数据必须永不过期或互斥重建。
场景:大促活动页峰值 20 万 QPS 查询活动商品信息,DB 单实例极限 5000 QPS,现有预算只允许加 10 台应用服务器。方案:静态页 + CDN 挡掉约 95% 读流量,回源约 1 万 QPS;应用层本地缓存(Caffeine,TTL 1~5s)再挡 80%,打到 Redis 约 2000 QPS,Redis 单实例 8~10 万 QPS 完全可扛;DB 仅在缓存故障兜底,前置限流 3000 QPS 保护。10 台服务器单机只需承担约 2 万 QPS 的纯内存计算 + 缓存访问,4C8G 即可。核心是逐层量化漏斗,而不是堆机器。
⚠️ 常见误区
详情
常见误区:
- ❌ "高并发就是加机器" → 不先做缓存/异步减少请求量,堆机器只是线性成本换线性容量,瓶颈层(如 DB)依然先挂。
- ❌ "上了缓存就万事大吉" → 缓存命中率骤降时流量全打到 DB,必须配限流与降级预案。
- ❌ "MQ 削峰能解决一切写压力" → 消费速度跟不上生产速度时积压反噬(磁盘写满、重投风暴),削峰的前提是消费端能消化。
🔀 发散问题
Q:限流、熔断、降级在高并发体系中如何配合?
→ 限流挡超量、熔断防故障扩散、降级保核心,阈值必须来自压测容量,见「如何实现流量控制」。
Q:高并发系统的容量如何评估与验证?
→ 从业务指标倒推峰值 QPS,全链路压测找拐点,见「如何做系统容量评估与压测」。
Q:大促后服务重启会不会引发重连洪峰?
→ 客户端退避抖动 + 服务端渐进放量协同解决,见「服务重启时,如何避免客户端重连引发的流量洪峰」。
【困难】如何设计异地多活/容灾架构?⭐⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:架构设计 / 容灾多活
💎 关键结论
容灾按等级演进:冷备 → 同城双活 → 异地多活,核心指标是 RTO(多久恢复)与 RPO(丢多少数据)。异地多活的根本难点是跨城同步延迟,解法是单元化——按用户维度把流量和数据封闭在单元内闭环,只异步同步少量全局数据。实践上先同城双活、再异地冷备、最后按核心链路单元化;没演练过的容灾等于没有容灾。
⚡ 记忆卡片
- 口诀:单元闭环写,全局单点写,容量 N/(N-1),演练才作数
- 关键词:RTO / RPO / 单元化 / GSLB / 切流演练
- 链路:冷备 → 同城双活 → 异地多活 → 单元化闭环 → 定期切流演练
📖 核心知识
容灾等级与指标
| 等级 | 形态 | RTO/RPO |
|---|---|---|
| 冷备 | 数据备份,手动恢复 | 小时级 |
| 同城双活 | 两机房同时服务 | 分钟级,RPO ≈ 0 |
| 异地多活 | 多城市机房同时服务 | 秒级切换,RPO 极小 |
- RTO(恢复时间目标):故障后多久恢复服务;RPO(恢复点目标):允许丢多少数据。
同城双活:两机房网络延迟低(<2ms),数据库一主一从或双主(MGR),应用无状态双部署,负载均衡按机房分流;单机房故障秒级切流。
异地多活的核心难点与设计
- 数据同步延迟:跨城延迟 30ms+,异步同步必然存在延迟窗口。解法:单元化(Set 化)——按用户维度(如 userId 取模)把流量和数据封闭在单个单元内闭环,单元间只异步同步少量全局数据,从根本上避免跨单元写冲突。
- 流量调度:DNS/GSLB + 网关层按路由规则(userId hash)把请求导入对应单元;切流能力需分钟级生效。
- 全局数据一致性:配置、商品等全局数据用"单点写 + 多单元读"或同步双写。
- 容量规划:N 个单元需承担 (N/(N-1)) 倍容量(挂一个后其余能承接全量),通常按 N+1 冗余。
实践建议:不要一步到位——先同城双活,再异地冷备,最后按核心链路逐步单元化;定期切流演练,没演练过的容灾等于没有容灾。
方案权衡:异地多活的成本是指数级上升的(多套机房、多套数据同步链路、单元化改造人力),绝大多数业务做到同城双活 + 异地冷备即可;只有金融级合规或超大流量平台才值得全量单元化。代价:写路径变长(跨单元同步 30ms+)、容量冗余 N/(N-1)、全局数据改造复杂。
🔬 扩展知识
详情
- 【L3】单元化改造中,哪些数据最难闭环?全局共享且高频写的数据最难(如全局库存、号段、配置)。常见解法:库存按单元预分配(各单元持有份额,单元间余量调拨);号段按单元分配不重叠区间;配置走单点写多单元读。
- 【L4】RPO=0 和 RTO=0 能否同时做到?同城双活 + 同步复制可接近 RPO=0,但同步复制引入写延迟(跨机房 1~2ms RTT)且一机房网络抖动会拖慢所有写;RTO=0 需流量自动调度 + 无状态秒级接管,代价是常驻双倍容量。异地物理距离决定 RPO 无法为 0,只能靠业务补偿。
- 【L4】如何验证容灾方案真的有效?定期真实切流演练(生产环境小流量→全量)、混沌工程注入机房级故障、演练恢复时长并量化 RTO/RPO 实际值与目标差距;演练结果纳入容量与预案持续改进。
- 【L4】重试风暴防放大:机房故障切流期间,全链路的超时重试会把流量放大数倍(重试风暴),需预算化重试(限制重试流量占比)+ 指数退避带抖动 + 熔断快速失败,否则切流本身引发二次雪崩。机房级故障的工程路径普遍要求"1 分钟发现、5 分钟定位、10 分钟恢复"(1-5-10,业界通用口径),依赖全链路监控 + 预案自动化,而非人工救火。
🏭 实战场景
详情
失效场景与踩坑:DNS 切流依赖 TTL(分钟级),故障初期仍有流量打到坏机房,需网关层秒级切流配合;跨城异步同步必然有延迟窗口,故障切换瞬间可能丢最近几秒数据(RPO>0)——资金类数据需业务层对账补偿。曾有大厂演练时切流成功,但依赖的第三方服务不支持多活,切流后核心链路调第三方全失败——容灾方案必须覆盖所有外部依赖。
场景:支付平台日交易 500 万笔,监管要求 RTO ≤ 5 分钟、RPO ≤ 30 秒,预算只够两地三中心(同城两机房 + 异地一机房)。方案:同城两机房做双活(<2ms 延迟支持同步/半同步复制,RPO≈0),承担日常全部流量;异地机房异步复制(延迟窗口通常秒级,满足 RPO≤30s)+ 定期全量备份,平时只读引流少量验证流量。同城单机房故障由负载均衡秒级切流(RTO<1 分钟);同城双毁时切异地,容忍最多 30 秒未同步交易,配合日终渠道对账 + 人工补单兜底资损。预算约束下的核心权衡:把钱花在同城高可用(高频故障),异地保底(低频灾难)。
⚠️ 常见误区
详情
常见误区:
- ❌ "做了异地多活就不会丢数据" → 跨城异步同步必有延迟窗口,切换瞬间 RPO>0,资金类必须业务层对账补偿。
- ❌ "切流演练过一次就行" → 依赖会持续变化(新增第三方、新服务),必须常态化演练,没演练过的预案等于没有。
- ❌ "容灾方案覆盖自己的系统就够了" → 外部依赖不支持多活时,切流后核心链路照样全挂,方案必须覆盖所有依赖方。
🔀 发散问题
Q:机房级容灾与高可用设计是什么关系?
→ 多活是高可用"冗余消单点"在机房级的延伸,见「如何设计一个高可用系统」。
Q:多活下的全局唯一 ID 怎么分配?
→ 号段按单元分配不重叠区间,机器 ID 自动化分配,见「如何设计一个分布式 ID 发号器」。
数据密集
【困难】如何设计一个搜索引擎?⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:25 min | 🏷 标签:搜索 / 架构
💎 关键结论
搜索引擎三大核心:索引构建(分词→倒排索引)、查询处理(分词→布尔/向量检索→打分排序)、结果展示(摘要高亮+分页)。大规模系统需分布式索引(Shard)+ 副本(Replica);Google 的三驾马车是 GFS/MapReduce/Bigtable。
⚡ 记忆卡片
- 口诀:分词建倒排,查询走打分,分布靠分片
- 关键词:倒排索引 / TF-IDF / BM25 / Shard+Replica
- 链路:文档 → 分词 → 构建倒排索引 → 查询分词 → 检索+打分 → 排序+摘要 → 返回
📖 核心知识
- 倒排索引:Term → PostingList(docId, tf, positions);支持布尔查询(AND/OR/NOT 取交集/并集/差集)。
- 相关性打分:TF-IDF(词频-逆文档频率)→ BM25(TF 饱和+文档长度归一化);现代搜索引擎用 Learning-to-Rank。
- 分布式架构:索引按 Shard 水平分片;每个 Shard 有 Replica 保证高可用;Coordinator 节点聚合各 Shard 结果。
- 近实时搜索:NRT(Near Real Time)——写入先入内存 Segment,refresh(默认 1s)后变为可搜索的 Segment。
🔬 扩展知识
详情
- 【L3】选型决策:通用业务搜索直接选 Elasticsearch(倒排索引 + 分布式分片副本 + 生态齐全),自建只在有特殊打分逻辑、超大规模成本敏感等强定制需求时才考虑;自建的代价是重造分片路由、副本容错、refresh/merge 机制,维护成本极高——"为什么选 ES、什么情况下换掉"是本题的决策论证层。
- 【L4】写入与查询的调优权衡:refresh_interval 调大(如 30s)提升写吞吐但牺牲可见时效;Segment 合并(merge)与查询争抢 IO,写高峰需限流;副本数换读容量但放大写与存储成本。
- 【L4】相关性演进:BM25 静态打分 → LTR 用点击日志做训练样本 → 语义向量召回(双塔 + ANN)补足字面匹配盲区;混合检索(字面 + 向量)是当前主流形态。
⚠️ 常见误区
详情
常见误区:
- ❌ "LIKE '%关键词%' 就能当搜索用" → 前置通配符无法利用 B+ 树索引,全表扫描且没有分词与相关性打分,数据量稍大必须换倒排索引。
- ❌ "ES 开箱即用不需要容量规划" → 分片数需按数据量与写入吞吐预先规划,单分片过大恢复/迁移慢,分片过碎集群元数据压力大,两头都是坑。
【困难】如何设计一个自动补全系统?⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:20 min | 🏷 标签:搜索 / 自动补全
💎 关键结论
自动补全的核心数据结构是 Trie(前缀树)+ 优先队列。用户每输入一个字符,沿 Trie 下探找到匹配前缀的所有候选,按热度/权重排序取 Top-K。大规模系统用分布式 Trie 或 FST(Finite State Transducer)压缩内存。
⚡ 记忆卡片
- 口诀:前缀树找候选,热度排 Top-K
- 关键词:Trie / FST / Top-K / 实时索引
- 链路:用户输入 → Trie 前缀匹配 → 候选按热度排序 → 返回 Top-K → 用户继续输入重复
📖 核心知识
- Trie 结构:每个节点是一个字符;从根到叶的路径是一个完整词;每个节点维护 children 映射和 isEnd 标记。
- Top-K 优化:每个 Trie 节点缓存以该前缀开头的 Top-10 热词;更新时用优先队列维护。
- 容错处理:拼写纠错(编辑距离 ≤2 的候选);同义词扩展("手机" → "移动电话")。
- 工程挑战:内存优化——FST 比 Trie 省 10 倍内存;实时更新——增量构建 + 热备切换。
🔬 扩展知识
详情
- 【L3】FST vs Trie 权衡:FST 前后缀共享大幅压缩内存(Lucene term 字典即用 FST),代价是查询需解压更慢、只能整体构建不能单条增量——实时热词需"FST 全量 + 内存增量层"双结构合并查询。
- 【L4】热度实时更新链路:行为日志(曝光/点击)→ 流式计算按窗口聚合词热度 → 周期性重建或增量合并索引 → 双 buffer 热切换;热度需带时间衰减,否则旧热词长期霸榜。
【困难】如何设计一个推荐系统?⭐⭐⭐⭐
🎯 目标等级:L4 | ⏱ 建议用时:25 min | 🏷 标签:推荐 / 架构
💎 关键结论
推荐系统经典三段式:召回(候选集从百万→千)→ 排序(千→百,精排模型)→ 重排(百→展示,业务规则+多样性)。召回用协同过滤/向量检索;排序用 GBDT/LR/DeepFM;重排去重、打散、插入广告。
⚡ 记忆卡片
- 口诀:召回粗筛千选一,精排打分百留十,重排打散保多样
- 关键词:召回 / 排序 / 重排 / 协同过滤 / DeepFM
- 链路:用户行为 → 召回(CF/向量) → 粗排 → 精排模型打分 → 重排(多样性+业务规则) → 展示
📖 核心知识
- 召回策略:① 基于用户 CF(找相似用户喜欢的);② 基于物品 CF(找相似物品);③ 向量召回(双塔模型+ANN 检索);④ 标签/热度召回。
- 排序模型演进:LR → FM → DeepFM → DIN(注意力机制)→ 多目标优化(MMOE)。
- 冷启动:用户冷启动——用注册信息/设备信息/热门兜底;物品冷启动——Bandit 探索(UCB/Thompson Sampling)。
- 评估指标:离线 AUC/NDCG;在线 CTR/CVR/人均观看时长。
🔬 扩展知识
详情
- 【L3】分层漏斗的本质是延迟预算分配:召回在几十 ms 内从百万粗筛到千,精排单候选打分成本最高所以只处理百级候选;每加一层都是用算力换候选规模,层数与候选量按端到端延迟预算反推。
- 【L4】在线离线一致性:训练特征(离线批处理)与在线打分特征(实时拉取)口径漂移会导致"离线 AUC 涨、线上不涨",需特征快照回流——把线上打分实际使用的特征记录下来作为训练样本。
- 【L4】工程兜底与实验体系:推荐服务超时必须降级为热门榜/运营榜,不能阻塞页面;A/B 分流与指标归因是排序策略迭代的前提,没有实验平台的推荐系统无法证明改动有效。
⚠️ 常见误区
详情
常见误区:
- ❌ "推荐系统 = 训练一个大模型" → 工程上是召回/排序/重排流水线 + 特征体系 + 实验平台,模型只是其中一环,数据链路与降级设计同样决定成败。
- ❌ "单目标把 CTR 做到最高就行" → 会催生标题党与信息茧房,需多目标融合(时长/互动/多样性)并在重排层打散。
【困难】如何设计一个搜索结果排序系统?⭐⭐⭐
🎯 目标等级:L4 | ⏱ 建议用时:20 min | 🏷 标签:搜索 / Ranking
💎 关键结论
搜索排序从规则到学习的演进:BM25 文本相关性 → 特征工程+LR → GBDT+LR → Deep Learning(DIN/DIEN)。核心是 Learning-to-Rank(LTR):Pointwise(回归/分类)、Pairwise(排序对比较)、Listwise(直接优化 NDCG)。
⚡ 记忆卡片
- 口诀:相关是基础,特征定高低,学习排顺序
- 关键词:BM25 / LTR / Pointwise/Pairwise/Listwise / 多目标融合
- 链路:查询+文档 → 提取特征 → 模型打分 → 多目标融合(相关+新鲜+权威) → 排序输出
📖 核心知识
- 特征体系:查询相关性特征(BM25/语义向量相似度);文档质量特征(PageRank/点击率);用户特征(历史偏好/地域)。
- LTR 三范式:Pointwise(每个文档独立打分);Pairwise(文档对偏序,如 RankSVM);Listwise(整个列表最优,如 LambdaMART)。
- 多目标融合:相关性 × 时效性 × 权威性 × 商业价值;用线性加权或 Pareto 最优。
- 在线学习:实时反馈(点击/跳过)更新模型;Bandit 算法平衡探索与利用。
🔬 扩展知识
详情
- 【L3】工程落地视角(Java 后端侧):特征服务实时拉取须在延迟预算内完成,模型推理服务与业务解耦独立部署,打分结果可缓存复用;LambdaMART(基于 GBDT 的 Listwise 方法)是深度模型之前的主流选择,中小场景至今仍广泛使用。
- 【L4】多目标融合权重怎么定:人工拍权重 → 基于线上 A/B 实验调优 → 自动调参;融合公式变更必须灰度放量,直接全量会让指标波动无法归因。
【困难】如何实现分布式搜索?⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:20 min | 🏷 标签:搜索 / 分布式
💎 关键结论
分布式搜索的核心是索引分片 + 查询聚合。索引按 Shard 水平切分(按 docId hash 或路由字段);查询时 Coordinator 广播到所有 Shard,各 Shard 本地排序后返回 Top-N,Coordinator 全局归并排序。
⚡ 记忆卡片
- 口诀:索引分片存,查询广播聚,归并排全局
- 关键词:Shard / Coordinator / Scatter-Gather / 深分页代价
- 链路:查询 → Coordinator 广播到 N 个 Shard → 各 Shard 本地排序返回 Top-N → Coordinator 全局归并
📖 核心知识
- 分片策略:按 docId hash 均匀分布;或按路由字段(如 tenant_id)将相关数据集中到同一 Shard。
- 查询两阶段:Query Phase(各 Shard 返回 docId+score)→ Fetch Phase(Coordinator 按 docId 去对应 Shard 取完整文档)。
- 深分页问题:from=10000 size=10 需每个 Shard 返回 10010 条,Coordinator 归并 10010×Shard 数;解决方案:search_after + 滚动。
- 一致性:写入后 refresh(默认 1s)才可见;强一致场景用 GET by ID(实时获取,走 translog)。
🔬 扩展知识
详情
- 【L3】分片数规划:单分片建议控制在几十 GB 量级(ES 官方经验区间约 10~50GB)——分片过大故障恢复与迁移慢,过碎则集群状态元数据压力大;总分片数 = 数据量 / 单分片容量,并预留增长。
- 【L4】可用性与成本权衡:分片故障会让整体查询降级,副本保高可用但写放大与存储翻倍;多机房部署时考虑查询路由亲和(同机房副本优先),避免跨机房 Scatter-Gather 放大延迟。
【困难】如何设计一个实时热搜/趋势系统?⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:20 min | 🏷 标签:搜索 / 实时
💎 关键结论
实时热搜 = 流式聚合 + 时间衰减 + 去噪。数据流:用户行为 → Kafka → Flink/Spark Streaming 按时间窗口聚合关键词频次 → 时间衰减打分(新词加分、老词降权)→ 去重去噪(同义词合并、低质过滤)→ 输出 Top-50 榜单。
⚡ 记忆卡片
- 口诀:行为入流聚合快,时间衰减去噪快
- 关键词:流式聚合 / 时间窗口 / 衰减函数 / 去噪
- 链路:用户行为 → Kafka → 流引擎窗口聚合 → 衰减打分 → 去重去噪 → Top-50 榜单
📖 核心知识
- 聚合策略:滑动时间窗口(最近 1h/6h/24h);多粒度聚合(分钟级实时+小时级趋势)。
- 趋势算法:① 简单频次排名;② 时间衰减(score = count × decay_factor^age);③ Twitter 算法(对比当前频次与历史基线的偏差)。
- 去噪:停用词过滤;同义词合并("iPhone16"="苹果16");防刷(单用户/单 IP 频次上限)。
- 工程架构:Kafka(缓冲)→ Flink(窗口聚合)→ Redis(存 Top-N 榜单)→ CDN 缓存(前端读取)。
🔬 扩展知识
详情
- 【L3】衰减与趋势算法选型:指数衰减(count × decay^age)实现简单、榜单平滑;对比历史基线偏差(Twitter 式 Trends)能识别"突然变热"的新词——两者可加权组合,兼顾持续热度与突发热点。
- 【L4】防刷对抗:榜单是公开舆论入口,被刷代价高——单用户/单设备频次上限、新注册账号降权、异常突增词先进人工复核再上榜;词库与阈值需随对抗持续迭代。
【困难】如何设计一个内容安全审核系统?⭐⭐⭐⭐
🎯 目标等级:L3-L4 | ⏱ 建议用时:20 min | 🏷 标签:搜索 / 安全
💎 关键结论
内容审核是多层过滤管线:① 规则层(关键词/正则/黑名单,毫秒级)→ ② 模型层(文本分类/图像识别/NLP 模型,百毫秒级)→ ③ 人工层(模型不确定的转人工复核)。核心指标:召回率 > 准确率(宁可误杀不可漏放)。
⚡ 记忆卡片
- 口诀:规则快筛模型判,不确定的人工看
- 关键词:多层管线 / 规则+模型+人工 / 召回优先 / Aho-Corasick
- 链路:内容输入 → 规则快筛 → 模型打分 → 置信度高直接放行/拦截 → 中间地带转人工
📖 核心知识
- 文本审核:关键词匹配用 Aho-Corasick 多模式匹配(一次扫描匹配所有关键词);变体对抗(谐音/拆字/拼音)用模糊匹配+模型。
- 图像审核:CNN 分类器(涉黄/暴恐/广告);OCR 提取图中文字再过文本审核;以图搜图(感知 hash)比对已知违规图。
- 性能要求:同步审核 <200ms(影响用户体验);大批量异步审核(如历史数据回扫)。
- 运营闭环:误判申诉 → 标注回流 → 模型迭代;关键词库热更新;审核策略 A/B 测试。
🔬 扩展知识
详情
- 【L3】审核时机选型:先审后发(安全但有审核延迟)vs 先发后审(时效强但违规内容短暂可见);UGC 高时效场景多用"先发后审 + 高风险类目先审后发"的混合策略,按内容风险分级配置。
- 【L4】置信度分层运营:高置信拦截 / 高置信放行全自动,只有中间地带转人工——人工复核区间的宽窄直接决定成本与漏放率的平衡,阈值需按申诉率与抽检漏放率动态校准。
- 【L4】对抗性演进:变体(谐音/拆字/emoji 插入)迭代极快,关键词库热更新 + 对抗样本回流再训练是常态;审核系统是持续运营的对抗体系,不是一次性交付的管线。
【困难】如何设计一个消息推送系统(千万级用户)?⭐⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:15 min | 🏷 标签:场景设计 / 系统设计
💎 关键结论
整体链路:任务调度 → 人群圈选 → 消息生产 → MQ 削峰 → 分通道发送集群 → 状态回传与统计。关键四件事:分片并行提吞吐、幂等键防重发、限流与重试保通道、频控免打扰保合规。千万用户 5 分钟触达 ≈ 3.3 万条/秒,必须批量接口 + 多通道并行。
⚡ 记忆卡片
- 口诀:圈人分片投 MQ,分道限速批量发,幂等防重退避重,频控免扰状态收
- 关键词:人群圈选 / MQ 削峰 / 幂等键 / 限流重试 / 频控
- 链路:任务调度 → 圈选分片 → MQ 削峰 → 分通道发送 → 回执统计
📖 核心知识
需求拆解:千万级用户在指定时间收到 Push/短信/站内信,分钟级触达,不重不漏。
整体架构:任务调度 → 人群圈选 → 消息生产 → MQ 削峰 → 发送集群(分通道)→ 状态回传与统计。
核心设计
- 人群圈选:定时任务扫描(索引 expire_date)或用圈人服务(标签/位图)产出目标用户列表,分片存储(如按 userId hash 切 1000 片)。
- 削峰与并发:目标用户 ID 分片写入 MQ,发送集群多实例并行消费;按通道(iOS/Android/短信)分队列,限速保护第三方通道配额。
- 防重与幂等:任务 ID + 用户 ID 作为幂等键(Redis SETNX 或 DB 唯一索引),任务重跑不重复推送。
- 失败重试:发送失败进重试队列,指数退避重试 3 次,仍失败进死信队列人工介入;短信通道失败可自动切换备用通道。
- 防骚扰与合规:全局频控(单用户单日推送上限)、免打扰时段过滤、退订名单过滤。
- 状态闭环:记录送达/点击回执,实时统计触达率,异常骤降触发告警熔断。
量化:千万用户 / 5 分钟送达 ≈ 3.3 万条/秒,需多通道并行 + 批量接口(如每批 100 条);发送集群按通道配额反推实例数。
🏭 实战场景
详情
营销推送实战:晚 8 点大促开抢前给 1000 万目标用户发 Push。圈选服务按标签位图产出人群,切 1000 片投 MQ;发送集群 20 实例、按 APNs/厂商通道分队列,单通道按其 QPS 配额限速(如每通道 5000 QPS,4 通道即 2 万/秒,约 8 分钟触达千万级,需提前拉长窗口或多通道扩容)。发送前统一过频控/免打扰/退订三层过滤,实际发送量通常降 10%-30%。上线后以"回执触达率"为北极星指标,某通道骤降即自动切备用通道并告警。
⚠️ 常见误区
详情
常见误区:
- ❌ "发 MQ 就天然不重不漏" → MQ 默认至少一次,去重必须靠业务幂等键(任务 ID + 用户 ID),不重靠发送前校验、不漏靠重试 + 死信。
- ❌ "单队列单消费者慢慢发也能发完" → 3.3 万条/秒的吞吐下,单消费者串行发送需几十分钟到小时级,必须分片 + 多实例并行。
- ❌ "失败就无限重试" → 无限重试会雪崩压垮通道,应指数退避有限重试 + 死信人工介入。
🔬 扩展知识
详情
- 【L3】圈人服务用位图(RoaringBitmap)交并差集运算,亿级用户多标签圈人可在秒级完成,比 SQL 多表 JOIN 快几个数量级。
- 【L3】分片数与消费者数的配比:分片数 ≥ 消费者实例数才能吃满并行度;分片按 userId hash 还能保证同一用户的消息顺序。
- 【L4】多租户与优先级:营销(可延迟)与交易(验证码/订单)分队列隔离资源,避免大促营销洪峰拖垮关键通知。
🔀 发散问题
Q:会员过期提醒能复用这套系统吗?
→ 能,它就是本系统的特例:圈选条件换成"7 天后到期",见「500 万会员过期提醒」。
Q:发送日志也是海量数据,后续要统计热词/热点怎么设计?
→ 哈希分桶 + 堆取 Top,见「几亿条淘宝搜索日志」的同类方案。
【困难】如何设计数据同步方案(同步到数仓)?⭐⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:20 min | 🏷 标签:功能设计 / 数据同步
💎 关键结论
Canal 伪装从库解析 Binlog(业务零侵入),MQ 按业务 ID 分区保序,Flink 清洗写入数仓,断点续传 + 幂等去重 + 每日对账,做到不丢不重、顺序一致、延迟可控。
⚡ 记忆卡片
- 口诀:Canal 采 Binlog,分区保序,Flink 清洗,对账兜底。
- 关键词:Binlog / 分区保序 / 断点续传
- 链路:MySQL Binlog → Canal → MQ → Flink → 数仓
📖 核心知识
数据同步 = Canal 采集 Binlog + MQ 保序 + Flink 清洗 + 每日对账,核心是数据不丢不重、顺序一致、延迟可控。
总体架构
订单库(MySQL) → 变更捕获 → 消息队列 → 数据清洗 → 数仓(Hive/ClickHouse)
        ↑                          ↑
   业务无侵入                  可重试、保序
核心方案选型
| 方案 | 原理 | 准确率 | 性能 | 复杂度 | 推荐 |
|---|---|---|---|---|---|
| Canal(Binlog) | 模拟 MySQL 从库解析 binlog | 最高 | 高 | 中 | ⭐️ 首选 |
| MQ 双写 | 业务代码同步发 MQ | 中 | 低 | 低 | 不推荐 |
| DataX 离线抽取 | 定时全量/增量抽取 | 高 | 低(T+1) | 低 | 离线场景 |
| Flink CDC | 实时流计算 | 高 | 高 | 高 | 实时数仓 |
方案权衡:Binlog 方案对业务零侵入但强依赖源库 binlog 格式(ROW 模式)与主从拓扑,分库分表后每库都要部署采集实例;业务双写 MQ 方案延迟低但侵入业务代码,且事务内发 MQ 有一致性问题。
关键机制
- 数据一致性保障
- 断点续传:记录 binlog 位点(position)
- 去重:MQ 消息幂等消费(订单 ID+版本号)
- 补偿:每日 T+1 对账,不一致重新同步
- 事务边界:binlog 事务原子性(同一事务一起发送)
- 顺序性保障:同一个订单的变更必须顺序处理
- 方案 1:MQ 分区键 = order_id(同订单进同一分区)
- 方案 2:Flink keyBy(order_id) 单线程处理
- 性能优化
- 批量发送:Canal 每 500ms/1000 条发送一次
- 压缩传输:启用 MQ 消息压缩(Gzip/Snappy)
- 目标优化:ClickHouse 批量写入(每批 1 万条)
- 分流处理:订单主表+明细表分开同步
binlog 同步流程
订单库 → Canal → Kafka/RocketMQ → Flink/Spark → 数仓
  ↑         ↑          ↑              ↑
业务写   伪装从库   持久化消息      清洗、维表关联
Canal 配置要点
canal.instance.master.address=127.0.0.1:3306
canal.instance.dbUsername=canal
canal.instance.dbPassword=canal
canal.instance.filter.regex=order_db.order_table  # 监听表
canal.mq.topic=order-binlog
canal.mq.partitionsHash=order_id  # 保序
数据质量保障
实时监控:
- 延迟监控:当前时间 - 最后一条同步时间 < 5 分钟
- 数量监控:源库增量 ≈ 数仓增量(允许误差)
- 异常监控:解析失败率 < 0.1%
对账机制:每日凌晨执行,不一致则触发离线重新同步:
SELECT COUNT(*) FROM order_db.order_table
MINUS
SELECT COUNT(*) FROM dwd_order_table WHERE dt = 昨日
脏数据处理:
- 格式错误 → 发到死信队列(人工介入)
- 维表不存在 → 先存待补表,维表到位后更新
容灾
- 主链路:Canal → Kafka(主集群)
- 备链路:DataX 每日全量(兜底)
- Kafka 故障:消息积压,Canal 本地文件缓存(需配置)
- 数仓故障:消息持久化,恢复后重放
量化参考:日增 1000 万变更的库,binlog 增量约几 GB,Canal 解析 + MQ 传输延迟正常在秒级;Flink keyBy 单键串行处理,热点 key(大卖家)可能成为瓶颈,需盐值打散或拆分处理。
🔬 扩展知识
详情
- 【L3】分库分表后采集 binlog:每分片库部署 Canal 实例(或一个 Canal 集群监听多实例),消息带上分片标识;分区键仍用业务 ID(order_id)保证同订单变更进同一 Kafka 分区保序;全量初始化用 DataX 并行抽取各分片。
- 【L3】源库 DDL 变更(加字段):数仓侧先加字段(向后兼容)再上线源库 DDL;Canal 解析到新结构自动适配,但新旧消息混合期内消费端需容忍字段缺失;严禁先改源库后改数仓,会丢数据。
- 【L4】同步正确性验证三层:实时延迟监控(位点 lag)、抽样比对(每小时随机抽 1000 条源库记录比对数仓)、日终全量对账(COUNT + 关键字段 checksum);发现差异自动触发位点回溯重放。
- 【L4】技术演进:Flink CDC 可一体化完成快照 + 增量与 Schema Evolution,减少 Canal + MQ 环节,新建实时数仓可优先考虑。
📚 延伸阅读:Canal(alibaba) / Flink CDC 文档
🏭 实战场景
详情
订单库分 16 库 64 表,日增 2000 万订单、变更 1 亿次,要求同步到数仓延迟 < 1 分钟、同订单变更保序。
分析要点:每分片库部署 Canal 实例(16 个)解析 ROW 格式 binlog,批量发送(500ms/1000 条);Kafka 分区键 = order_id hash,保证同订单变更进同一分区保序,分区数按吞吐估算(1 亿变更/日 ≈ 峰值数千 TPS,64 分区足够);Flink keyBy(order_id) 清洗 + 维表关联后写 ClickHouse(批量 1 万条/批,避免频繁小写);监控位点 lag 分钟级告警,日终对账 COUNT + checksum,差异自动回溯重放。
积压事故教训:曾有线上事故:Canal 消费积压 6 小时未告警,数仓报表与在线库差异巨大误导运营决策——同步延迟必须有分钟级告警,不能只靠日终对账发现。
⚠️ 常见误区
详情
常见误区:
- ❌ "业务双写 MQ 比 Binlog 更可控" → 双写侵入业务代码,事务内发 MQ 有一致性问题,且漏发无感知;Binlog 零侵入、天然按事务有序,是首选。
- ❌ "有日终对账就够了" → 积压、位点回退等问题当天无法发现,6 小时积压事故就是教训,必须配分钟级延迟告警。
- ❌ "保序就要全局单分区" → 牺牲全部吞吐;只需同一主键有序,按业务 ID(order_id)分区即可并行又保序。
🔀 发散问题
Q:同步链路上线前的存量数据怎么办?
→ DataX 并行全量抽取 + 记录位点后接增量,整体切换思路见「如何实现数据的不停服迁移?」。
Q:同步延迟突增如何排查?
→ 按链路分段定位(采集位点、MQ 积压、消费 TPS),监控埋点思路参考本文档「如何实现接口每分钟调用统计功能?」。
【困难】C4 模型与 ADR(架构决策记录)在架构沟通中如何使用?⭐⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:15 min | 🏷 标签:架构方法论 / 架构沟通
💎 关键结论
C4 模型用四层抽象(Context → Container → Component → Code)解决「对不同干系人说不同粒度的架构」;ADR(Architecture Decision Record)用轻量文档记录每个关键决策的背景、选项、结论与后果,让架构演进可追溯。两者互补:C4 回答「架构长什么样」,ADR 回答「为什么这样设计」。
⚡ 记忆卡片
- 口诀:C4 四层画架构,ADR 三选一留痕
- 关键词:Context / Container / Component / Code / Status / Alternatives / Consequences
- 链路:干系人分层 → C4 四层逐级下钻 → 决策点识别 → ADR 记录选项与权衡 → 可追溯架构演进
📖 核心知识
C4 模型——四层架构图
Simon Brown 提出,解决「一张架构图无法同时面向高管和开发者」的问题:
| 层级 | 视角 | 受众 | 内容 |
|---|---|---|---|
| Level 1 Context | 系统上下文 | 高管、产品、外部干系人 | 系统作为黑盒,与外部用户/系统的交互 |
| Level 2 Container | 容器 | 架构师、Tech Lead | 可独立部署的运行单元(服务、DB、消息队列),技术选型 |
| Level 3 Component | 组件 | 开发者 | 容器内的模块划分,职责与接口 |
| Level 4 Code | 代码 | 开发者 | 类图/接口设计,仅在复杂模块时展开 |
关键原则:
- 每层独立成图,不混层——一张图只讲一层故事;
- 标注边界与职责,不画 UML 全家桶——重点是「谁做什么」而非「怎么实现」;
- 配合 Structurizr 等工具,用代码(DSL)生成图,保持图与代码同步。
ADR——架构决策记录
每个关键架构决策写一份 1~2 页的文档,核心字段:
| 字段 | 内容 |
|---|---|
| Title | 简短决策标题(如「ADR-023:选用 Kafka 作为事件总线」) |
| Status | Proposed / Accepted / Deprecated / Superseded |
| Context | 问题背景与约束(为什么需要决策) |
| Decision | 选了什么方案 |
| Alternatives | 考虑过哪些备选方案,各自的优劣 |
| Consequences | 决策带来的正/负面后果 |
ADR 的价值:
- 防止「考古式」追问:新人入职或半年后回顾时,不用翻聊天记录猜「为什么选了 A 不选 B」;
- 暴露隐含约束:写 Alternatives 时强制对比,避免锚定效应;
- 可演进:旧决策被新决策 Supersede 时,保留历史链,形成决策演化脉络。
ADR 实际样例
ADR-015:订单创建采用异步事件驱动
- Status:Accepted(2025-06)
- Context:订单创建需同步扣库存、发积分、通知物流,链路长、RT 高、任一环节失败需回滚。
- Decision:订单创建只写 DB + 发领域事件,下游通过消费事件异步处理。
- Alternatives:① 同步 RPC 全链路——RT 2s+,任一失败全回滚;② MQ 广播——缺少事件溯源能力。
- Consequences:✅ RT 从 2s 降到 200ms;⚠️ 引入最终一致性,需补偿机制;⚠️ 事件顺序需保证。
🔬 扩展知识
详情
- 【L3】C4 与 UML 的关系:C4 不是替代 UML,而是「选择性地用」——Level 4 可以用类图,Level 2 可以用部署图,但不强制。核心是分层清晰,不是符号标准。
- 【L3】ADR 的存储与检索:通常放在代码仓库的
docs/adr/目录下,用 MADR(Markdown ADR)模板;配合 ADR CLI 工具(如adr-tools)自动生成编号与索引。 - 【L4】C4 在微服务架构中的实践:Level 2 Container 图对应微服务的 API Gateway / 各服务 / DB / MQ 拓扑;Level 3 Component 图对应服务内的分层(Controller → Service → Repository)。但 Component 层在快速迭代中容易过时,建议只对核心域(如支付、订单)维护。
- 【L4】ADR 与敏捷的平衡:不是每个 Sprint 都需要写 ADR——只在「影响面广、不可逆、有多种可选方案」的决策点写。经验法则:如果一个决策错了需要 > 2 周返工,就值得写 ADR。
🏭 实战场景
详情
某电商平台架构评审场景:CTO 要求每季度做一次架构评审,但团队 30+ 人,架构文档散落在 Confluence、飞书、代码注释中。落地方案:
- C4 建模:用 Structurizr DSL 维护 4 层图,CI 自动生成 PNG,嵌入 README;
- ADR 入库:在 monorepo 的
docs/adr/下维护,每个 PR 涉及架构变更时必须附带 ADR; - 效果:新人 onboarding 时间从 3 周降到 1 周(C4 图快速理解系统全貌),架构追问减少 70%(ADR 自解释)。
⚠️ 常见误区
详情
常见误区:
- ❌ "C4 要画四张图才算完整" → 不是所有系统都需要 Level 4,大多数微服务维护到 Level 2~3 即可;Level 4 只在算法复杂或框架设计模块才展开。
- ❌ "ADR 就是写文档,太慢" → ADR 不是详细设计文档,1~2 页足够;核心价值在于「记录为什么」,不在于篇幅。
- ❌ "架构图用 PPT 画就行" → PPT 无法版本控制、无法 diff、无法 CI 生成;推荐 Structurizr / PlantUML / Mermaid 等代码化方案。
🔀 发散问题
Q:C4 模型与 UML 组件图有什么区别?
→ C4 是分层架构视角(四层逐级下钻),UML 组件图是单层内部关系;C4 更面向沟通,UML 更面向工程细节。
Q:ADR 和 RFC(Request for Comments)有什么区别?
→ RFC 侧重决策前的征求意见过程,ADR 侧重决策后的记录与追溯;实践中常先用 RFC 讨论,决策确定后写 ADR 归档。