
RPC 面试
RPC 面试
RPC 简介
【简单】什么是 RPC?RPC 有什么用?⭐⭐
🎯 目标等级:L1 | ⏱ 建议用时:5 min | 🏷 标签:分布式通信 / RPC 概念
💎 关键结论
RPC(Remote Procedure Call,远程过程调用)就是让你"像调用本地方法一样调用远程方法",把网络通信的复杂性藏起来。理由:它屏蔽了远程调用与本地调用的差异,开发者只需聚焦业务逻辑本身。
⚡ 记忆卡片
- 口诀:像调本地一样调远程,通信细节全屏蔽。
- 关键词:远程过程调用/本地化体验/微服务通信基石
- 链路:业务代码调用接口方法 → 框架接管并屏蔽网络细节 → 完成远程调用 → 开发者无感知、聚焦业务
📖 核心知识
- RPC 的全称是 Remote Procedure Call,即远程过程调用。
- RPC 的主要作用是:
- 屏蔽远程调用跟本地调用的差异,让用户像调用本地一样去调用远程方法。
- 隐藏底层网络通信的复杂性,让用户更聚焦于业务逻辑。
- RPC 是微服务架构的基石,它提供了一种应用间通信的方式。
🔬 扩展知识
详情
- 【L3】RPC 与 REST 的差异:REST 基于 HTTP + JSON,面向资源、通用性强、调试方便;RPC 面向方法调用,协议更紧凑、性能更高,更适合内部服务间的高频调用。
- 【L4】在云原生演进中,RPC 的流量治理能力(路由、限流、熔断)正逐步从 SDK 下沉到 Service Mesh 的 Sidecar 代理中,应用本身只保留最基础的调用能力。
🔀 发散问题
RPC 具体是怎么跑通一次调用的? 核心是把方法、参数序列化后按约定协议通过网络传输,服务端还原并执行后原路返回,详见本文档『RPC 是怎样工作的?』。
既然有 HTTP,为什么还要设计 RPC 协议? 因为 HTTP 报文冗余多、无状态,难以满足高性能 RPC 对紧凑协议和连接复用的要求,详见本文档『为何需要 RPC 协议?』。
为什么远程调用能做到"像本地一样"? 关键在于动态代理拦截了方法调用并替换为远程调用逻辑,详见本文档『RPC 如何将远程调用转为本地调用的?』。
【中等】RPC 是怎样工作的?⭐⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:10 min | 🏷 标签:分布式通信 / RPC 工作流程
💎 关键结论
RPC 的工作流程可以拆成"序列化、协议、传输、动态代理"几个环节:调用方把方法参数序列化为二进制,按双方约定的协议封装后通过网络(一般是 TCP)传输,服务端反序列化后调用本地方法,响应原路返回。理由:网络中只能传二进制,双方必须对报文格式达成共识才能互相识别。
⚡ 记忆卡片
- 口诀:代理拦截、序列化封装、网络传输、对端还原、本地执行。
- 关键词:序列化/反序列化/协议(数据头+消息体)/TCP 传输/动态代理
- 链路:方法调用被动态代理拦截 → 参数序列化为二进制 → 按协议封装消息 → 网络传输到服务端 → 反序列化还原参数 → 执行本地方法 → 响应原路返回
📖 核心知识
RPC 是一种应用间通信的方式,它的通信流程中需要注意以下环节:
- 传输方式:RPC 是一个远程调用,因此必然需要通过网络传输数据,且 RPC 常用于业务系统之间的数据交互,需要保证其可靠性,所以 RPC 一般默认采用 TCP 来传输。
- 序列化:在网络中传输的数据只能是二进制数据,而 RPC 请求时,发送的都是对象。因此,请求方需要将请求参数转为二进制数据,即序列化。
- 反序列化:RPC 响应方接受到请求,要将二进制数据转换为请求参数,需要反序列化。
- 协议:请求方和响应方要互相识别彼此的信息,需要约定好彼此数据的格式,即协议。大多数的协议至少分成两部分,分别是数据头和消息体。数据头一般用于身份识别,包括协议标识、数据大小、请求类型、序列化类型等信息;消息体主要是请求的业务参数信息和扩展属性等。
- 动态代理:为了屏蔽底层通信细节,使用户聚焦自身业务,因此 RPC 框架一般引入了动态代理,通过依赖注入等技术,拦截方法调用,完成远程调用的通信逻辑。

一次完整 RPC 调用的 9 个步骤:
- 服务消费方(client)调用以本地调用方式调用服务;
- client stub 接收到调用后负责将方法、参数等组装成能够进行网络传输的消息体;
- client stub 找到服务地址,并将消息发送到服务端;
- server stub 收到消息后进行解码;
- server stub 根据解码结果调用本地的服务;
- 本地服务执行并将结果返回给 server stub;
- server stub 将返回结果打包成消息并发送至消费方;
- client stub 接收到消息,并进行解码;
- 服务消费方得到最终结果。
把 9 步折叠成「每一层的职责」,才是 P8 想听的答案(自上而下):
| 层 | 客户端做什么 | 服务端做什么 |
|---|---|---|
| 代理层 | 动态代理拦截方法调用,把「接口名 + 方法名 + 参数类型 + 参数值 + 分组/版本」组装成 Invocation | 反射或字节码 Wrapper 定位并调用目标实现类的真实方法 |
| 集群层 | 从本地缓存的地址列表按负载均衡选一个 Invoker,套上集群容错(失败重试/快速失败)与路由过滤 | —(服务端不感知集群层) |
| 协议层 | 序列化成字节数组,再按协议编码成完整报文 | 解码出消息头与消息体,按头里的序列化算法 ID 反序列化 |
| 传输层 | 从连接池取长连接写出,登记「请求 ID → Future」映射 | Netty 的 EventLoop 读入字节流,交给业务线程池处理 |
协议头(消息头)里到底有哪些字段——这是「设计一个 RPC 协议」的最小完备集,也是抓包排查时唯一能看的东西:
- 魔数(Magic Number):固定若干字节,用于快速判定「这条字节流是不是本协议的报文」,非法报文直接丢弃,避免反序列化器被喂脏数据而抛异常甚至 OOM。
- 协议版本号:新旧节点混布期间服务端按版本号选择解码分支,是平滑升级的前提。
- 消息类型:请求 / 响应 / 心跳(Heartbeat)/ 单向(Oneway);心跳与业务报文共用一条连接,靠这个字段区分。
- 序列化算法 ID:一个字节标识 Hessian2 / Protobuf / Kryo / JSON 等,让同一协议可以挂多种序列化实现,也让「客户端与服务端序列化配置不一致」这类故障可以被显式报错而不是解出乱码。
- 请求 ID(requestId):单调递增的长整型,是单条长连接上并发多路复用的唯一关联依据——响应回来靠它在映射表里找回对应的 Future。
- 数据长度:消息体字节数,配合定长头解决 TCP 粘包/拆包(接收方先读固定长度头,再按长度读满消息体)。
- 可选:压缩类型、是否事件、消息状态码(服务端处理成功/失败/异常)。
服务端最后一步「调用目标方法」不是只有反射一种做法:Method.invoke() 无法被 JIT 内联,高频调用下开销显著;Dubbo 用 Javassist 在服务导出时生成 Wrapper 类,把「按方法名分发」编译成真实的 switch + 直接方法调用,绕开反射。这一层的取舍详见本文档『RPC 如何将远程调用转为本地调用的?』。
🔬 扩展知识
详情
- 【L3】按交互方式,RPC 调用可分为同步调用(调用线程阻塞等待响应)、异步调用(通过 Future/回调获取结果)与单向调用 Oneway(只发送不等响应),三者底层通信流程一致,差异在于调用端对响应的处理方式。
- 【L4】基于 HTTP/2 的 RPC 协议(如 gRPC、Dubbo3 Triple)可以在一条连接上多路复用多个请求流,将上述流程中的"连接管理"从一问一答升级为流式并发,显著提升单机吞吐。
- 【L4】同一条分层链路,反过来就是一次 RPC 超时的排查路径。P8 追问「线上一次 RPC 超时你怎么定位」时,标准答案是按层切、逐段量耗时,而不是上来就看代码:
- 客户端业务线程池:线程池是否打满、队列是否堆积(此时耗时消耗在「还没发出去」,抓包看不到任何报文);
- 客户端序列化 + 编码耗时:报文是否异常大(大集合、深嵌套对象),序列化 CPU 占比是否偏高;
- 网络 RTT:
ping/tcpdump看握手与传输时延,排除跨机房、丢包重传、LB 转发; - 服务端 IO 线程 → 业务线程池的派发排队:报文已经到了服务端(抓包可见)但业务线程池排队,表现为「服务端记录的执行耗时很短,客户端记录的调用耗时很长」——这个差值就是排队时间,是最容易被漏掉的一段;
- 服务端业务逻辑本身:慢 SQL、下游 RPC、锁竞争;
- 服务端 GC:Full GC / 长 Young GC 停顿会让所有在途请求同时超时,特征是同一时间点大面积超时而非单接口超时;
- 下游依赖:服务端自己也是调用方,超时逐层向下传导。
定位手段上,靠链路追踪的 Span 耗时拆分做粗筛,靠两端时间戳差值判断是网络还是排队,靠 GC 日志与线程池监控做确认。详见《分布式治理面试》『如何实现链路追踪?』。
- 【L4】超时时间必须逐层递减:上游的超时应大于「下游超时之和 + 网络与序列化开销」,否则会出现「上游已放弃、下游仍在执行」的资源浪费与状态不一致;重试次数同样应随调用深度递减,并用重试预算(Retry Budget)限制重试流量占比,避免重试放大效应引发雪崩。这部分与集群容错策略一起,见本文档『如何设计一个 RPC 框架?』。
🔀 发散问题
序列化环节怎么选? 要在安全性、兼容性、性能、易用性之间权衡,详见本文档『什么是序列化?有哪些常见的序列化方式?』。
协议头应该包含哪些字段? 至少有协议标识、消息长度、请求类型、序列化类型等,详见本文档『设计一个 RPC 协议的要点?』。
调用端怎么做到不阻塞? 通过 Future 与消息 ID 的映射在响应到达时回填结果,详见本文档『如何实现 RPC 异步调用?』。
RPC 框架对比
【中等】主流 RPC 框架有哪些?它们有什么区别?⭐⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:10 min | 🏷 标签:分布式通信 / RPC 框架选型
💎 关键结论
主流 RPC 框架各有侧重:Java 生态重服务治理选 Dubbo,跨语言与云原生选 gRPC,多语言高性能二进制通信选 Thrift,Spring 全家桶选 Spring Cloud。理由:选型的核心是语言生态、协议性能与服务治理能力三者的匹配。
⚡ 记忆卡片
- 口诀:Java 治理用 Dubbo,跨语言云原生用 gRPC,二进制高效用 Thrift,Spring 生态用 OpenFeign。
- 关键词:Dubbo/gRPC/Thrift/Motan/Spring Cloud
- 链路:明确语言生态与场景 → 对比协议/序列化/治理能力 → 选出框架 → 落地微服务通信
📖 核心知识
目前主流的 RPC 框架有 Dubbo、gRPC、Thrift、Motan 等,它们在设计理念、生态、跨语言支持等方面各有侧重。
| 框架 | 出品方 | 跨语言 | 序列化默认协议 | 服务治理 | 通信协议 | 适用场景 |
|---|---|---|---|---|---|---|
| Dubbo | 阿里/Apache | 否(Java 为主,Dubbo3 支持多语言) | Hessian2 | 完善 | TCP/HTTP/HTTP2 | Java 微服务体系,重服务治理 |
| gRPC | 是 | Protobuf | 弱 | HTTP/2 | 跨语言通信,云原生场景 | |
| Thrift | 是 | Thrift | 弱 | TCP | 跨语言,二进制高效通信 | |
| Motan | 微博 | 否 | Hessian2 | 中等 | TCP | 中小规模 Java 微服务 |
| Spring Cloud | Pivotal | 否(HTTP) | JSON | 完善 | HTTP | Spring 生态,REST 风格微服务 |
选型建议:
- 纯 Java 体系,重服务治理 → Dubbo(生态完善,国内使用广泛)
- 跨语言通信,云原生 → gRPC(Protobuf 高效,HTTP/2 多路复用)
- 多语言、对协议紧凑性要求高 → Thrift(IDL 定义清晰,性能优秀)
- Spring 全家桶生态 → Spring Cloud OpenFeign(HTTP+JSON,开发体验好)
Dubbo 与 gRPC 的核心差异:
- 定位不同:Dubbo 定位是微服务框架(包含服务治理、注册发现、配置中心等),gRPC 定位是通信协议与 RPC 框架。
- 协议不同:Dubbo 默认使用 Dubbo2 协议(基于 TCP),Dubbo3 引入 Triple 协议(兼容 gRPC);gRPC 基于 HTTP/2 + Protobuf。
- 服务治理:Dubbo 内置丰富的服务治理能力(路由、限流、集群容错),gRPC 需要配合 Istio、xDS 等实现。
- 跨语言:gRPC 原生支持多语言;Dubbo 主要面向 Java,Dubbo3 开始支持 Go、Rust、Node 等多语言 SDK。
🔬 扩展知识
详情
- 【L3】IDL(接口定义语言)是跨语言框架的关键差异:gRPC/Thrift 依赖
.proto/.thrift预定义接口并生成代码,契约清晰但开发多一步;Dubbo 以 Java 接口直接定义服务,开发更自然但跨语言能力较弱。 - 【L4】Dubbo3 与 gRPC 在协议层已打通(Triple 兼容 gRPC),这意味着两套体系可以在同一网格内互通,是企业从 Dubbo2 平滑迁移到云原生体系的常见路径。
- 【L4】选型时容易忽略的两个硬约束:
- gRPC 不能在浏览器里直接跑。gRPC 依赖 HTTP/2 的 Trailer(尾部首部)传递状态码,而浏览器的
fetch/XHR API 不暴露 Trailer,所以前端必须走 gRPC-Web + 一个代理(如 Envoy) 做协议转换,由代理补上 Trailer。这直接影响「BFF/前端直连微服务」这类架构能不能成立。 - HTTP/2 的多路复用只解决了应用层的队头阻塞。HTTP/1.1 上一条连接同一时刻只能处理一个请求,浏览器只能靠开 6 条连接并行;HTTP/2 用二进制分帧把多个 Stream 交错在同一条 TCP 连接上,消除了应用层的队头阻塞。但多个 Stream 仍复用同一条 TCP 连接,一旦发生 TCP 丢包,整条连接上的所有 Stream 都要等重传——这就是 TCP 层的队头阻塞,只有 HTTP/3(基于 QUIC,每个流独立可靠传输)才彻底解决。所以「HTTP/2 没有队头阻塞」是错的,弱网与跨地域链路上尤其明显。
- gRPC 不能在浏览器里直接跑。gRPC 依赖 HTTP/2 的 Trailer(尾部首部)传递状态码,而浏览器的
🔀 发散问题
Dubbo 和 gRPC 在协议层面的差异是什么? Dubbo2 协议基于 TCP 私有协议,Triple/gRPC 基于 HTTP/2,详见本文档『RPC 通信应该选择 TCP 还是 HTTP?』与『什么是 Triple 协议?』。
为什么跨语言框架普遍用 Protobuf? 因为它体积小、速度快、通过字段编号实现良好的版本兼容,详见本文档『常见序列化协议的深度对比?』。
协议
【中等】为何需要 RPC 协议?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:8 min | 🏷 标签:分布式通信 / RPC 协议
💎 关键结论
RPC 必须设计协议,是因为二进制流本身没有边界,收发双方必须像"用标点断句"一样,对报文的格式达成共识才能正确识别每条消息。理由:HTTP 等通用协议报文冗余、无状态,难以满足高性能 RPC 对紧凑私有协议的需求。
⚡ 记忆卡片
- 口诀:二进制没有边界,协议就是标点符号。
- 关键词:二进制传输/消息边界/收发共识/紧凑私有协议
- 链路:请求参数转二进制 → 数据拆包/粘包 → 需识别消息归属 → 双方约定协议 → 按协议解析报文
📖 核心知识
只有二进制才能在网络中传输,所以 RPC 请求需要把方法调用的请求参数先转成二进制,然后再通过网络传输。
传输的数据可能很大,RPC 请求需要将数据分解为多个数据包;传输的数据也可能较小,需要和其他请求的数据包进行合并。当接收方收到请求时,需要从二进制数据中识别出不同的请求。问题是,如何从二进制数据中识别出其所属的请求呢?
这就需要发送方、接收方在通信过程中达成共识,严格按照协议处理二进制数据。这就好比让你读一篇没有标点符号的文章,你要怎么识别出每一句话到哪里结束呢?很简单啊,我们加上标点,完成断句就好了。这里有个潜在的含义,写文章和读文章的人,都遵循标点符号的用法。
再进一步探讨,既然已经有很多成熟的网络协议,为何还要设计 RPC 协议?
有必要。因为 HTTP 这些通信标准协议,数据包中的实际请求数据相对于数据包本身要小很多,有很多无用的内容;并且 HTTP 属于无状态协议,无法将请求和响应关联,每次请求要重新建立连接。这对于高性能的 RPC 来说,HTTP 协议难以满足需求,所以有必要设计一个紧凑的私有协议。
🔀 发散问题
私有协议头里应该放哪些字段? 协议标识、数据大小、请求类型、序列化类型等,详见本文档『设计一个 RPC 协议的要点?』。
RPC 为什么常用 TCP 而不是 HTTP/1? TCP 协议紧凑、可靠且便于长连接复用,详见本文档『RPC 通信应该选择 TCP 还是 HTTP?』。
【中等】设计一个 RPC 协议的要点?⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:10 min | 🏷 标签:分布式通信 / RPC 协议设计
💎 关键结论
设计 RPC 协议首先要明确消息边界(消息长度 + 消息内容),再演进为"数据头 + 消息体"结构;为了平滑升级,协议头要支持可扩展,最终形成"固定部分 + 协议头内容 + 协议体内容"的三段式结构。理由:定长协议头加字段会造成线上兼容问题,不定长扩展头需要一个固定字段来指明头部长度。
⚡ 记忆卡片
- 口诀:先定边界,再分头体,扩展靠"固定长度+变长头"。
- 关键词:消息边界/数据头+消息体/定长协议头/可扩展三段式
- 链路:明确消息长度定边界 → 协议头承载元信息 → 定长头无法平滑加字段 → 用固定字段记录头部长度 → 协议头可扩展、平滑升级
📖 核心知识
首先,必须先明确消息的边界,即确定消息的长度。因此,至少要分为:消息长度+消息内容两部分。
接下来,我们会发现,在使用过程中,仅消息长度,不足以明确通信中的很多细节:如序列化方式是怎样的?是否消息压缩?压缩格式是怎样的?如果协议发生变化,需要明确协议版本等等。
大多数的协议会分成两部分,分别是数据头和消息体。数据头一般用于身份识别,包括协议标识、数据大小、请求类型、序列化类型等信息;消息体主要是请求的业务参数信息和扩展属性等。
综上,一个 RPC 协议大概会由下图中的这些参数组成:

前面所述的协议属于定长协议头,那也就是说往后就不能再往协议头里加新参数了,如果加参数就会导致线上兼容问题。
为了保证能平滑地升级改造前后的协议,我们有必要设计一种支持可扩展的协议。其关键在于让协议头支持可扩展,扩展后协议头的长度就不能定长了。那要实现读取不定长的协议头里面的内容,在这之前肯定需要一个固定的地方读取长度,所以我们需要一个固定的写入协议头的长度。整体协议就变成了三部分内容:固定部分、协议头内容、协议体内容。

🔬 扩展知识
详情
- 【L3】协议版本字段是平滑升级的关键:新旧节点混布期间,服务端按协议头中的版本号选择对应的解码逻辑,实现多版本并存与灰度升级。
- 【L4】除长度外,协议头还可承载魔数(Magic Number)校验、压缩类型、请求序列号(用于异步响应匹配)等字段;魔数可快速丢弃非法报文,序列号是请求-响应关联的基础。
🔀 发散问题
为什么需要消息体压缩? 当业务参数较大时,压缩可以减少网络传输开销,代价是 CPU,需要按报文大小做开关控制。
消息长度字段一般用几个字节? 常用 4 字节整型表示,意味着单条消息上限约 4GB 内的约定值,实际框架通常会再设置更小的业务上限防止内存被打爆。
序列化
【简单】什么是序列化?有哪些常见的序列化方式?⭐⭐⭐
🎯 目标等级:L1 | ⏱ 建议用时:8 min | 🏷 标签:分布式通信 / 序列化
💎 关键结论
序列化是把对象转成可传输的二进制,反序列化是还原回来,且转换必须可逆。理由:网络中只能传二进制,而 RPC 出入参都是对象。选型时按安全性 > 兼容性 > 性能 > 易用性的顺序权衡。
⚡ 记忆卡片
- 口诀:对象变二进制叫序列化,变回来叫反序列化;选型先看安全和兼容。
- 关键词:序列化/反序列化/二进制可逆/安全性优先
- 链路:对象无法直接网络传输 → 序列化为二进制 → 网络传输 → 对端反序列化还原对象
📖 核心知识
由于,网络传输的数据必须是二进制数据,而调用方请求的出参、入参都是对象。因此,必须将对象转换可传输的二进制,并且要求转换算法是可逆的。
- 序列化(serialize):序列化是将对象转换为二进制数据。
- 反序列化(deserialize):反序列化是将二进制数据转换为对象。

Java 领域,常见的序列化技术如下
市面上有如此多的序列化技术,那么我们在应用时如何选择呢?
一般而言,序列化技术选型需要考量的维度,根据重要性从高到低,依次有:
- 安全性:是否存在漏洞。如果存在漏洞,就有被攻击的可能性。
- 兼容性:版本升级后的兼容性是否很好,是否支持更多的对象类型,是否是跨平台、跨语言的。服务调用的稳定性与可靠性,要比服务的性能更加重要。
- 性能
- 时间开销:序列化、反序列化的耗时性能自然越小越好。
- 空间开销:序列化后的数据越小越好,这样网络传输效率就高。
- 易用性:类库是否轻量化,API 是否简单易懂。
鉴于以上的考量,序列化技术的选型建议如下:
- JDK 序列化:性能较差,且有很多使用限制,不建议使用。
- Thrift、Protobuf:适用于对性能敏感,对开发体验要求不高。
- Hessian:适用于对开发体验敏感,性能有要求。
- Jackson、Gson、Fastjson:适用于对序列化后的数据要求有良好的可读性(转为 json 、xml 形式)。
🔀 发散问题
主流序列化协议之间怎么深度对比? 从跨语言、性能、体积、IDL、兼容性、安全性多维度对比,详见本文档『常见序列化协议的深度对比?』。
序列化使用中有哪些坑? 对象过于复杂庞大、复杂继承关系、使用框架不支持的类,详见本文档『序列化的使用中需要注意哪些问题?』。
Q:JDK 原生序列化的底层机制(Serializable/transient/serialVersionUID)与安全漏洞(Gadget Chain)在哪里? → 详见《JavaCore 面试(三)》「什么是序列化?什么是反序列化?」(简单 ⭐⭐⭐⭐,含反序列化漏洞与 ObjectInputFilter 白名单)。
【中等】常见序列化协议的深度对比?⭐⭐⭐⭐
🎯 目标等级:L4 | ⏱ 建议用时:10 min | 🏷 标签:分布式通信 / 序列化选型
💎 关键结论
序列化协议直接影响 RPC 的性能、兼容性和安全性:追求性能与兼容选 Protobuf,Java 生态开发体验选 Hessian2,可读性优先选 JSON,JDK 序列化有漏洞且性能差、生产慎用。理由:没有全能协议,只有与场景匹配的协议。
⚡ 记忆卡片
- 口诀:性能兼容 Protobuf,Java 体验 Hessian,可读性 JSON,JDK 原生别上生产。
- 关键词:IDL/向前向后兼容/serialVersionUID/反序列化漏洞
- 链路:明确场景诉求(性能/兼容/可读)→ 按维度对比候选协议 → 验证版本兼容与安全 → 确定选型
📖 核心知识
下面从多个维度对主流序列化协议进行深度对比。
| 序列化协议 | 跨语言 | 性能 | 体积 | 是否需 IDL | 兼容性 | 安全性 | 典型应用 |
|---|---|---|---|---|---|---|---|
| JDK | 否 | 差 | 大 | 否 | 差 | 低 | Java 内部 |
| Hessian2 | 部分 | 中 | 小 | 否 | 好 | 中 | Dubbo 默认 |
| Kryo | 否 | 高 | 极小 | 否 | 中 | 中 | 纯 Java 高性能 |
| FST | 否 | 高 | 小 | 否 | 中 | 中 | Java 高性能替代 |
| Protobuf | 是 | 高 | 极小 | 是 | 极好 | 高 | gRPC/Dubbo3 |
| Thrift | 是 | 高 | 小 | 是 | 好 | 高 | Thrift RPC |
| JSON | 是 | 低 | 大 | 否 | 极好 | 高 | 前后端、REST |
| MessagePack | 是 | 中 | 中 | 否 | 好 | 高 | 跨语言轻量 |
关键差异分析:
- IDL(接口定义语言):Protobuf 和 Thrift 需要预定义
.proto/.thrift文件,编译生成代码。优点是强类型、版本兼容性好;缺点是开发流程多一步。 - 向前/向后兼容:Protobuf 通过字段编号实现优秀的向前/向后兼容(新增字段使用新编号,旧版本忽略未知字段);Hessian2 支持字段增删;JDK 序列化对
serialVersionUID敏感。 - 安全性:JDK 序列化存在反序列化漏洞(如 Apache Commons Collections 漏洞链),生产环境慎用;Protobuf、JSON 等相对安全。
🔬 扩展知识
详情
- 【L3】Protobuf 的编码原理是 Varint 变长整数 + 字段标签(field number + wire type),字段名不参与编码,因此体积小、且字段重命名不影响兼容。
- 【L4】高性能 Java 框架常在 Hessian2 之外提供 Kryo/FST 作为内网高性能选项,但跨版本兼容能力弱于 Hessian2,切换前需评估接口模型变更频率。
- 【L4】Protobuf 的前后兼容不是「自动就有」的,而是一组必须遵守的编码纪律:
- 字段编号(field number)一旦上线就不可复用、不可修改。编号才是 wire 上的身份,改名安全、改编号等于换字段;
- 删除字段必须用
reserved保留编号与字段名(reserved 5; reserved "old_name";),否则后人复用该编号时,老客户端发来的旧数据会被静默解析成新字段的错误类型——这类故障不抛异常,只会算错钱; optional(单值)与repeated(列表)的 wire type 不同,同一编号不能从单值改成列表;repeated的标量类型在 proto3 默认使用 packed 编码,与 proto2 的非 packed 表示不同,跨版本混用需注意;- 新增字段一律用新编号,旧版本读到未知字段会保留(proto3)或跳过,不会报错。
- 【L4】proto2 与 proto3 的实质差异,P8 追问点在这里:
- proto3 取消了
required(required一旦上线就永远无法安全移除,是 proto2 的设计失误); - proto3 默认值不参与序列化(
int32的 0、string的""、bool的false都不写入字节流),带来的直接后果是接收方无法区分「对方没设置这个字段」和「对方显式设置了零值」。业务上「金额 0 元」与「金额未传」语义完全不同时,必须改用optional关键字(proto3 支持显式optional,可生成has_xxx()判存方法)或包装类型 / 哨兵值; - proto3 强制关闭未知字段的丢弃行为(保留并回传),对代理转发场景更友好。
- proto3 取消了
- 【L4】Hessian2 的兼容坑(Dubbo 默认序列化,踩过的都懂):Hessian2 是自描述格式(把类型信息写进字节流),所以无需 IDL、天然支持字段增删,但代价是:
- 泛型信息不参与序列化,反序列化后可能得到
Map而非期望的 POJO; - 循环引用依赖其 ref 机制处理,跨语言实现(如 Python/Go 的 Hessian 库)支持程度不一,容易在异构调用时炸开;
BigDecimal等类型的精度与表示在不同实现间存在差异,金额类字段建议统一用String或最小货币单位的long传输,不要直接依赖序列化框架的BigDecimal行为;- 类结构变更(字段类型改动、包名迁移)时,两端 Hessian2 版本与类定义不一致会表现为反序列化异常或字段静默丢失。
- 泛型信息不参与序列化,反序列化后可能得到
- 【L4】Kryo / FST:性能高但有两个必须知道的限制:
- 不跨语言,只适用于纯 Java 内网;
Kryo实例本身不是线程安全的,绝不能做成单例共享。标准做法是ThreadLocal<Kryo>或对象池(如Pool<Kryo>);- Kryo 的注册机制(
kryo.register(clazz)分配固定 ID)能进一步压缩体积(用 ID 替代全限定类名)并提速,但注册顺序必须在两端严格一致,否则解出完全错乱的对象——这让注册机制与「服务端多版本灰度」天然冲突,实践中要么不注册,要么用显式 ID 注册(register(clazz, id))而非顺序注册。
📚 延伸阅读:深入理解 Java 序列化
⚠️ 常见误区
详情
- ❌ "Protobuf 最好,全都换成 Protobuf" → 序列化选型没有全局最优,只有场景匹配:内部纯 Java 服务间优先 Hessian2(无需 IDL、开发体验好、字段增删兼容)或 Kryo(性能极致);跨语言 / 云原生 / Service Mesh 用 Protobuf + gRPC/Triple(强契约、体积小、生态标准);对外开放 API、调试与可读性优先用 JSON。把内网 Java 服务全量迁 Protobuf,收益是带宽和 CPU,代价是全公司多一道 IDL 编译与代码生成流程、以及 proto 契约治理成本——这笔账在很多团队并不划算。
- ❌ "JSON 只是慢一点,没什么大问题" → JSON 的问题不只是慢:体积大(字段名重复出现在每条报文里)、无 Schema 强约束(字段类型变更只能在运行时炸)、数字精度(JavaScript 侧
Number是双精度浮点,超过 2^53 的longID 会丢精度,所以雪花 ID 必须序列化成字符串)。但对外 API 仍应选 JSON,因为通用性与可调试性的价值高于这些开销。 - ❌ "Java 原生序列化只是性能差,内网用用没关系" → 这是最危险的一条误区,它有三个问题而不止一个:
- 体积膨胀:
ObjectOutputStream会把完整的类元数据(类名、字段名、字段类型、serialVersionUID)写进字节流,序列化结果相对于对象的有效数据量可膨胀到十倍量级,直接吃带宽; - 性能差:大量使用反射与递归遍历对象图,序列化/反序列化耗时显著高于 Hessian2、Protobuf;
- 安全漏洞(最致命):反序列化会执行流中携带的类的方法。攻击者构造一条只含 JDK 与常见三方库(如 Apache Commons Collections 的
Transformer链)的字节流,就能在readObject()过程中拼出 gadget 链,最终达成远程命令执行。防护手段是 JEP 290 引入的反序列化过滤(ObjectInputFilter,可按类名/包名/数组长度/流深度做白名单),但过滤只是缓解——根治办法是根本不要把 Java 原生序列化暴露在不可信网络边界上。
另注意:Java 原生序列化还有一个「兼容性」陷阱——serialVersionUID若未显式声明,会由编译器根据类结构自动计算,加一个无关字段就可能改变 UID,导致两端InvalidClassException。
- 体积膨胀:
- ❌ "换序列化协议只是改一行配置" → 序列化协议是两端契约,必须双端同时升级或做双协议并存灰度;协议头里的序列化算法 ID 就是为这个场景设计的(服务端按 ID 选择解码器,实现新老协议混布)。忽略这一点会在发布窗口造成大面积反序列化失败。
- ❌ "Hessian2 支持所有 Java 类型" → 它对有序集合、第三方集合类(如 Guava 的
ImmutableList)、枚举与泛型的处理都有边界,详见本文档『序列化的使用中需要注意哪些问题?』。
🔀 发散问题
为什么 Dubbo 默认用 Hessian2 而不是 Protobuf? Hessian2 无需 IDL、对 Java 对象模型友好、支持字段增删,兼顾开发体验与兼容性;Protobuf 则更适合跨语言强契约场景。
选型时还需要注意什么使用问题? 即使选对了协议,对象过于复杂或使用不当类型仍会拖垮性能,详见本文档『序列化的使用中需要注意哪些问题?』。
【简单】序列化的使用中需要注意哪些问题?⭐⭐
🎯 目标等级:L1 | ⏱ 建议用时:5 min | 🏷 标签:分布式通信 / 序列化使用
💎 关键结论
选对序列化框架只是第一步,还要保证传输对象"简单、小巧、原生、无复杂继承"。理由:序列化贯穿每次 RPC 通信,对象越复杂,序列化耗时与传输开销越大,直接拉高响应时延。
⚡ 记忆卡片
- 口诀:对象要简单,体积要小,集合用原生,继承要少搞。
- 关键词:嵌套复杂/大集合/继承遍历/原生集合类
- 链路:对象复杂庞大 → 序列化慢、报文大 → 时延上升 → 因此约束对象设计
📖 核心知识
由于 RPC 每次通信,都要经过序列化、反序列化的过程,所以序列化方式,会直接影响 RPC 通信的性能。除了选择合适的序列化技术,如何合理使用序列化也非常重要。
RPC 序列化常见的使用不当的情况如下:
对象过于复杂、庞大 - 对象过于复杂、庞大,会降低序列化、反序列化的效率,并增加传输开销,从而导致响应时延增大。
- 过于复杂:存在多层的嵌套,比如 A 对象关联 B 对象,B 对象又聚合 C 对象,C 对象又关联聚合很多其他对象
- 过于庞大:比如一个大 List 或者大 Map
对象有复杂的继承关系 - 对象关系越复杂,就越浪费性能,同时又很容易出现序列化上的问题。大多数序列化框架在进行序列化时,如果发现类有继承关系,会不停地寻找父类,遍历属性。
使用序列化框架不支持的类作为入参类 - 比如 Hessian 框架,他天然是不支持 LinkedHashMap、LinkedHashSet 等,而且大多数情况下最好不要使用第三方集合类,如 Guava 中的集合类,很多开源的序列化框架都是优先支持编程语言原生的对象。因此如果入参是集合类,应尽量选用原生的、最为常用的集合类,如 HashMap、ArrayList。
前面已经列举了常见的序列化问题,既然明确了问题,就要针对性预防。RPC 序列化时要注意以下几点:
- 对象要尽量简单,没有太多的依赖关系,属性不要太多,尽量高内聚;
- 入参对象与返回值对象体积不要太大,更不要传太大的集合;
- 尽量使用简单的、常用的、开发语言原生的对象,尤其是集合类;
- 对象不要有复杂的继承关系,最好不要有父子类的情况。
🔀 发散问题
大集合一定要传怎么办? 应改为分页/分批传输,或用流式调用分块发送,避免单条报文过大导致超时与内存压力。
怎么从协议层面减少这些问题? 用 IDL 强约束接口模型可以在设计期就拦截不合理的对象结构,详见本文档『常见序列化协议的深度对比?』。
通信
【简单】HTTP 与 RPC 有什么区别?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:10 min | 🏷 标签:通信协议 / 选型对比
💎 关键结论
HTTP 是通用通信协议,重标准化与互操作;RPC 是高性能调用方式,重效率与内部治理。核心差异:HTTP 文本格式(JSON/XML)、相对低性能、治理靠外部组件;RPC 二进制格式(Protobuf 等)、长连接高性能、治理内置。对外 API、跨语言选 HTTP,内部高频调用选 RPC。
⚡ 记忆卡片
- 口诀:HTTP 通用走文本,RPC 高效走二进制
- 关键词:JSON / Protobuf / 长连接 / 服务治理内置 / 跨语言
- 链路:对外接口 → HTTP(通用互操作);内部调用 → RPC(高性能治理)
📖 核心知识
HTTP 是通用通信协议,侧重标准化与互操作性;RPC 是高性能调用方式,侧重效率与内部服务治理。
| 维度 | HTTP | RPC |
|---|---|---|
| 协议定位 | 应用层通信标准 | 远程调用方式 |
| 数据格式 | 文本为主(JSON/XML) | 二进制为主(Protobuf 等) |
| 性能 | 相对低(文本解析、短连接) | 高(长连接、二进制传输) |
| 服务治理 | 需额外组件(注册中心、网关) | 框架内置(负载均衡、熔断) |
| 适用场景 | 对外 API、跨语言异构 | 内部服务间高性能调用 |
🔀 发散问题
Q:具体到框架怎么选?
→ 对外走 HTTP(如 Feign),内部走 RPC(如 Dubbo),详见本文档「主流 RPC 框架有哪些?它们有什么区别?」。
Q:RPC 通信协议怎么选?
→ TCP vs HTTP 的权衡,详见本文档「RPC 通信应该选择 TCP 还是 HTTP?」。
【中等】RPC 通信应该选择 TCP 还是 HTTP?⭐⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:10 min | 🏷 标签:分布式通信 / 传输协议选型
💎 关键结论
RPC 通信选 TCP 还是 HTTP 没有标准答案:内网高性能、纯 Java 体系选 TCP 私有协议,需要跨网关、浏览器或云原生场景选 HTTP/2。理由:TCP 协议紧凑性能高但穿透性差,HTTP/2 靠多路复用把性能差距拉得很小且生态通用。
⚡ 记忆卡片
- 口诀:内网高性能用 TCP,穿透网关上 HTTP/2。
- 关键词:私有协议/HTTP/2/多路复用/网关穿透
- 链路:明确部署环境(内网/跨网关/云原生)→ 对比性能与穿透性 → 选定传输协议 → 落地框架配置
📖 核心知识
核心结论:RPC 通信可以选择 TCP,也可以选择 HTTP,两者各有优劣。现代 RPC 框架(如 gRPC、Dubbo3 Triple)倾向于基于 HTTP/2 构建。
TCP vs HTTP 对比:
| 维度 | TCP 私有协议(如 Dubbo2) | HTTP/HTTP2(如 gRPC、Triple) |
|---|---|---|
| 性能 | 高(协议紧凑,无 HTTP 头开销) | HTTP/1 较低;HTTP/2 接近 TCP |
| 可读性 | 差(二进制,需抓包工具) | HTTP/2 较差;HTTP/1 可读 |
| 穿透性 | 差(不易穿过网关、代理) | 好(标准协议,网关友好) |
| 多路复用 | 需自行实现 | HTTP/2 原生支持 |
| 流式通信 | 需自行实现 | HTTP/2 原生支持 Stream |
| 浏览器访问 | 不支持 | HTTP/1、HTTP/2 支持 |
| 跨语言 | 需各语言实现协议 | 通用,生态好 |
选型建议:
- 内网高性能调用,纯 Java 体系 → TCP 私有协议(如 Dubbo2 协议)
- 需要跨网关、代理、浏览器访问 → HTTP/2(如 Triple、gRPC)
- 云原生、服务网格场景 → HTTP/2(更易与 Istio 等集成)
🔬 扩展知识
详情
- 【L3】HTTP/2 性能能追平 TCP 私有协议的关键在于二进制分帧与头部压缩(HPACK),消除了 HTTP/1 文本协议的解析开销与连接数瓶颈。
- 【L4】HTTP/3(基于 QUIC)进一步解决 TCP 层队头阻塞并内建连接迁移,适合弱网与跨地域调用,但当前 RPC 框架落地仍以 HTTP/2 为主。
🏭 实战场景
详情
推演场景(非生产真实数据,用于呈现决策链而非具体指标):内部微服务体系最初统一使用 HTTP/JSON 协议,开发调试方便、日志可读性好。随着业务增长,核心链路进入高 QPS 区间后问题暴露:JSON 的单次编解码耗时与报文体积都显著高于二进制协议,压测发现瓶颈不在网络传输而在编解码的 CPU 开销,表现为 P99 延迟随 QPS 上升而明显抬高、序列化相关 CPU 占比成为大头。于是将内部服务迁移至 gRPC(HTTP/2 + Protobuf),P99 延迟与带宽占用同步下降——Protobuf 因为不携带字段名、整数用 Varint 变长编码,等价报文的体积通常只有 JSON 的几分之一。但对外暴露的 API 网关仍保留 HTTP/REST + JSON,因为第三方接入方无法适配 gRPC,且外部 QPS 量级远低于内部链路,序列化开销可忽略。最终形成"内部 gRPC、外部 REST"的混合协议架构,通过网关做协议转换。
这个案例的可复用结论不是那几个数字,而是决策依据:① 协议迁移的收益要用压测把「编解码 CPU 占比」和「报文体积」两个指标单独量出来,而不是笼统地说"性能变好了";② 内外分层用不同协议是常态,网关承担协议转换;③ 迁移必须双协议并存灰度,不能一刀切。
🔀 发散问题
选了 TCP/HTTP 之后连接怎么管理? RPC 通常用长连接复用并配合心跳保活,详见本文档『长连接 vs 短连接?』。
Dubbo3 基于 HTTP 的协议是什么? Triple 协议,基于 HTTP/2 且兼容 gRPC,详见本文档『什么是 Triple 协议?』。
【中等】长连接 vs 短连接?⭐⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:8 min | 🏷 标签:分布式通信 / 连接管理
💎 关键结论
RPC 框架通常采用长连接,避免每次请求都经历 TCP 三次握手的开销。理由:RPC 是高频调用场景,建连成本摊薄到多次请求上才划算,代价是要用心跳保活和断线重连来维持连接健康。
⚡ 记忆卡片
- 口诀:高频调用用长连接,心跳保活防假死。
- 关键词:三次握手开销/连接复用/心跳保活/断线重连
- 链路:高频 RPC 调用 → 频繁建连开销大 → 建立长连接复用 → 心跳检测存活 → 断开后自动重连
📖 核心知识
核心结论:RPC 框架通常采用长连接,以避免频繁建连带来的握手开销。
| 维度 | 短连接 | 长连接 |
|---|---|---|
| 连接建立 | 每次请求新建连接 | 连接建立后复用,多次请求共享 |
| 性能 | 低(TCP 三次握手开销) | 高(省去握手开销) |
| 资源占用 | 低(请求结束即释放) | 高(需维持连接,心跳保活) |
| 适用场景 | 低频、请求量小 | 高频、高并发 RPC 调用 |
| 典型应用 | HTTP/1.0 | Dubbo2、gRPC、HTTP/1.1 KeepAlive |
长连接的关键问题:
- 心跳保活:定期发送心跳包,检测连接是否存活(Dubbo 默认 60s 心跳)。
- 连接断开重连:连接异常断开后,需自动重连机制。
- 连接复用与多路复用:HTTP/2 在单连接上支持多路复用,避免队头阻塞。
反过来,短连接的代价是什么? 除了每次请求都要付一次 TCP 三次握手(跨机房时是一个完整 RTT)与 TLS 握手,更隐蔽的是主动关闭方的 TIME_WAIT 堆积:TCP 规定主动关闭连接的一端要进入 TIME_WAIT 并停留 2MSL(Linux 上 tcp_fin_timeout 决定时长,量级为分钟级)。高 QPS 下用短连接,客户端会迅速积累数万个 TIME_WAIT,耗尽本地端口(net.ipv4.ip_local_port_range 范围内每个「四元组」都不可复用),表现为 Cannot assign requested address。这也是 RPC 框架宁可付出心跳与重连的复杂度也要用长连接的根本原因。
长连接也不是免费的:
- 连接数与节点数成正比。N 个消费者 × M 个提供者,若每对都建独立连接,总连接数是 N×M 量级,文件描述符与内存都吃不消。Dubbo 的默认策略是消费者到每个提供者只建一条长连接(
connections=1),靠 requestId 在这条连接上并发多路复用,把连接数从 N×M 降到可控规模。 - 单连接成为吞吐瓶颈时才需要调大连接数,判断依据是「连接上的写缓冲是否持续打满、是否触发 TCP 窗口限制」。
- 连接假死:进程还在、TCP 连接也没收到 RST,但对端已经不处理请求。这只能靠应用层心跳发现,TCP 自带的
SO_KEEPALIVE默认两小时才探测一次,对 RPC 完全没有实用价值。
🔬 扩展知识
详情
- 【L3】长连接数量与连接方向需要治理:双向连接、消费者与提供者间连接数过多时会占用文件描述符与内存,常见手段是合并连接(单连接多路复用)或按服务分组限流连接数。
- 【L4】心跳间隔要与中间设备(LB、NAT)的空闲超时配合,若心跳周期大于链路上设备的空闲断连阈值,连接会被静默掐断,表现为偶发超时。
🔀 发散问题
心跳除了保活还有什么用? 可作为健康检查的探活手段,连续失败可将节点移入亚健康列表,详见本文档『如何实现 RPC 的健康检查?』。
短连接就一无是处吗? 低频、请求量小的场景下短连接资源占用低、无需维护心跳,反而更简单可靠。
【中等】什么是 Triple 协议?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:8 min | 🏷 标签:分布式通信 / Triple 协议
💎 关键结论
Triple 是 Dubbo3 设计的、基于 HTTP 的 RPC 协议规范,也是 Dubbo3 主推的下一代协议,完全兼容 gRPC。理由:它让 Dubbo 获得 HTTP/2 的多路复用、流式通信与网关穿透能力,同时无缝接入 gRPC 生态。
⚡ 记忆卡片
- 口诀:Dubbo3 主推协议,跑在 HTTP 上,和 gRPC 互通。
- 关键词:Dubbo3/HTTP/2/兼容 gRPC/流式通信/不绑定 IDL
- 链路:Dubbo3 需要 HTTP 生态能力 → 设计 Triple 协议 → 基于 HTTP/1、HTTP/2 运行 → 兼容 gRPC、穿透网关 → 支持流式与多路复用
📖 核心知识
Triple 协议是 Dubbo3 设计的基于 HTTP 的 RPC 通信协议规范,是 Dubbo3 主推的下一代协议(在 Dubbo 3.x 中通常需把服务端口协议显式配置为 tri 来启用;Dubbo2 协议仍是长期兼容选项,两者可并行暴露)。
核心特性:
- 完全兼容 gRPC:基于 HTTP/2,与 gRPC 协议互通。
- 支持多种通信模型:Request-Response(Unary)、Streaming 流式(Unary/Server/Client/Bi-directional)。
- 运行在 HTTP/1 和 HTTP/2 之上:可直接用 curl、浏览器访问后端 Dubbo 服务。
- 不绑定 IDL:虽然支持 Protobuf,但也可以使用 Java 接口定义服务。
- 网关穿透性好:标准 HTTP 协议,易于穿过 Nginx、API Gateway、Service Mesh。
Triple vs Dubbo2 协议:
| 维度 | Dubbo2 协议 | Triple 协议 |
|---|---|---|
| 传输层 | TCP | HTTP/2(也可 HTTP/1) |
| 序列化 | Hessian2 | Protobuf(推荐)/Hessian2 |
| 流式通信 | 不支持 | 支持(4 种流式模式) |
| 网关穿透 | 差 | 好 |
| 浏览器访问 | 不支持 | 支持 |
| 跨语言 | 弱 | 强(兼容 gRPC 生态) |
| 多路复用 | 单连接 + 应用层多路复用 | HTTP/2 原生 Stream 级多路复用 |
关于「Dubbo2 协议是不是串行」
常见误解是「Dubbo2 协议一条连接只能串行处理一个请求」。这是错的:Dubbo2 协议同样是单条长连接上并发多个请求,靠协议头里的 requestId 把响应关联回对应的 Future(详见本文档『如何实现 RPC 异步调用?』)——否则 connections=1 的默认配置根本不可能支撑高并发。
两者的真实差别在层次:Dubbo2 的多路复用是应用层自己实现的(框架维护 requestId → Future 映射表),没有流级流量控制、没有头部压缩、也不能被通用 HTTP 基础设施(网关、Mesh Sidecar、浏览器)理解;HTTP/2 的多路复用是协议原生的,每个 Stream 有独立的流量控制窗口,头部由 HPACK 压缩,因此天然支持流式调用与背压。
🔀 发散问题
流式通信有哪几种模式? Unary、Server Streaming、Client Streaming、双向流四种,详见本文档『什么是 RPC 流式调用?有哪些模式?』。
为什么不直接在 Dubbo2 协议上改进? Dubbo2 协议是定长头的 TCP 私有协议,难以承载 HTTP 生态能力与平滑扩展,因此 Dubbo3 选择另起 HTTP 协议栈。
【中等】RPC 在网络通信上倾向选择哪种网络 IO 模型?⭐⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:10 min | 🏷 标签:分布式通信 / 网络 IO 模型
💎 关键结论
RPC 网络通信通常选择 IO 多路复用(Reactor 模式)。理由:RPC 是典型高并发场景,多路复用让少量线程管理海量连接,兼顾内核与语言生态支持,Java 首选基于 Reactor 的 Netty。
⚡ 记忆卡片
- 口诀:高并发选多路复用,Java 网络通信找 Netty。
- 关键词:BIO/NIO/IO 多路复用/AIO/Reactor
- 链路:RPC 高并发连接 → 一线程一连接扛不住 → IO 多路复用统一监听 → Reactor 分发事件 → 少量线程处理海量连接
📖 核心知识
一次 RPC 调用,本质就是服务消费者与服务提供者间的一次网络信息交换的过程。可见,通信是 RPC 实现的核心。
常见的网络 IO 模型分为四种:同步阻塞 IO(BIO)、同步非阻塞 IO(NIO)、IO 多路复用和异步非阻塞 IO(AIO)。在这四种 IO 模型中,只有 AIO 为异步 IO,其他都是同步 IO。
什么是 IO 多路复用?字面上的理解,多路就是指多个通道,也就是多个网络连接的 IO,而复用就是指多个通道复用在一个复用器上。IO 多路复用(Reactor 模式)在高并发场景下使用最为广泛,很多知名软件都应用了这一技术,如:Netty、Redis、Nginx 等。
RPC 调用在大多数的情况下,是一个高并发调用的场景,考虑到系统内核的支持、编程语言的支持以及 IO 模型本身的特点,在 RPC 框架的实现中,在网络通信的处理上,通常会选择 IO 多路复用的方式。开发语言的网络通信框架的选型上,最优的选择是基于 Reactor 模式实现的框架,如 Java 语言,首选的框架便是 Netty 框架(Java 还有很多其他 NIO 框架,但目前 Netty 应用得最为广泛),并且在 Linux 环境下,也要开启 epoll 来提升系统性能(Windows 环境下是无法开启 epoll 的,因为系统内核不支持)。
🔬 扩展知识
详情
- 【L3】Reactor 模式可细分为单 Reactor 单线程、单 Reactor 多线程、主从 Reactor 多线程三种形态;Netty 的 BossGroup/WorkerGroup 即主从 Reactor,Boss 负责 accept,Worker 负责 IO 读写。
- 【L4】Linux 下 epoll 相比 select/poll 通过回调机制将就绪事件时间复杂度降到 O(1) 级别,且无最大文件描述符数量限制,是海量连接服务的基础;io_uring 则是更新的异步 IO 方向。
- 【L4】IO 线程与业务线程池必须隔离——这是 RPC 通信层最重要的一条设计纪律,也是最常见的雪崩根因。
- 约束来自 Netty 的线程模型:一个
EventLoop(本质是一个绑定线程 + 一个 Selector + 一个任务队列)会被固定分配给一批 Channel,且绑定关系一旦建立就终身不变(AbstractChannel构造时从EventLoopGroup里取一个 EventLoop 并持有)。因此一个 EventLoop 要负责它名下所有连接的读写。 - 后果:如果在 EventLoop 线程里执行了阻塞操作(同步查数据库、同步调下游 RPC、
Future.get()、加锁等待),被阻塞的不是一个请求,而是这个 EventLoop 名下的全部连接——它们的读写事件全部停止处理。几个 EventLoop 被占满,整个通信层就雪崩了,且监控上表现为"连接都在、端口都通,但所有请求超时",非常难定位。 - 正确做法:业务处理必须派发到独立的业务线程池。Netty 层面有两种:把业务 Handler 用
EventExecutorGroup注册进 Pipeline(Netty 自动把该 Handler 的执行切到独立线程组),或在 Handler 内显式businessExecutor.submit(...)。RPC 框架层面,Dubbo 通过 Dispatcher 扩展点决定派发到哪个线程池(all全部派发、direct直接在 IO 线程执行、message只派发请求响应消息、execution、connection),默认是all,配合threadpool(fixed/cached/limited/eager)与threads参数控制业务线程池。 - 业务线程池打满怎么办:应当快速拒绝(Dubbo 抛线程池耗尽异常并附带当前池状态快照),而不是无界排队——无界队列会把「服务端过载」伪装成「客户端超时」,让上游一直重试,反而放大流量。这与『如何实现 RPC 的健康检查?』里"TCP 探活发现不了业务线程池打满"是同一个故障的两面。
- 回调同样不能跑在 IO 线程上:异步 RPC 的响应回调若直接在 EventLoop 里执行用户逻辑,等价于在 IO 线程做业务,详见本文档『如何实现 RPC 异步调用?』。
- 约束来自 Netty 的线程模型:一个
📚 交叉阅读:Netty 侧的
EventLoop运行循环、ioRatio、水平触发与业务隔离的完整机制,见《Netty 面试》『什么是 Reactor 线程模型?』与『EventLoop 是如何工作的?』——那是本知识点的权威版本,本篇只讲 RPC 框架如何使用它。
🔀 发散问题
为什么不选 BIO? 一连接一线程在海量连接下线程数爆炸,上下文切换与内存开销不可接受。
为什么 RPC 很少直接用 AIO? Linux 原生 AIO 支持不成熟(多数实现仍基于 epoll 模拟),且编程模型复杂,收益不如 IO 多路复用明显。
【中等】什么是零拷贝?⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:15 min | 🏷 标签:分布式通信 / 零拷贝
💎 关键结论
零拷贝就是取消用户空间与内核空间之间的多余数据拷贝,让数据通过 DMA 直接在内存与网卡间流动,省去 CPU 拷贝与上下文切换。理由:传统读写要在用户态和内核态间来回拷贝两次,CPU 与性能损耗大。
⚡ 记忆卡片
- 口诀:少一次拷贝,少一次切换;DMA 干活,CPU 歇着。
- 关键词:用户空间/内核空间/DMA/sendfile/mmap
- 链路:传统 IO 用户态内核态来回拷贝 → CPU 上下文切换开销大 → 零拷贝绕过用户态中转 → DMA 直接搬运数据 → CPU 与带宽节省
📖 核心知识
系统内核处理 IO 操作分为两个阶段——等待数据和拷贝数据。等待数据,就是系统内核在等待网卡接收到数据后,把数据写到内核中;而拷贝数据,就是系统内核在获取到数据后,将数据拷贝到用户进程的空间中。

应用进程的每一次写操作,都会把数据写到用户空间的缓冲区中,再由 CPU 将数据拷贝到系统内核的缓冲区中,之后再由 DMA 将这份数据拷贝到网卡中,最后由网卡发送出去。这里我们可以看到,一次写操作数据要拷贝两次才能通过网卡发送出去,而用户进程的读操作则是将整个流程反过来,数据同样会拷贝两次才能让应用程序读取到数据。
应用进程的一次完整的读写操作,都需要在用户空间与内核空间中来回拷贝,并且每一次拷贝,都需要 CPU 进行一次上下文切换(由用户进程切换到系统内核,或由系统内核切换到用户进程),这样很浪费 CPU 和性能。
所谓的零拷贝,就是取消用户空间与内核空间之间的数据拷贝操作,应用进程每一次的读写操作,可以通过一种方式,直接将数据写入内核或从内核中读取数据,再通过 DMA 将内核中的数据拷贝到网卡,或将网卡中的数据 copy 到内核。

Netty 中的零拷贝优化(偏向用户空间的数据操作优化):
- Netty 框架中很多内部的 ChannelHandler 实现类,都是通过 CompositeByteBuf、slice、wrap 操作来处理 TCP 传输中的拆包与粘包问题的,这对处理 TCP 传输中的拆包粘包问题有着重要的意义,对应用程序处理请求数据与返回数据也有重要的意义。
- Netty 的 ByteBuffer 可以采用 Direct Buffers,使用堆外直接内存进行 Socket 的读写操作,省去了「JVM 堆内字节数组 → JNI 临时本地缓冲区」这一次额外拷贝(JDK 在写 Socket 前会把堆内数组先复制到一块临时的直接内存,因为 GC 可能移动堆内对象)。注意这与 mmap 不是一回事:Direct Buffer 优化的仍是「用户态内部的一次中转拷贝」,数据依旧要经
write()系统调用进入内核缓冲区;而 mmap 是把内核缓冲区直接映射进进程地址空间,让应用可以像访问内存一样访问它。二者都叫"减少拷贝",但机制与适用场景完全不同。 - Netty 还提供 FileRegion 中包装 NIO 的 FileChannel.transferTo() 方法实现了零拷贝,这与 Linux 中的 sendfile 方式在原理上也是一样的。
🔬 扩展知识
详情
- 【L3】操作系统层面的零拷贝主要有两种:sendfile(文件描述符到 socket 的直接传输)与 mmap(将内核缓冲区映射到用户空间减少一次拷贝),Kafka 高吞吐的重要原因之一就是大量使用 sendfile。
- 【L3】别把 Kafka 的两种机制搞混(高频讹传点):Kafka 写消息日志用的是普通的
write(),数据先进内核页缓存(PageCache),由内核异步刷盘,不是 mmap 写入;mmap 在 Kafka 里只用于索引文件(.index/.timeindex,小且随机访问频繁,映射进地址空间读写更划算);而消费走的是sendfile,把日志段文件的数据从页缓存直接送到 socket,全程不进用户态。所以「Kafka 靠 mmap 写日志所以快」这个说法是错的,正确表述是「顺序写 + 页缓存 + 消费侧 sendfile」。 - 【L4】Netty 的"零拷贝"与操作系统零拷贝层次不同:它主要在用户态通过 ByteBuf 组合、切片、堆外内存避免 JVM 内部的冗余拷贝,二者常结合使用。
- 【L4】RPC 框架里零拷贝真正生效的位置其实很有限:RPC 报文必须被反序列化成 Java 对象才能交给业务代码,这意味着数据一定要进用户态堆内存,
sendfile那条「文件 → socket 不经用户态」的路径用不上。RPC 能吃到的是 Netty 用户态零拷贝(CompositeByteBuf合并头体不做物理拷贝、slice()/duplicate()共享底层内存、Direct Buffer 省一次 JNI 中转),以及堆外内存池化带来的 GC 压力下降。能把「零拷贝」分成 OS 级与用户态级两层来答,是这题的分水岭。
📚 延伸阅读:深入剖析Linux IO原理和几种零拷贝机制的实现
📚 交叉阅读:
sendfile/mmap/splice的系统调用细节、DMA 与 CPU 拷贝次数的完整推演,权威版本在《操作系统面试》的零拷贝题;Netty 侧CompositeByteBuf、slice、FileRegion与引用计数的关系见《Netty 面试》。本篇只保留与 RPC 报文收发直接相关的部分,避免三处重复。
🔀 发散问题
零拷贝和堆外内存是什么关系? 使用 Direct Buffer 可避免 JVM 堆与堆外之间的一次中转拷贝,是 Netty 用户态零拷贝的手段之一。
为什么拆包粘包处理也能"零拷贝"? 用 CompositeByteBuf、slice 等逻辑视图组合数据,避免了物理合并时的内存复制。
动态代理
【中等】RPC 如何将远程调用转为本地调用的?⭐⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:10 min | 🏷 标签:分布式通信 / 动态代理
💎 关键结论
RPC 的远程过程调用是通过动态代理实现的:框架为服务接口生成代理类,方法调用被代理拦截后注入远程调用逻辑,用户感知到的仍是本地调用。理由:代理把"调哪个方法、传什么参数"转译为网络请求,是屏蔽通信细节的关键。
⚡ 记忆卡片
- 口诀:接口生成代理,调用即拦截,远程变本地。
- 关键词:动态代理/InvocationHandler/Javassist/Byte Buddy
- 链路:注入服务接口 → 实际绑定代理类 → 方法调用被拦截 → 代理组装远程请求 → 返回结果如同本地调用
📖 核心知识
RPC 的远程过程调用是通过动态代理实现的。
RPC 框架会自动为要调用的接口生成一个代理类。当在项目中注入接口的时候,运行过程中实际绑定的就是这个接口生成的代理类。在接口方法被调用时,会被代理类拦截,这样,就可以在生成的代理类中,加入远程调用逻辑。

除了 JDK 默认的 InvocationHandler 能完成代理功能,还有很多其他的第三方框架也可以,比如像 Javassist、Byte Buddy 这样的框架。
单纯从代理功能上来看,JDK 默认的代理功能是有一定的局限性的,它要求被代理的类只能是接口。原因是因为生成的代理类会继承 Proxy 类,但 Java 是不支持多重继承的。此外,由于它生成后的代理类是使用反射来完成方法调用的,而这种方式相对直接用编码调用来说,性能会降低。
代理的实现方式与各自的边界(P8 会追问「为什么 RPC 框架不用反射」,答案就在这张表里):
| 方式 | 机制 | 硬约束 | 在 RPC 里的角色 |
|---|---|---|---|
| JDK 动态代理 | 运行时生成实现目标接口的 $Proxy 类,方法体统一转发到 InvocationHandler.invoke(),最终靠 Method.invoke() 反射调用 | 只能代理接口(生成的类已继承 java.lang.reflect.Proxy,Java 单继承) | 消费端 Stub 的经典实现,够用但服务端反射调用有开销 |
| CGLIB | 运行时生成目标类的子类,用 MethodInterceptor 拦截,通过 FastClass 的索引直接调用方法而非反射 | 不能代理 final 类,不能拦截 final/private/static 方法;需要无参构造可用 | Spring AOP 在无接口时的兜底方案 |
| Javassist | 源码级字节码编辑:可以用 Java 源码字符串描述要插入的逻辑,编译进 ClassPool 生成类 | 生成的是真实字节码,无接口/继承限制 | Dubbo 默认:既用于生成消费端代理,也用于生成服务端的 Wrapper 类 |
| ByteBuddy | 流式 DSL 描述字节码变换,API 比 Javassist 更现代、对新版 JDK 适配更好 | 同上 | Mockito 等框架采用;也是 Dubbo 等框架可选的字节码工具 |
MethodHandle / LambdaMetafactory | JDK 7/8 引入的方法句柄,由 JVM 直接支持,可被 JIT 内联;LambdaMetafactory 进一步把句柄包装成 lambda 实例 | 需要 MethodHandles.Lookup 具备访问权限 | 性能上限最高的方案,接近直接调用 |
性能梯度:为什么「反射 → 字节码 Wrapper → MethodHandle」是三个台阶
- 反射(
Method.invoke())无法被 JIT 内联。调用要经过参数装箱进Object[]、访问权限检查、以及一层层的NativeMethodAccessorImpl→MethodAccessor委派(JDK 在调用次数超过阈值后会动态生成字节码版 Accessor 来加速,即 inflation 机制,但仍有额外一层间接)。无法内联意味着方法调用边界处的所有后续优化(逃逸分析、常量折叠、锁消除)都做不了,这在每秒百万次的 RPC 调用上是实打实的 CPU 开销。 - Javassist 生成的 Wrapper 类是「直接方法调用」。Dubbo 在服务导出时,为实现类生成一个
Wrapper子类,把invokeMethod(instance, methodName, paramTypes, args)展开成一段真实的if/switch + 强转参数 + obj.method(args)字节码。运行时不再有任何反射,方法调用是静态可解析的,JIT 可以正常内联。这就是 Dubbo 不用反射调用业务方法的根本原因——不是"Javassist 比反射快一点",而是"只有绕开反射才能拿到内联优化"。 MethodHandle/LambdaMetafactory可被 JIT 内联,理论上性能最接近直接调用。它是 JVM 层面的构造(invokedynamic的底层),但工程上要处理 Lookup 权限、句柄缓存与异常包装,收益相对 Wrapper 方案并不总是明显,所以主流 RPC 框架目前仍以字节码生成 Wrapper 为主。
一个必须区分的边界
「Spring AOP 用 CGLIB」和「Dubbo 用 Javassist」是两件独立的事,不要混为一谈。 Spring AOP 的默认代理策略是:目标类有接口时用 JDK 动态代理,无接口时用 CGLIB;Spring Boot 2.x 起 spring.aop.proxy-target-class 默认为 true,即统一走 CGLIB,而这个 CGLIB 是 Spring 重新打包进 spring-core 的内嵌 fork(org.springframework.cglib.*),并非引入外部 CGLIB 依赖,也不是 ByteBuddy。ByteBuddy 是另一条线:Mockito 用它做 mock,部分框架用它做字节码增强。把「Spring Boot 3 改用 ByteBuddy 替代 CGLIB」当结论说出来,是近年流传的一个讹传。
🔬 扩展知识
详情
- 【L3】JDK 动态代理基于接口 + 反射;Javassist/Byte Buddy 通过字节码生成代理类,可直接调用方法、避免反射开销,因此高性能 RPC 框架常选字节码方案。
- 【L4】代理对象通常在框架启动阶段一次性生成并缓存,运行期只执行拦截逻辑,避免重复生成代理带来的启动与内存开销。
📚 延伸阅读:深入理解 Java 反射和动态代理
🔀 发散问题
代理拦截到调用之后做什么? 组装消息、序列化并发送请求,详见本文档『RPC 是怎样工作的?』。
没有接口的情况下还能发起调用吗? 可以,通过泛化调用以字符串方式描述接口与方法,详见本文档『RPC 如何实现泛化调用?』。
服务注册发现
【中等】如何实现一个注册中心?⭐⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:15 min | 🏷 标签:分布式通信 / 服务注册发现
💎 关键结论
注册中心的核心就两件事:服务注册(提供方启动时把 IP+接口写入注册中心)与服务订阅(调用方启动时拉取并缓存地址列表,后续靠变更通知保持新鲜)。理由:集群里节点动态变化,调用方必须有个权威来源才能找到通信地址。
⚡ 记忆卡片
- 口诀:提供方注册,调用方订阅,变更靠通知,地址本地缓存。
- 关键词:服务注册/服务订阅/Watcher 通知/本地缓存/AP 优先
- 链路:提供方启动注册地址 → 调用方订阅并缓存 → 节点变更触发通知 → 调用方更新本地列表 → 负载均衡选节点发起调用
📖 核心知识
RPC 框架必须要有服务注册和发现机制,这样,集群中的节点才能知道通信方的请求地址。

- 服务注册:在服务提供方启动的时候,将对外暴露的接口注册到注册中心之中,注册中心将这个服务节点的 IP 和接口保存下来。
- 服务订阅:在服务调用方启动的时候,去注册中心查找并订阅服务提供方的 IP,然后缓存到本地,并用于后续的远程调用。
基于 ZooKeeper 的服务发现:
使用 ZooKeeper 作为服务注册中心,是 Java 分布式系统的经典方案。
搭建一个 ZooKeeper 集群作为注册中心集群,服务注册的时候只需要服务节点向 ZooKeeper 节点写入注册信息即可,利用 ZooKeeper 的 Watcher 机制完成服务订阅与服务下发功能。

🔬 扩展知识
详情
- 【L3】通常可以使用 ZooKeeper、etcd 或者分布式缓存(如 Hazelcast)来解决事件通知问题,但当集群达到一定规模之后,依赖的 ZooKeeper 集群、etcd 集群可能就不稳定了,无法满足需求。
- 【L3】在超大规模的服务集群下,注册中心所面临的挑战就是超大批量服务节点同时上下线,注册中心集群接受到大量服务变更请求,集群间各节点间需要同步大量服务节点数据,最终导致:注册中心负载过高;各节点数据不一致;服务下发不及时或下发错误的服务节点列表。
- 【L4】RPC 框架依赖的注册中心的服务数据的一致性其实并不需要满足 CP,只要满足 AP 即可——短暂的数据不一致可由调用端容错兜底,而注册中心不可用则会阻断全部新连接建立。
- 【L4】为什么 ZooKeeper 不适合做注册中心(P8 的标准追问):ZK 是 CP 系统,写请求必须由 Leader 处理并经 ZAB 协议在多数派(
⌊N/2⌋+1)提交后才返回。Leader 挂掉到选出新 Leader 的这段选举窗口内,整个集群不可写、对外表现为不可用(默认选举相关的超时是秒级到十几秒量级,取决于tickTime与syncLimit配置)。而注册中心的核心诉求是:服务地址短暂读到旧数据没关系(调用端有健康列表、失败重试、负载均衡兜底),但注册中心不可用会立刻阻断所有新实例上线与地址变更传播。所以 AP 优先——Nacos 的临时实例走 Distro 协议(AP,每个节点负责一部分数据、异步复制、可就近读写),持久实例才走 Raft(CP);Eureka 更是极端的 AP(自我保护机制下宁可返回过期列表也不摘节点)。反过来说,配置中心(要求强一致、错一条配置可能全线故障)才更适合 CP。 - 【L4】客户端本地缓存是服务发现的性能与容灾基石,但也是「缓存失效窗口」的来源。调用方启动时全量拉取地址列表并缓存在本地内存,之后靠注册中心的推送/Watcher 通知(ZK 的 Watcher、Nacos 2.x 的 gRPC 长连接推送)+ 定时全量刷新兜底(防止推送丢失)来维持新鲜度。这套机制的必然代价是:从「一个实例真的死了」到「所有调用方的本地列表都不再包含它」之间存在一个不可消除的时间窗,窗口内的流量必然打到死实例上——这正是集群容错(Failover)与客户端健康列表必须存在的原因,也是『如何实现 RPC 优雅关闭?』里"必须靠异常引导重试而不能只靠注册中心摘除"的根本依据。注册中心全挂时,客户端应能用本地磁盘快照(如 Dubbo 的
dubbo-resolve.properties/ 缓存文件、Nacos 的 failover 目录)继续调用已有服务,只是无法感知新的地址变更。 - 【L4】Dubbo 3 的应用级服务发现(Application-Level Service Discovery)——Dubbo 3 最重大的架构变更,也是「技术演进跟踪」的必答点。
- 接口级模型的问题:Dubbo 2 注册的是「接口」维度的地址,一个应用暴露 N 个接口、部署 M 个实例,注册中心就要存 N×M 条记录,且每次实例上下线要推送 N 条变更。当单应用接口数达到数百、实例数达到数千时,注册中心的存储量与推送量都是乘积级膨胀,这也是 ZK 在大规模 Dubbo 集群下撑不住的直接原因。
- 应用级模型的做法:注册粒度改为「应用实例」——一个实例只注册一条记录(应用名 + IP:Port + 少量元信息),地址数据量从 N×M 降到 M。接口与应用实例的映射关系、以及每个接口的方法签名/参数类型等详细信息,从注册中心搬到独立的元数据中心(MetadataService / 元数据中心),由消费方按需查询与缓存。
- 收益与代价:注册中心的存储与推送压力量级下降,扩缩容与发布期间的推送风暴被显著抑制;同时与 Spring Cloud / Kubernetes Service 的模型对齐(K8s 的 Service、Spring Cloud 的注册项本来就是应用/服务维度而非接口维度),使得 Dubbo 应用能直接被 Mesh 与 K8s 原生服务发现接管。代价是消费方多一次元数据获取、且迁移期需要接口级与应用级双注册/双订阅并存(Dubbo 3 提供
register-mode相关配置支持interface/instance/all),以保证滚动升级期间新老版本互相可见。
- 【L4】注册中心的容量瓶颈通常不在存储而在推送:一次滚动发布若同时重启大量实例,会在秒级内产生「实例数 × 订阅者数」量级的变更通知,把注册中心的网络与 CPU 打满,表现为发布期间服务发现大面积延迟。治理手段是分批发布、变更合并与去抖动(把短时间内的多次变更合并成一次推送)、以及上面说的应用级模型降低单次变更的扇出。
🔀 发散问题
订阅之后,调用方如何保持地址列表的新鲜? 依赖注册中心的变更通知(如 ZooKeeper 的 Watcher 机制)实时推送 + 本地缓存,节点上下线时及时更新列表。
注册中心与负载均衡是什么关系? 注册中心负责提供可用的节点列表,负载均衡负责在列表内选出具体节点,详见本文档『负载均衡有哪些策略?』。
负载均衡
【中等】负载均衡有哪些策略?⭐⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:10 min | 🏷 标签:分布式通信 / 负载均衡
💎 关键结论
负载均衡的本质是"从多个节点中选一个来处理请求",常见策略从简单的随机、轮询,到加权、最少活跃、一致性哈希,复杂度和效果递增。理由:不同策略在公平性、性能感知、缓存亲和性上各有取舍,要按场景选。
⚡ 记忆卡片
- 口诀:随机轮询打底,加权最少活跃进阶,一致性哈希保缓存。
- 关键词:随机/轮询/加权轮询/最少活跃/一致性哈希
- 链路:拿到服务节点列表 → 按策略计算目标节点 → 分发请求 → 依据反馈调整权重
📖 核心知识
RPC 客户端负载均衡常见策略速览(各算法的原理推导、图示与适用边界详见《分布式调度面试》『负载均衡有哪些算法?』):
- 随机(Random):按概率随机选择节点,实现简单,请求量足够大时趋向均匀;节点性能不一致时不够公平。
- 轮询(Round Robin):按顺序依次选择节点,绝对公平;但不感知节点实际负载,慢节点会拖累整体。
- 加权轮询(Weighted Round Robin):为节点设置权重,按权重比例分配流量,适合异构机器混布。
- 最少活跃(Least Active):选择当前活跃请求数最少的节点,能自动把流量从慢节点挪走,需要调用端统计每个节点的活跃数。
- 一致性哈希(Consistent Hash):按参数哈希落到固定节点,同源请求总打到同一节点,利于缓存亲和;需引入虚拟节点解决数据倾斜。
- 最短响应时间(Shortest Response):把请求发给「滑动窗口内平均响应时间最短 + 活跃数最少」的节点,本质是用 P99/平均耗时做显式的性能感知,比最少活跃更直接,但也更容易被一次偶发慢请求带偏,需要平滑窗口。
Dubbo 的默认策略是「加权随机」(RandomLoadBalance),不是轮询。随机的好处是无状态、天然抗节点数变化;按权重随机则在异构机器混布时把流量按 weight 比例分配。
加权轮询用的是「平滑加权轮询」(Smooth Weighted Round-Robin),这是容易被答错的一点:朴素的加权轮询会把高权重节点的请求连续排在一起(如权重 A=5、B=1、C=1 时选出 AAAAABC),造成瞬时流量尖刺。平滑加权轮询为每个节点维护 currentWeight,每轮给所有节点加上自己的 weight,选出 currentWeight 最大者并把它的 currentWeight 减去总权重,得到的序列是打散的(AABACAA),长期比例仍严格等于权重比,但短期分布均匀。Nginx 的 smooth=true 加权轮询用的是同一算法。
「为什么最少活跃数能自动避开慢节点」是 P8 的高频追问,答案要点是:活跃数 = 已发出但尚未收到响应的请求数。同样的到达速率下,慢节点的请求滞留时间更长,积压的活跃数自然更高,于是策略会少选它——无需任何显式的性能探测,只用「在途请求数」这一个本地计数器,就隐式地实现了对节点处理能力的感知。这也解释了它的失效场景:如果调用方与节点之间的网络抖动导致响应延迟(而非节点本身慢),活跃数同样会升高,此时会误判。
🔬 扩展知识
详情
- 【L3】静态策略(随机/轮询)不感知节点状态,动态策略(最少活跃/自适应打分)依赖运行时指标,准确但实现复杂,详见本文档『如何设计自适应的负载均衡?』。
- 【L4】负载均衡可以叠加预热权重:新启动节点逐步升权,避免冷节点被瞬时流量打垮,详见本文档『如何实现 RPC 优雅启动?』。
📚 延伸阅读:负载均衡基本原理
🔀 发散问题
为什么最少活跃能避开慢节点? 慢节点请求处理慢,积压的活跃请求数就高,策略自然会少选它,实现隐式的性能感知。
一致性哈希适合什么场景? 适合同参数请求希望落到同节点的场景,如会话保持、本地缓存命中优化。
【中等】如何设计自适应的负载均衡?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:15 min | 🏷 标签:分布式通信 / 自适应负载均衡
💎 关键结论
自适应负载均衡的核心是"指标收集 + 打分 + 动态权重":调用方采集每个节点的负载、耗时、状态指标,综合打分后按比例修正节点权重,再配合随机权重策略分发流量。理由:静态权重反映不了节点实时健康状况,让分数驱动权重才能把流量自动导向健康节点。
⚡ 记忆卡片
- 口诀:收指标、算打分、改权重、随机选。
- 关键词:指标收集器/综合打分/动态权重/随机权重策略
- 链路:心跳与请求中收集指标 → 按权重综合打分 → 分数折算节点最终权重 → 随机权重策略选节点 → 流量自动倾斜向健康节点
📖 核心知识
可以采用一种打分的策略,服务调用者收集与之建立长连接的每个服务节点的指标数据,如服务节点的负载指标、CPU 核数、内存大小、请求处理的耗时指标(如请求平均耗时、TP99、TP999)、服务节点的状态指标(如正常、亚健康)。通过这些指标,计算出一个分数,比如总分 10 分,如果 CPU 负载达到 70%,就减它 3 分,当然了,减 3 分只是个类比,需要减多少分是需要一个计算策略的。可以为每个指标都设置一个指标权重占比,然后再根据这些指标数据,计算分数。
可以配合随机权重的负载均衡策略去控制,通过最终的指标分数修改服务节点最终的权重。例如给一个服务节点综合打分是 8 分(满分 10 分),服务节点的权重是 100,那么计算后最终权重就是 80(100*80%)。服务调用者发送请求时,会通过随机权重的策略来选择服务节点,那么这个节点接收到的流量就是其他正常节点的 80%(这里假设其他节点默认权重都是 100,且指标正常,打分为 10 分的情况)。
到这儿,一个自适应的负载均衡我们就完成了,整体的设计方案如下图所示:

关键步骤:
- 添加服务指标收集器,并将其作为插件,默认有运行时状态指标收集器、请求耗时指标收集器。
- 运行时状态指标收集器收集服务节点 CPU 核数、CPU 负载以及内存等指标,在服务调用者与服务提供者的心跳数据中获取。
- 请求耗时指标收集器收集请求耗时数据,如平均耗时、TP99、TP999 等。
- 可以配置开启哪些指标收集器,并设置这些参考指标的指标权重,再根据指标数据和指标权重来综合打分。
- 通过服务节点的综合打分与节点的权重,最终计算出节点的最终权重,之后服务调用者会根据随机权重的策略,来选择服务节点。
🔬 扩展知识
详情
- 【L3】指标来源分两类:节点侧指标(CPU、内存)靠心跳捎带上报,调用侧指标(耗时、成功率)靠调用端本地统计,二者结合才能既看"机器忙不忙"又看"请求顺不顺"。
- 【L4】打分权重的调参本质是灵敏度权衡:权重对指标变化越敏感,流量切换越快,但抖动与误判风险也越高,通常需要滞回(hysteresis)或平滑窗口抑制震荡。
🔀 发散问题
自适应负载均衡和静态加权轮询的区别? 静态权重人工设定、固定不变;自适应权重由实时指标驱动、动态调整。
打分数据多久更新一次合适? 通常与心跳周期或滑动统计窗口对齐,过密会增加统计与同步开销,过疏则反应迟钝。
监控
【中等】如何实现 RPC 的健康检查?⭐⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:10 min | 🏷 标签:分布式通信 / 健康检查
💎 关键结论
健康检查用频率适中的心跳检测目标机器状态,并用"可用率"做量化标准:可用率低于阈值的节点挪入亚健康列表。理由:纯连接存活判断太粗糙,可用率能同时兼容高低频接口与不同响应时间的差异。
⚡ 记忆卡片
- 口诀:心跳探活定状态,可用率量化健康。
- 关键词:心跳探活/健康/亚健康/死亡/可用率/时间窗口
- 链路:建立连接 → 心跳持续探活 → 统计时间窗口内可用率 → 低于阈值移入亚健康列表 → 负载均衡避开该节点
📖 核心知识
使用频率适中的心跳去检测目标机器的健康状态。
- 健康状态:建立连接成功,并且心跳探活也一直成功;
- 亚健康状态:建立连接成功,但是心跳请求连续失败;
- 死亡状态:建立连接失败。
可以使用可用率来作为健康状态的量化标准:
可用率 = 一个时间窗口内接口调用成功次数 / 总调用次数当可用率低于某个比例,就认为这个节点存在问题,把它挪到亚健康列表,这样既考虑了高低频的调用接口,也兼顾了接口响应时间不同的问题。
🔬 扩展知识
详情
- 【L3】心跳频率要适中:太频繁浪费带宽和 CPU,太稀疏则故障发现滞后;通常取秒级周期并允许连续若干次失败再判定异常,避免单次网络抖动误判。
- 【L4】健康检查结果应与摘除策略解耦:亚健康节点不一定立即摘除,可先降权(减少流量),持续恶化再摘除,给瞬时抖动留缓冲,避免节点在健康/异常间频繁震荡。
🏭 实战场景
详情
生产案例:某订单服务使用 TCP 长连接调用下游库存服务,健康检查采用 TCP connect 探活,每 10 秒检测一次,连续 3 次失败才摘除节点。某日凌晨流量高峰,库存服务因数据库连接池耗尽导致业务线程全部阻塞(线程池核心线程 200、最大线程 200,活跃线程数打满),但 TCP 端口仍正常监听,健康检查持续返回成功。结果该节点被路由框架持续分配流量,所有请求超时(耗时均超过 30 秒),用户侧表现为下单大面积失败,持续约 25 分钟才被运维人工发现。根因是 TCP 层探活只能检测进程存活,无法感知应用层业务逻辑是否正常工作。修复方案:将健康检查改为应用级心跳,在心跳包中嵌入一个轻量业务方法调用(如查询库存版本号),同时在线程池活跃数达到 80%(即 160 个线程)时触发告警,检测时间从原来的 30 秒缩短至 5 秒内自动摘除故障节点。
🔀 发散问题
心跳和长连接保活是一回事吗? 机制相同、目的不同:保活是维持连接不被断开,健康检查是判断节点能否继续承接流量,详见本文档『长连接 vs 短连接?』。
节点被摘除后又恢复了怎么办? 需要恢复探测(如小流量试探或心跳恢复)后再移回健康列表,防止反复抖动。
Dubbo 中健康检查如何落地? 在通用心跳探活、可用率量化之上,Dubbo 提供「心跳检测 + 注册中心剔除 + 接口级 HealthChecker」的多级机制,并可接入 K8s 探针,详见《Dubbo 面试之服务治理》『如何在 Dubbo 中使用健康检查?』。
RPC 的可观测性除了健康检查还有什么? 还有链路追踪——用 TraceId/SpanId 把跨服务调用还原成完整链路。其概念、实现流程(埋点/采样/传输/存储/展示)与主流方案(SkyWalking/Zipkin/Jaeger)详见《分布式治理面试》『如何实现链路追踪?』;Dubbo 中的落地见《Dubbo 面试之服务治理》『如何在 Dubbo 中处理服务调用链路追踪?』。
优雅启停
【中等】如何实现 RPC 优雅关闭?⭐⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:15 min | 🏷 标签:分布式通信 / 优雅关闭
💎 关键结论
优雅关闭的关键是"先摘流量、再等存量、最后退出":关闭前先通知注册中心下线并设置关闭标识,新请求返回特定异常引导调用方安全重试,存量请求用引用计数等待完成,超时则强制退出。理由:服务发现只保证最终一致性,无法做到实时摘除,必须靠异常重试与存量等待兑现业务无损。
⚡ 记忆卡片
- 口诀:先下线通知,再拒绝新请求,等存量完成,超时强退。
- 关键词:ShutdownHook/关闭标识/ShutdownException/引用计数器/超时强退
- 链路:捕获关闭信号 → 通知注册中心下线 → 挡板拦截新请求抛特定异常 → 调用方摘节点并安全重试 → 引用计数等待存量请求完成 → 超时则强制退出
📖 核心知识
当服务提供方要上线的时候,一般是通过部署系统完成实例重启。在这个过程中,服务提供方的团队并不会事先告诉调用方他们需要操作哪些机器,从而让调用方去事先切走流量。而对调用方来说,它也无法预测到服务提供方要对哪些机器重启上线,因此负载均衡就有可能把要正在重启的机器选出来,这样就会导致把请求发送到正在重启中的机器里面,从而导致调用方不能拿到正确的响应结果。

在服务重启的时候,对于调用方来说,这时候可能会存在以下几种情况:
- 调用方发请求前,目标服务已经下线。对于调用方来说,跟目标节点的连接会断开,这时候调用方可以立马感知到,并且在其健康列表里面会把这个节点挪掉,自然也就不会被负载均衡选中。
- 调用方发请求的时候,目标服务正在关闭,但调用方并不知道它正在关闭,而且两者之间的连接也没断开,所以这个节点还会存在健康列表里面,因此该节点就有一定概率会被负载均衡选中。
当出现第二种情况的时候,调用方业务会受损,如何避免这种问题呢。当服务提供方关闭前,是不是可以先通知注册中心进行下线,然后通过注册中心告诉调用方进行节点摘除?

如上图所示,整个关闭过程中依赖了两次 RPC 调用,一次是服务提供方通知注册中心下线操作,一次是注册中心通知服务调用方下线节点操作。注册中心通知服务调用方都是异步的。服务发现只保证最终一致性,并不保证实时性,所以注册中心在收到服务提供方下线的时候,并不能成功保证把这次要下线的节点推送到所有的调用方。所以这么来看,通过服务发现并不能做到应用无损关闭。
异常引导重试:当服务提供方正在关闭,如果这之后还收到了新的业务请求,服务提供方直接返回一个特定的异常给调用方(比如 ShutdownException)。这个异常就是告诉调用方"我已经收到这个请求了,但是我正在关闭,并没有处理这个请求",然后调用方收到这个异常响应后,RPC 框架把这个节点从健康列表挪出,并把请求自动重试到其他节点,因为这个请求是没有被服务提供方处理过,所以可以安全地重试到其他节点,这样就可以实现对业务无损。
捕获关闭事件:可以通过捕获操作系统的进程信号来获取,在 Java 语言里面,对应的是 Runtime.addShutdownHook 方法,可以注册关闭的钩子。在 RPC 启动的时候,我们提前注册关闭钩子,并在里面添加了两个处理程序,一个负责开启关闭标识,一个负责安全关闭服务对象,服务对象在关闭的时候会通知调用方下线节点。同时需要在我们调用链里面加上挡板处理器,当新的请求来的时候,会判断关闭标识,如果正在关闭,则抛出特定异常。
等待存量请求:关闭过程中已经在处理的请求会不会受到影响呢?如果进程结束过快会造成这些请求还没有来得及应答,同时调用方也会抛出异常。为了尽可能地完成正在处理的请求,首先我们要把这些请求识别出来。可以在服务对象加上引用计数器,每开始处理请求之前加一,完成请求处理减一,通过该计数器我们就可以快速判断是否有正在处理的请求。服务对象在关闭过程中,会拒绝新的请求,同时根据引用计数器等待正在处理的请求全部结束之后才会真正关闭。但考虑到有些业务请求可能处理时间长,或者存在被挂住的情况,为了避免一直等待造成应用无法正常退出,我们可以在整个 ShutdownHook 里面,加上超时时间控制,当超过了指定时间没有结束,则强制退出应用。超时时间我建议可以设定成 10s,基本可以确保请求都处理完了。

🔬 扩展知识
详情
- 【L3】下线通知与存量等待的顺序很重要:若先断连接再通知注册中心,调用方会在感知断开前仍可能把请求发过来;标准做法是"先设标识+通知下线 → 等存量 → 关连接/退进程"。
- 【L3】「发布窗口报错刷屏」的根因几乎总是这条时序被省略或压缩了。完整的下线时序是:① 从注册中心注销(deregister)→ ② 等待客户端本地缓存刷新到位(这是一个不可压缩的传播窗口,通常取秒级到十几秒)→ ③ 拒绝新请求并用引用计数等在途请求排空(连接排空)→ ④ 关闭连接池与 IO 线程 → ⑤ 退出进程。跳过 ②,调用方仍会把请求发给正在关闭的实例;跳过 ③,在途请求会被硬断开;把 ④ 放到 ① 之前,连接先断而注册信息还在,调用方会集中报「连接被重置」。步骤 ② 的等待时长必须覆盖注册中心的推送延迟 + 客户端的定时刷新周期,取二者之和的上界。
- 【L4】在容器化环境中,优雅关闭还需配合 K8s 的 preStop Hook 与 terminationGracePeriodSeconds:preStop 留出让服务发现传播下线信息的时间,优雅期需覆盖应用自身 ShutdownHook 超时。
- 【L4】
kill -9与 OOMKilled 会完全绕过 ShutdownHook,这是"明明实现了优雅关闭,发布时还是报错"的另一类根因。此时唯一能兜住的是调用方:连接被重置后客户端立即把该节点移出健康列表 + 集群容错重试到其他节点。优雅关闭是服务端义务,客户端容错是最后一道防线,两者缺一不可,不能因为做了优雅关闭就把retries设成 0。
🔀 发散问题
为什么 ShutdownException 可以安全重试? 因为请求被挡板拦截后根本没有被业务处理,不存在副作用,重试到其他节点不会造成重复执行。
优雅关闭的反面——启动阶段要注意什么? 新节点需要预热与延迟暴露,避免冷启动被流量打垮,详见本文档『如何实现 RPC 优雅启动?』。
【中等】如何实现 RPC 优雅启动?⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:15 min | 🏷 标签:分布式通信 / 优雅启动
💎 关键结论
优雅启动靠两招:启动预热(新节点权重随运行时间逐渐增加,流量缓慢爬坡)与延迟暴露(应用完全启动后才把服务注册到注册中心)。理由:刚启动的应用没有 JIT 编译红利和类缓存,直接承接全量流量会大面积超时。
⚡ 记忆卡片
- 口诀:权重随时间爬坡,注册等启动完成。
- 关键词:JIT 预热红利/启动预热/动态权重/延迟暴露/注册 Hook
- 链路:应用重启丢失 JIT/缓存红利 → 直接承流量会超时 → 预热降权、流量爬坡 → 延迟暴露避免提前被感知 → 平稳过渡到正常状态
📖 核心知识
运行了一段时间后的应用,执行速度会比刚启动的应用更快。这是因为在 Java 里面,在运行过程中,JVM 虚拟机会把高频的代码编译成机器码,被加载过的类也会被缓存到 JVM 缓存中,再次使用的时候不会触发临时加载,这样就使得"热点"代码的执行不用每次都通过解释,从而提升执行速度。
但是这些"临时数据",都在应用重启后就消失了。重启后的这些"红利"没有了之后,如果让刚启动的应用就承担像停机前一样的流量,这会使应用在启动之初就处于高负载状态,从而导致调用方过来的请求可能出现大面积超时,进而对线上业务产生损害行为。
启动预热:就是让刚启动的服务提供方应用不承担全部的流量,而是让它被调用的次数随着时间的移动慢慢增加,最终让流量缓和地增加到跟已经运行一段时间后的水平一样。如何做到这点呢?
首先,对于调用方来说,我们要知道服务提供方启动的时间。一种是服务提供方在启动的时候,把自己启动的时间告诉注册中心;另外一种就是注册中心收到的服务提供方的请求注册时间。因为整个预热过程的时间是一个粗略值,即使机器之间的日期时间存在 1 分钟的误差也不影响,并且在真实环境中机器都会默认开启 NTP 时间同步功能,来保证所有机器时间的一致性。
不管你是选择哪个时间,最终的结果就是,调用方通过服务发现,除了可以拿到 IP 列表,还可以拿到对应的启动时间。接着,可以利用加权负载均衡算法来分发流量。现在,需要让这个权重变为动态的,并且是随着时间的推移慢慢增加到服务提供方设定的固定值。

通过这个小逻辑的改动,我们就可以保证当服务提供方运行时长小于预热时间时,对服务提供方进行降权,减少被负载均衡选择的概率,避免让应用在启动之初就处于高负载状态,从而实现服务提供方在启动后有一个预热的过程。
延迟暴露:服务提供方应用在没有启动完成的时候,调用方的请求就过来了,而调用方请求过来的原因是,服务提供方应用在启动过程中把解析到的 RPC 服务注册到了注册中心,这就导致在后续加载没有完成的情况下服务提供方的地址就被服务调用方感知到了。
为了解决这个问题,需要在应用启动加载、解析 Bean 的时候,如果遇到了 RPC 服务的 Bean,只先把这个 Bean 注册到 Spring-BeanFactory 里面去,而并不把这个 Bean 对应的接口注册到注册中心,只有等应用启动完成后,才把接口注册到注册中心用于服务发现,从而实现让服务调用方延迟获取到服务提供方地址。
具体如何实现呢?我们可以在服务提供方应用启动后,接口注册到注册中心前,预留一个 Hook 过程,让用户可以实现可扩展的 Hook 逻辑。用户可以在 Hook 里面模拟调用逻辑,从而使 JVM 指令能够预热起来,并且用户也可以在 Hook 里面事先预加载一些资源,只有等所有的资源都加载完成后,最后才把接口注册到注册中心。

🔬 扩展知识
详情
【L3】Dubbo 的预热权重实际用的是「平方曲线」而非线性,其
calculateWarmupWeight的核心逻辑等价于:// uptime:实例已运行时长;warmup:预热窗口;weight:配置的目标权重 int ww = (int) (Math.pow(uptime / (double) warmup, 2) * weight); return ww < 1 ? 1 : Math.min(ww, weight);即
最终权重 = (uptime / warmup)² × weight,并做双向夹逼:下限为 1(保证刚启动的实例仍能收到极少量流量,从而真正触发 JIT 编译与缓存加载,而不是完全空转)、上限为weight(预热结束后不超过配置权重)。选平方而非线性,是为了让启动最初期的权重被压得更低——刚起来的那几十秒恰恰是类加载、连接建立、JIT 未编译最危险的阶段,线性曲线在这个区间给的流量偏多。Dubbo 的默认预热窗口为 10 分钟(warmup默认值 600000 毫秒),默认权重 100。⚠️ 注意别把它写成
1.0 + (1.0 - uptime/warmup) * (weight - 1)这类线性插值式:该式在uptime=0时恰好等于weight(满权重)、在uptime=warmup时等于 1(最低权重),方向完全反了,照此实现会让实例在刚启动时承接全量流量、预热结束时反而被降权。【L3】除权重曲线外,「延迟暴露」同样关键:Spring 容器 refresh 完成之前就把服务注册出去,会出现「地址已可被调用方感知、但 Bean 依赖尚未装配完」的窗口,表现为发布初期的一批调用报 NPE 或找不到服务。做法是把注册动作挂到容器启动完成之后的事件上(如
ContextRefreshedEvent/ApplicationReadyEvent),并预留 Hook 供业务预热缓存与连接。【L4】除应用内预热外,还可在平台层做分批发布(如每批只替换一定比例实例),与应用级预热叠加,避免大批实例同时冷启动引发集群容量缺口。
【L4】预热与自适应负载均衡会在同一时刻争夺「权重」这个变量,工程上必须明确优先级:启动期以预热权重为准(时间驱动),预热结束后交还给自适应打分(指标驱动),否则会出现「刚启动的实例被自适应打分判为慢节点、权重被二次压低,导致永远热不起来」的死锁式现象。
🔀 发散问题
预热和自适应负载均衡有什么关系? 预热是启动期的临时降权,自适应负载均衡是运行期的持续调权,二者都是"动态权重"思想在不同阶段的应用,详见本文档『如何设计自适应的负载均衡?』。
为什么要预留注册前的 Hook? 它给了业务方预加载缓存、预热连接的时机,确保注册时节点真正就绪,而不是"注册了但还没准备好"。
流量回放
架构
【困难】如何设计一个 RPC 框架?⭐⭐⭐⭐
🎯 目标等级:L4 | ⏱ 建议用时:20 min | 🏷 标签:分布式通信 / RPC 架构设计
💎 关键结论
设计 RPC 框架要分层推进:先用"通信 + 协议序列化 + 动态代理"满足 P2P 调用,再叠加"服务发现、负载均衡、路由、容错、配置"等服务治理应对集群场景,最后用 SPI 微内核+插件保证可扩展。理由:基础能力解决"能调通",治理能力解决"调得好",扩展性解决"改得动"。
⚡ 记忆卡片
- 口诀:三层基础能跑通,五块治理能抗住,SPI 插件能扩展。
- 关键词:通信传输/协议+序列化/动态代理/服务治理/SPI 微内核
- 链路:P2P 调用需要通信+协议+代理 → 集群场景叠加服务治理 → 定制需求驱动插件化 → SPI 接口抽象+默认实现 → 形成核心体系+插件体系
📖 核心知识
设计一个 RPC 框架,可以自下而上梳理一下所需要的能力:
- 通信传输模块:RPC 本质上就是一个远程调用,那肯定就需要通过网络来传输数据。
- 协议模块:传输的数据如何定义,就需要通过协议和序列化方式来确定。此外,为了减少传输数据的大小,可以加入压缩功能。
- 代理模块:为了屏蔽用户的感知,让用户更聚焦于自身业务,需要引入动态代理来托管远程调用。
以上,是一个 RPC 框架的基础能力,适用于 P2P 场景。
但是,如果面对集群模式,以上能力就不够了。同一个服务可能有多个提供者。消费者选择调用哪个提供者?消费者怎么找到提供者的访问地址?请求提供者失败了如何处理?这些都依赖于服务治理的能力。
服务治理,需要很多个模块的能力:服务发现、负载均衡、路由、容错、配置管理等。
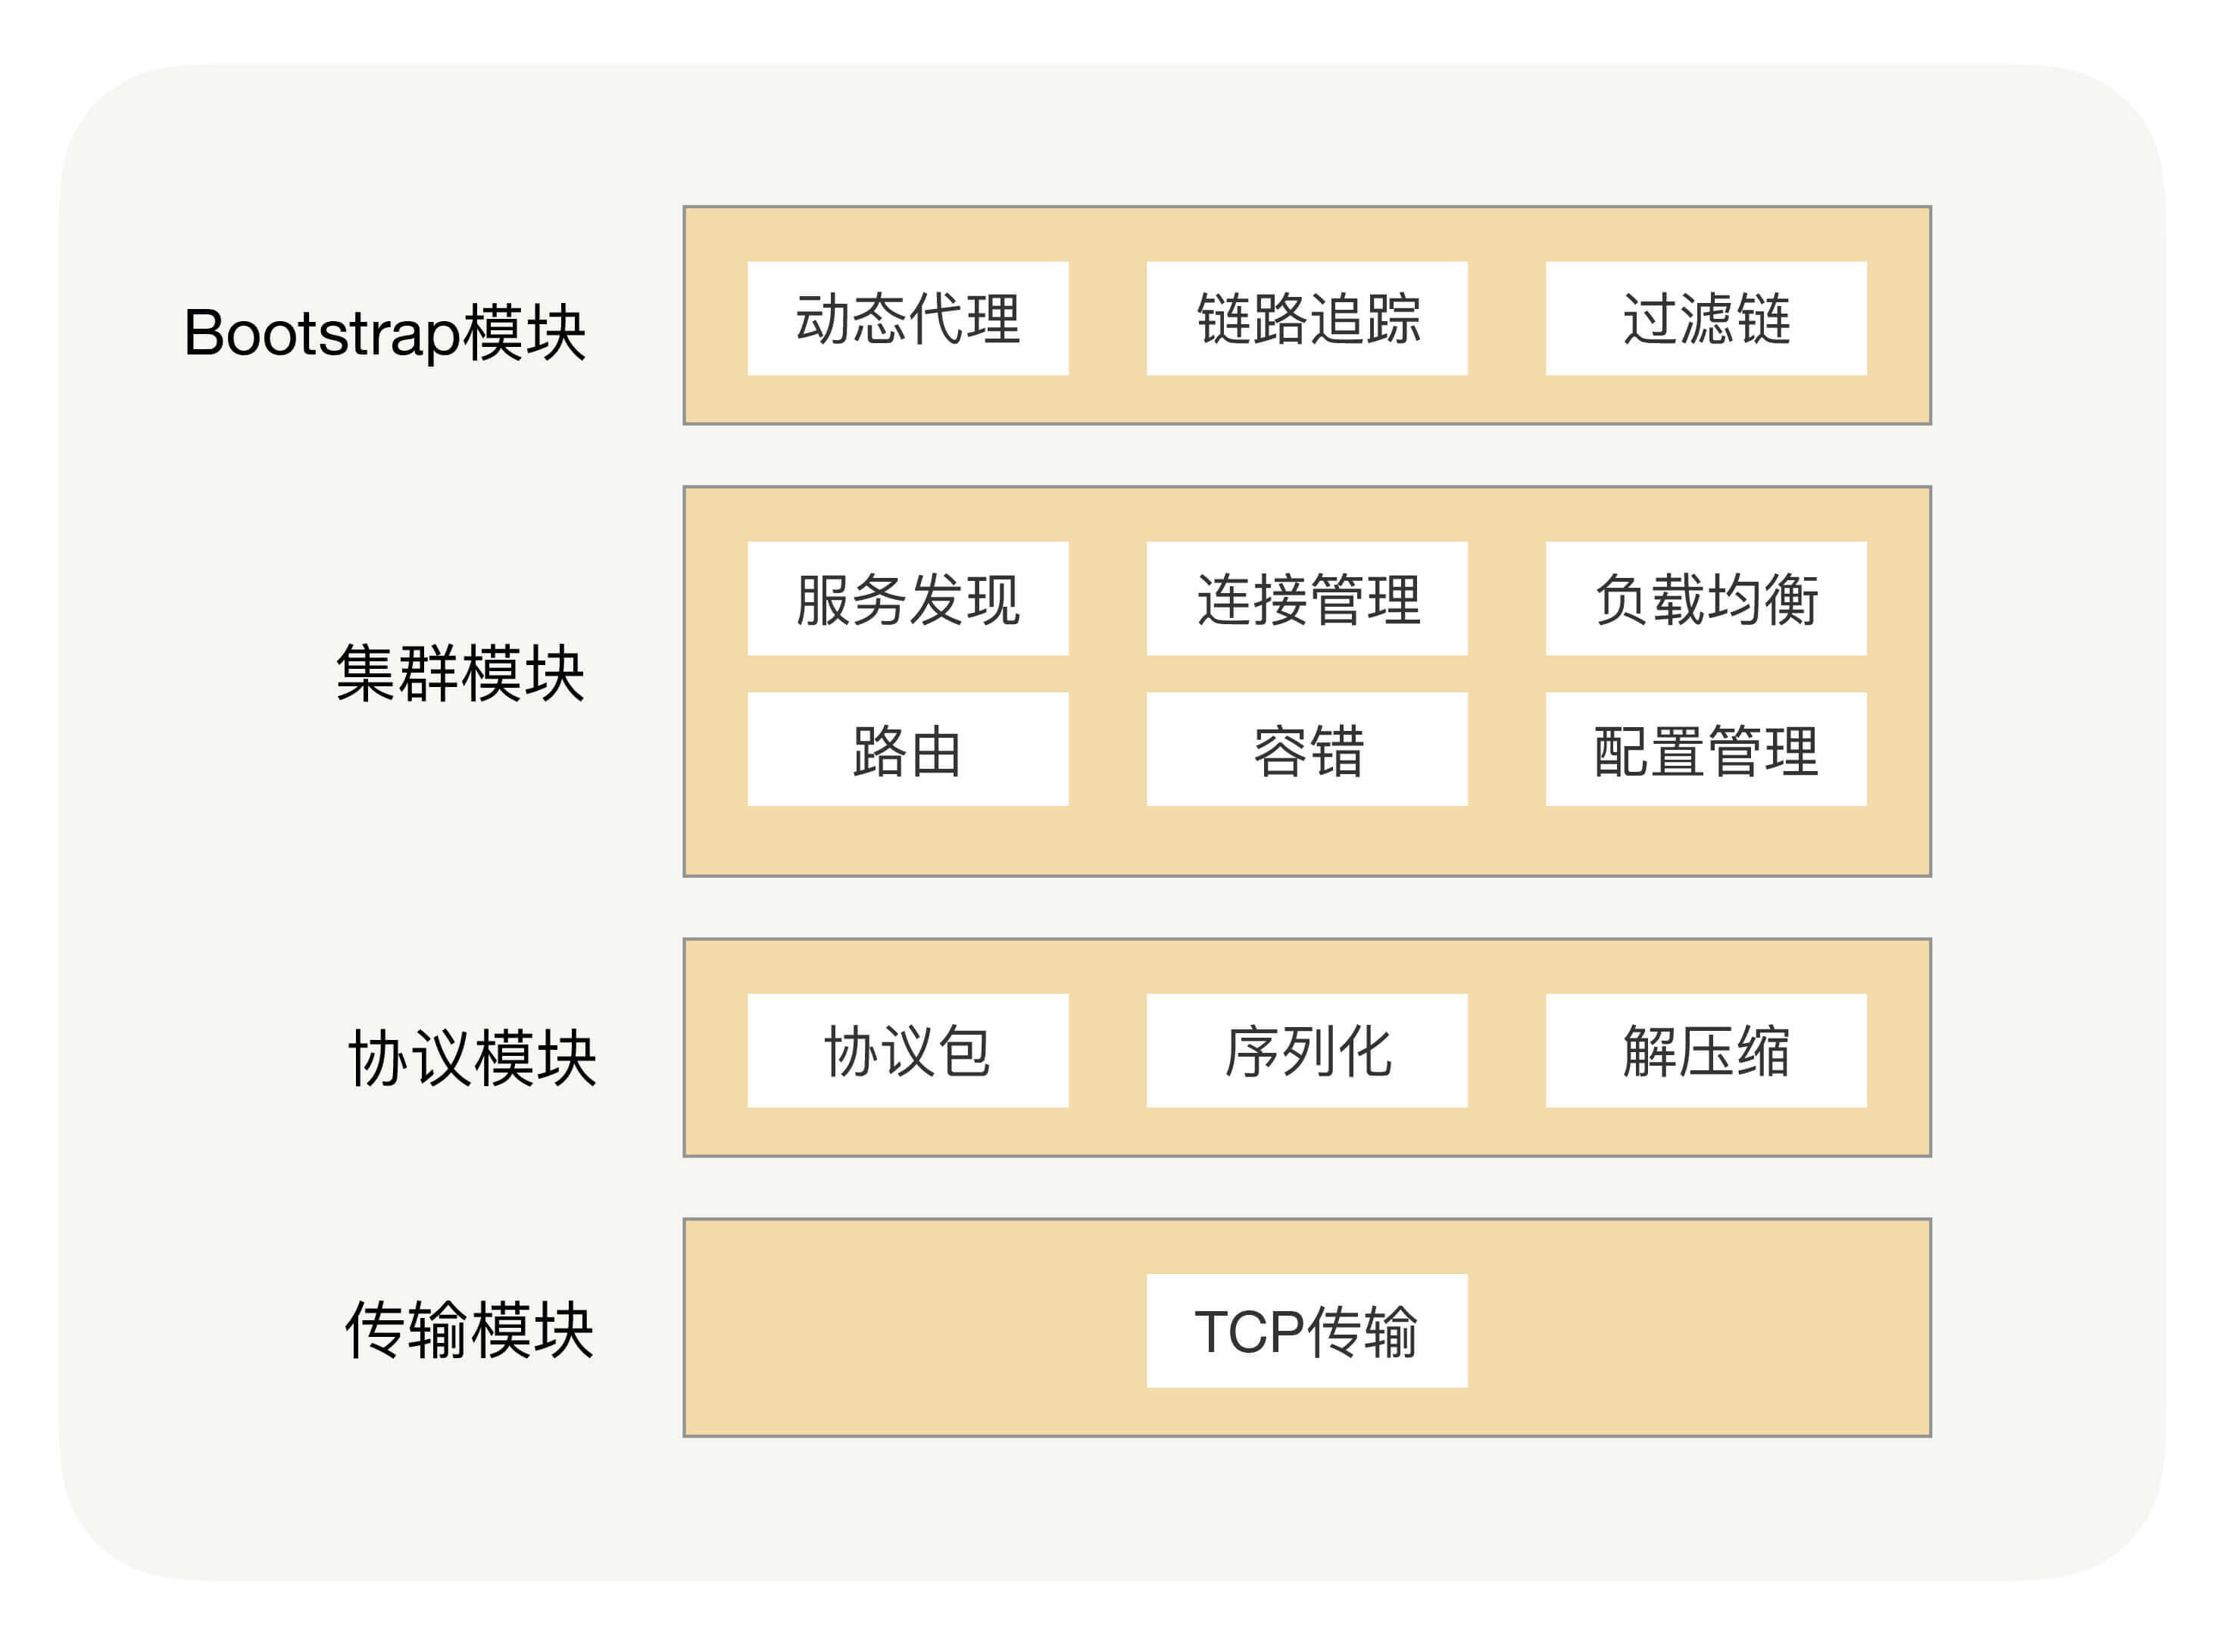
具备了这些能力就万事大吉了吗?RPC 框架很难一开始就面面俱到,但作为基础能力,在实际应用中,难免会有定制化的要求。这就要求 RPC 框架具备良好的扩展性。
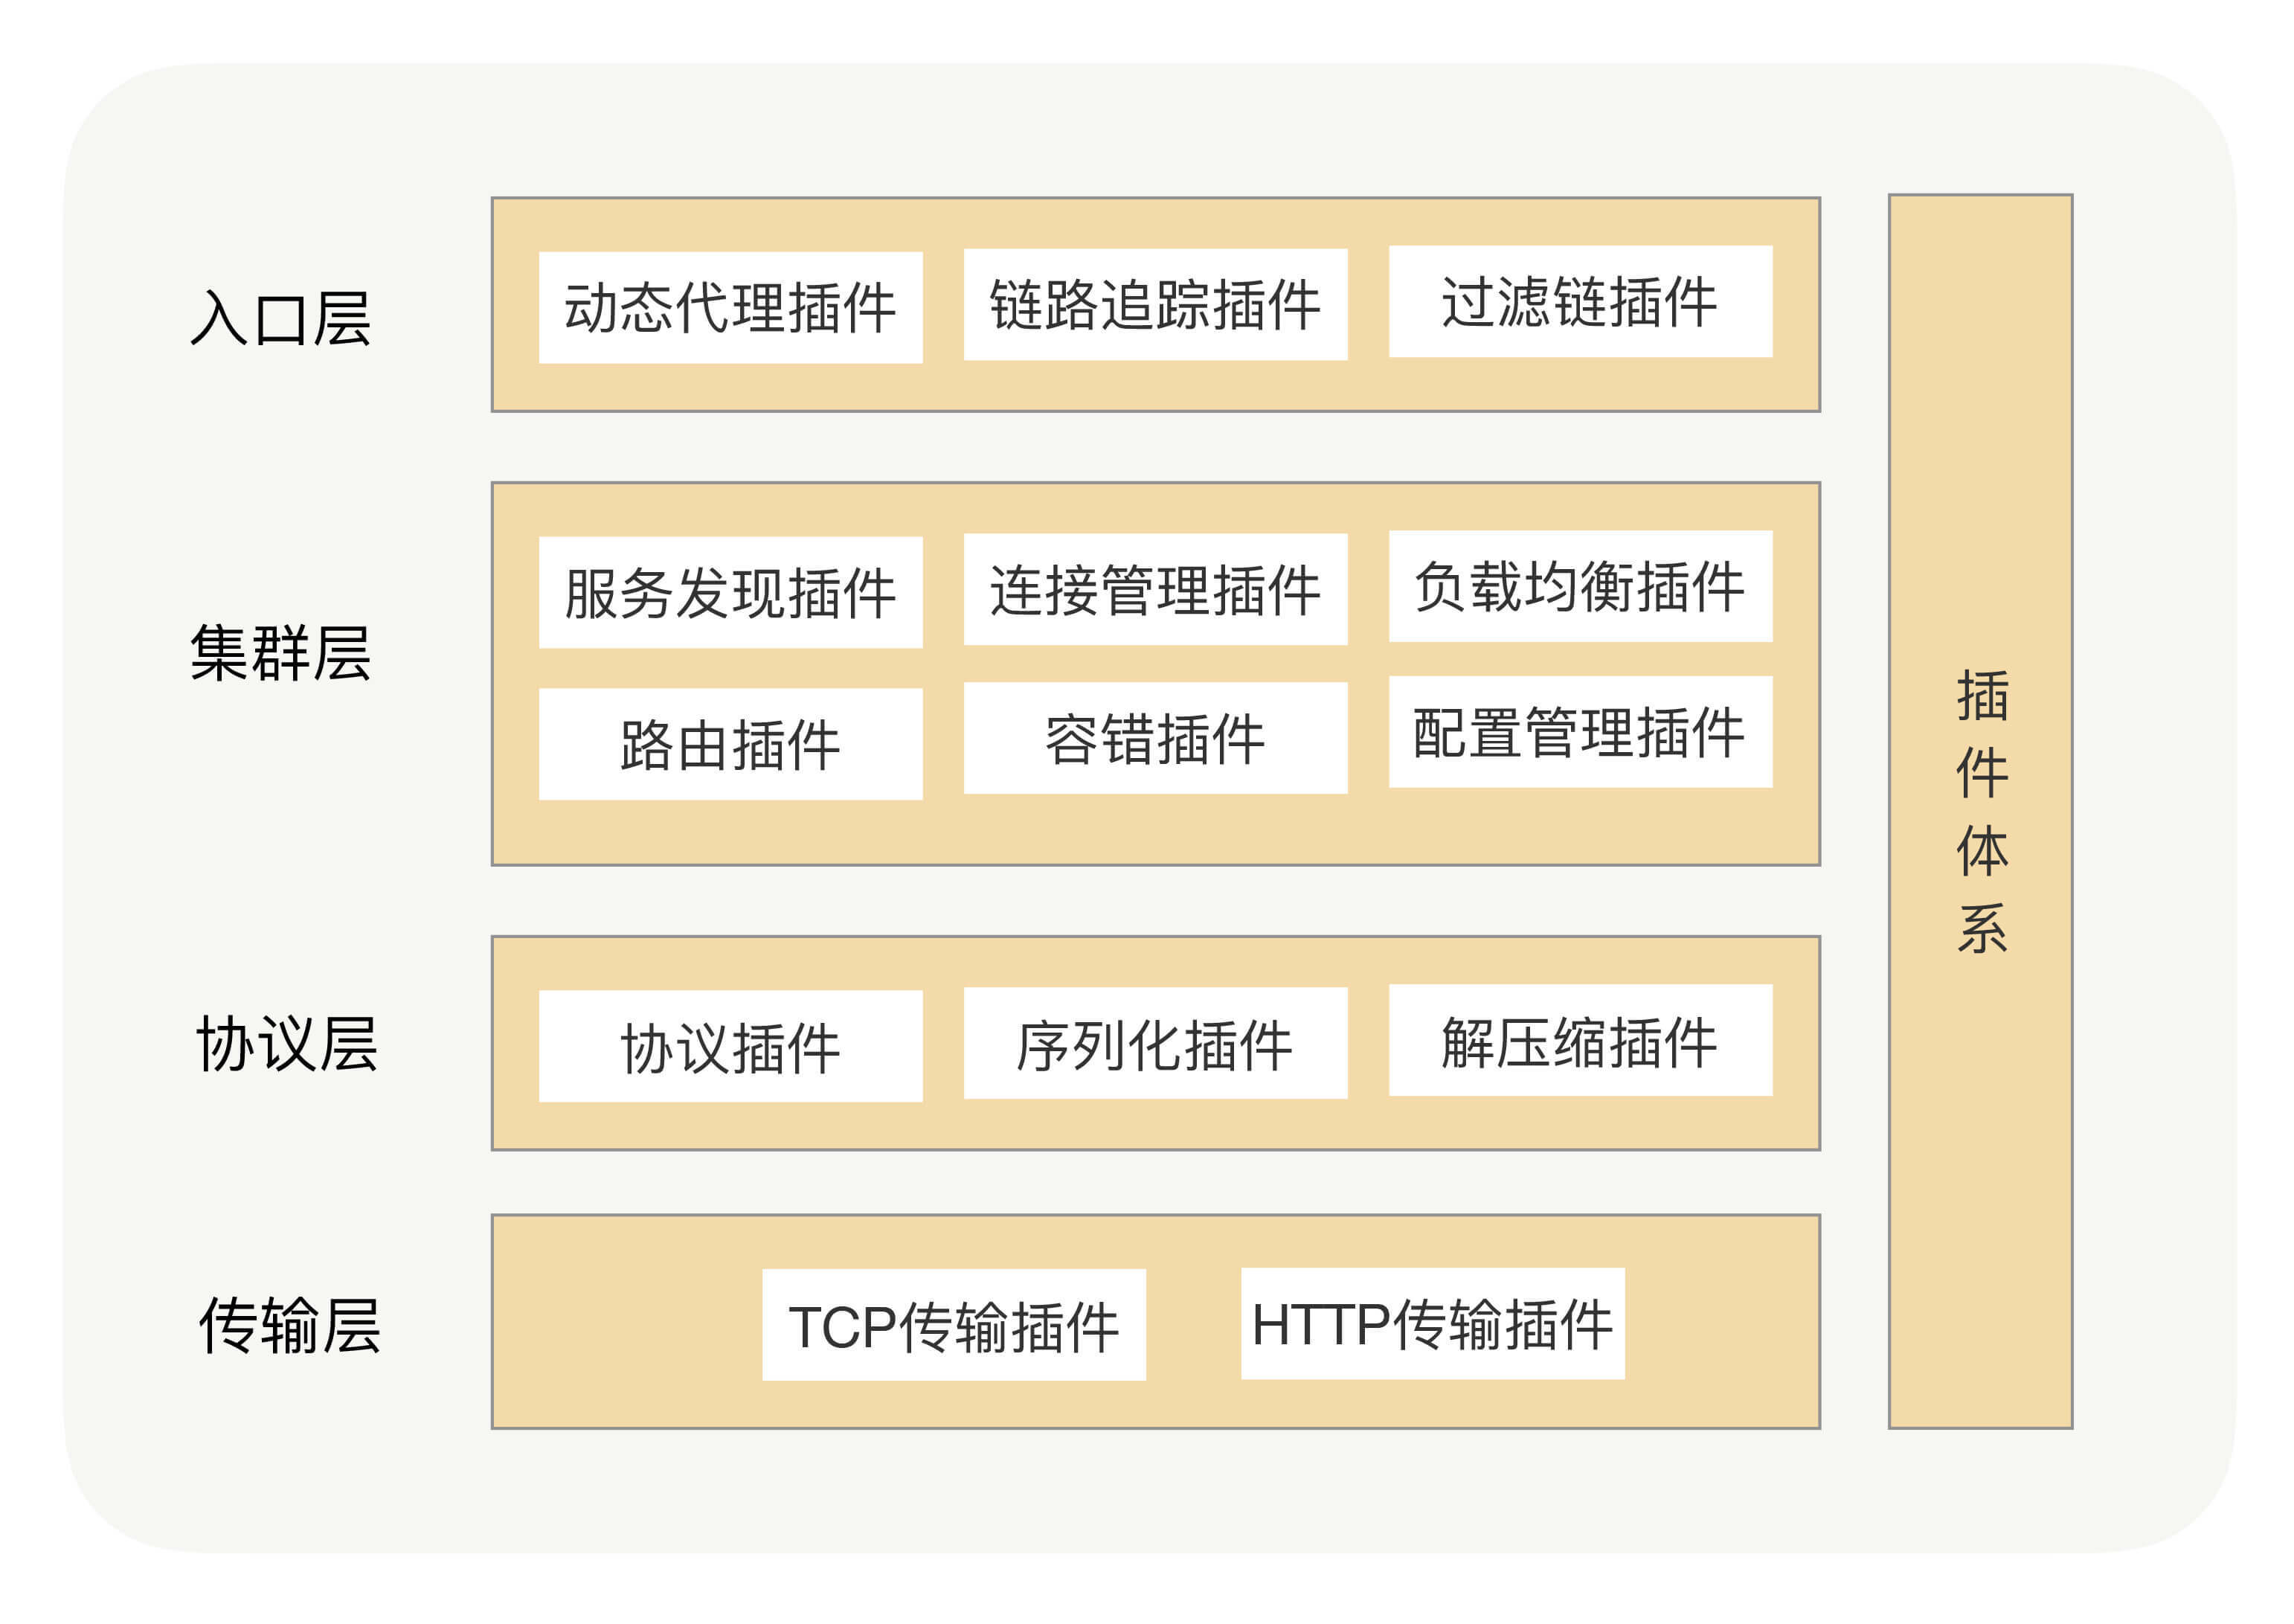
通常来说,框架软件可以通过 SPI 技术来实现微内核+插件架构。根据依赖倒置原则,框架应该先将每个功能点都抽象成接口,并提供默认实现。然后,利用 SPI 机制,可以动态地为某个接口寻找服务实现。
加上了插件功能之后,我们的 RPC 框架就包含了两大核心体系——核心功能体系与插件体系,如下图所示:
案例:Dubbo 的分层设计
Dubbo 是这套设计思路的典型实践,它将框架划分为分层架构:业务层(Service)、接口层(Config/Proxy)、集群层(Cluster:容错/路由/负载均衡)、协议层(Protocol)、交换层(Exchange)、传输层(Transport)。每一层职责单一、面向接口,序列化、负载均衡、集群容错等都以 SPI 扩展点形式提供默认实现,使用者可按需替换,这正是"微内核+插件"的落地形态。
🔬 扩展知识
详情
【L3】线程模型是框架设计的关键决策:IO 线程与业务线程分离(Reactor 主从模式),避免慢业务阻塞网络 IO;线程池隔离与派发策略决定了框架的并发上限。
【L4】全异步化设计(从网络 IO、序列化到业务处理均不阻塞)配合 CompletableFuture,可以显著提升单机吞吐;同时框架需内建指标采集(耗时、成功率、并发数)支撑自适应负载均衡与健康检查。
【L4】SPI 微内核不能照搬 JDK SPI。上面说"用 SPI 实现微内核+插件"只答了一半,P8 会追问「JDK 的
ServiceLoader够用吗」——不够,Dubbo 之所以自己实现ExtensionLoader,是因为 JDK SPI 有四个硬伤:维度 JDK SPI( ServiceLoader)Dubbo SPI( ExtensionLoader)加载方式 一次性实例化配置文件中列出的全部实现,用不到的也创建 按名/按需加载, getExtension("name")才实例化对应实现获取方式 只能迭代遍历,无法按名字精确取一个 key 是配置文件里 name=全限定类名的名字,可直接按名获取依赖注入 无 扩展点 IoC:实例化后扫描 setter,若参数类型也是扩展点则自动注入其代理实例 增强能力 无 扩展点 AOP:构造函数接收同类型接口的类被识别为 Wrapper 装饰器,自动层层包裹;另有 @Activate按条件批量激活(如 Filter 链)两个关键注解:
@Adaptive(自适应扩展) 的实现原理是——Dubbo 在运行时动态生成一个代理类的源码字符串并用 Javassist 编译,该类在每个方法里从传入的URL参数中按约定的 key 取出扩展名,再getExtensionLoader().getExtension(name)拿到真正的实现后委派调用。效果是"到底用哪个实现"被推迟到方法调用的那一刻,由 URL 参数决定,这正是 Dubbo 能把配置以 URL 形式贯穿全链路的原因。@Activate则用于"一组扩展同时生效"的场景(拦截器链),支持按group(provider/consumer)与value(URL 中是否存在某参数)条件激活并排序。扩展点的目录约定:
META-INF/dubbo/internal/(框架内部实现)、META-INF/dubbo/(用户自定义,优先级更高)、META-INF/services/(兼容 JDK SPI 路径)。这套机制是理解 Dubbo 一切可替换能力(协议、序列化、负载均衡、集群容错、路由、Filter)的钥匙。【L4】集群容错(Cluster)模块的六种策略,选型依据是「幂等性」与「流量放大」两个维度:
策略 行为 适用场景 代价/风险 Failover(默认) 失败自动切换其他节点重试,Dubbo 默认 retries=2,即最多共 3 次调用读操作、幂等写操作 ⚠️ 非幂等写操作会重复执行——必须要么保证幂等,要么改用 Failfast Failfast 只调一次,失败立即抛错 非幂等写(下单、扣款、新增记录) 可用性下降,需业务侧自行重试与补偿 Failsafe 失败直接忽略,只记日志 日志埋点、监控上报、审计写入等"丢了也无所谓"的旁路 故障被静默吞掉,必须有监控兜住 Failback 失败后记录,由定时任务重发 消息通知、最终一致性补偿 需要持久化失败任务,重发时机不可控 Forking 并行调用多个节点,取最快返回的那个 实时性要求极高的读场景 流量放大 n 倍,只在读多写少且成本可接受时用 Broadcast 逐个调用所有节点,任一失败即报错 更新所有节点的本地缓存、通知所有实例刷新配置 节点数多时耗时线性增长,不适合大集群 【L4】重试与幂等是同一个问题的两面,这是必考点。只要存在自动重试(Failover、客户端超时重发、MQ 重投、网关重试),下游就必须幂等——因为「客户端超时」并不等于「服务端没执行」:请求可能已经处理完,只是响应在回程丢了,此时重试就是第二次执行。幂等的通用建模是唯一业务键 + 状态机(或数据库唯一索引、去重表、
SETNX占位),而不是靠"重试次数设小一点"来规避。【L4】超时与重试必须做「层级递减」,否则会造出雪崩:
- 超时递减:上游的超时必须 大于「所有下游超时之和 + 网络与序列化开销」,否则会出现「上游早已放弃并返回失败,下游还在认真执行」——白烧资源,还可能造成状态不一致(上游认为失败做了补偿,下游其实成功了)。每一层的超时应当逐层收窄,最底层最紧。
- 重试递减:越靠下游,重试次数越少甚至为 0。因为重试是乘法关系:3 层调用链、每层重试 3 次,最坏情况下一次用户请求会放大成 3×3×3 = 27 次下游调用。
- 重试预算(Retry Budget):给重试流量设一个占比上限(如"重试请求不超过总请求的 10%"),超出就不再重试。这是防止放大失控的最后一道闸——服务本身已经变慢时,无预算的重试会把「一个节点慢」放大成「整个集群被打死」,这正是重试风暴引发雪崩的机制。
- 指数退避 + 抖动(jitter):失败后等待时间指数增长,并加入随机抖动,避免大量客户端在同一时刻同步重试形成脉冲;否则重试流量会与故障周期共振。
- 配套:熔断(错误率/慢调用比例超阈值后直接短路,不再产生重试流量)与重试只应作用于「可安全重试的错误」——连接被重置、
ShutdownException(请求未被业务处理)可重试;业务异常、参数校验失败重试没有意义。
【L4】「自研 RPC 框架 vs 用开源」的完整决策论证——这是本题真正的落点,也是 P8 架构决策题的原型。
- 自研的收益:协议与序列化完全可控(可做极致压缩、私有安全握手)、可深度贴合内部基础设施(统一的服务发现、配置中心、链路追踪、单元化路由)、无外部版本升级的被动跟随、能裁掉不需要的能力降低复杂度。
- 自研的代价(通常被严重低估):长期维护成本——框架是"永远不能停"的组件,粘包拆包边界、堆外内存泄漏、连接假死、超时映射表泄漏、序列化兼容、跨版本灰度,每一个都是要花线上故障换来的经验;人才依赖——核心维护者离职即成为无人区;生态缺失——开源框架的 Mesh 互通、多语言 SDK、社区 bug 修复都无法复制;踩坑的时间成本——Dubbo/gRPC 里那些看起来冗余的设计(Dispatcher 派发策略、预热曲线、优雅停机时序)背后都是历史事故。
- 结论(应当有明确立场):绝大多数团队应选「开源框架 + 定制扩展点」。开源框架的 SPI/插件体系(Dubbo 的
ExtensionLoader、gRPC 的 Interceptor 与 NameResolver/LoadBalancer 接口)已经预留了几乎所有需要定制的位点:自定义序列化、自定义路由与负载均衡、鉴权 Filter、链路埋点。只有当「协议必须私有」或「规模大到开源框架的通用抽象本身成为性能瓶颈」时才考虑自研,且自研也应从开源框架的分层设计起步,而不是从零写网络层。判断口径:把「自研」当成一次永久性的基础设施投入(含 oncall、文档、升级、安全响应),而不是一个季度的项目——按这个口径算 TCO 后,绝大多数场景答案会自动浮现。
【L4】容量规划:框架设计必须给出可算的数字,而不是"支持高并发"。
- 单实例 QPS 安全水位怎么压出来:阶梯式加压(每档稳定数分钟),同时观察 P99 延迟、错误率、业务线程池活跃数与队列长度、CPU、GC 停顿。安全水位取「P99 开始明显抬头(拐点)之前」的那个档位,再乘一个折扣(留出 GC、突发流量与故障转移的余量),而不是取压到报错前的最大值。压测必须用真实的报文大小与真实的下游依赖(或等价的桩),否则序列化与网络开销会被严重低估。
- 业务线程池大小的依据:经典起点是 IO 密集型
线程数 ≈ CPU 核数 × (1 + 等待时间/计算时间),其中「等待时间/计算时间」应从线上实际的 Span 耗时里测而不是拍脑袋;再叠加一条硬约束——线程数必须与队列容量一起定,且队列必须有界,无界队列会把过载伪装成延迟,让上游一直重试。 - 连接数的依据:连接数 ≈ 需要并发在途的请求数 ÷ 单连接可承载的并发数。单条 TCP 连接的吞吐受限于带宽时延积(BDP = 带宽 × RTT)与 TCP 窗口;内网低 RTT 场景下单连接通常足够,跨地域高 RTT 或大报文场景才需要多连接。同时要核对文件描述符上限(
ulimit -n)与N×M的总连接数是否可承受。
🏭 实战场景
详情
推演场景(非生产真实数据):假设某公司有 2000+ 微服务实例,单服务日均调用量千万级。若框架仅实现 P2P 调用而无服务发现,每次扩容都要人工维护地址列表,运维成本不可接受;若无集群容错,单节点抖动会直接传导为业务失败。因此落地时通常按"先通信协议与代理 → 再注册发现与负载均衡 → 后路由、容错、监控"的顺序分期建设,每层通过 SPI 预留替换点,避免后期推倒重来。
⚠️ 常见误区
详情
常见误区:
- ❌ "RPC 框架只需要实现网络通信和序列化就够了" → 集群环境下没有服务发现、负载均衡、容错,框架无法支撑真实生产,治理能力和基础能力同等重要。
- ❌ "扩展性后期再加也不迟" → 扩展点(SPI)需要在架构初期就按接口抽象设计,后期改造需要大面积重构并破坏既有插件兼容。
- ❌ "默认实现越强大越好,不需要插件机制" → 不同业务的序列化、容错策略诉求差异大,硬编码默认逻辑会导致框架无法适配定制场景。
🔀 发散问题
框架的异步能力怎么设计? 通过消息 ID 与 Future 的映射实现响应回填,详见本文档『如何实现 RPC 异步调用?』。
协议层怎么设计才平滑升级? 协议头可扩展、三段式结构,详见本文档『设计一个 RPC 协议的要点?』。
框架的高可用由谁保证? 框架自身靠集群容错(失败重试、快速失败等),注册中心靠 AP 可用性,详见本文档『如何实现一个注册中心?』。
【困难】如何实现 RPC 异步调用?⭐⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:15 min | 🏷 标签:分布式通信 / 异步调用
💎 关键结论
RPC 框架内部无论同步还是异步都是异步的:每条消息有唯一标识,发送前创建 Future 并存储"消息 ID → Future"映射,响应到达后回填对应 Future;同步调用只是框架帮你主动执行了 Future 的 get。理由:网络响应与请求天然不同步,必须靠映射机制把结果还给正确的调用。
⚡ 记忆卡片
- 口诀:消息有 ID,Future 有映射,同步只是框架帮你 get。
- 关键词:消息唯一标识/Future 映射/同步阻塞 get/CompletableFuture 全异步
- 链路:发送前创建 Future 并存映射 → 响应到达按 ID 找 Future → 回填结果 → 同步则框架 get,异步则用户自定 get 时机
📖 核心知识
一次 RPC 调用的本质就是调用端向服务端发送一条请求消息,服务端收到消息后进行处理,处理之后响应给调用端一条响应消息,调用端收到响应消息之后再进行处理,最后将最终的返回值返回给动态代理。
对于 RPC 框架,无论是同步调用还是异步调用,调用端的内部实现都是异步的。
调用端发送的每条消息都一个唯一的消息标识,实际上调用端向服务端发送请求消息之前会先创建一个 Future,并会存储这个消息标识与这个 Future 的映射,动态代理所获得的返回值最终就是从这个 Future 中获取的;当收到服务端响应的消息时,调用端会根据响应消息的唯一标识,通过之前存储的映射找到对应的 Future,将结果注入给那个 Future,再进行一系列的处理逻辑,最后动态代理从 Future 中获得到正确的返回值。
所谓的同步调用,不过是 RPC 框架在调用端的处理逻辑中主动执行了这个 Future 的 get 方法,让动态代理等待返回值;而异步调用则是 RPC 框架没有主动执行这个 Future 的 get 方法,用户可以从请求上下文中得到这个 Future,自己决定什么时候执行这个 Future 的 get 方法。

如何做到 RPC 调用全异步?
实现 RPC 调用全异步的方法是让 RPC 框架支持 CompletableFuture。CompletableFuture 是 Java8 原生支持的。如果 RPC 框架能够支持 CompletableFuture,现在发布一个 RPC 服务,服务接口定义的返回值是 CompletableFuture 对象,整个调用过程会分为这样几步:
- 服务调用方发起 RPC 调用,直接拿到返回值
CompletableFuture对象,之后就不需要任何额外的与 RPC 框架相关的操作了,直接就可以进行异步处理; - 在服务端的业务逻辑中创建一个返回值
CompletableFuture对象,之后服务端真正的业务逻辑完全可以在一个线程池中异步处理,业务逻辑完成之后再调用这个CompletableFuture对象的complete方法,完成异步通知; - 调用端在收到服务端发送过来的响应之后,RPC 框架再自动地调用调用端拿到的那个返回值
CompletableFuture对象的complete方法,这样一次异步调用就完成了。
通过对 CompletableFuture 的支持,RPC 框架可以真正地做到在调用端与服务端之间完全异步,同时提升了调用端与服务端的两端的单机吞吐,并且 CompletableFuture 是 Java8 原生支持,业务逻辑中没有任何代码入侵性。
🔬 扩展知识
详情
- 【L3】Future 映射表需处理超时清理:请求发出后若响应迟迟未到,应由超时机制(如定时任务)主动移除映射并异常完成 Future,避免映射表无限增长与调用永久阻塞。
- 【L3】这套 requestId 映射机制正是「单条长连接支撑高并发」的实现基础。一个消费者对一个提供者默认只建一条 TCP 连接,成百上千个并发请求同时在这条连接上飞,彼此的响应靠 requestId 精确归还给对应的 Future——这就是应用层多路复用。没有它,要么每请求一条连接(连接数与端口爆炸、TIME_WAIT 堆积),要么连接上串行等待(吞吐被 RTT 锁死)。requestId 通常用原子自增的
long,回绕(wrap around)在实践上不构成问题,但必须保证同一条连接上在途的 requestId 不重复。 - 【L4】映射表泄漏的具体形态与排查:Dubbo 的
DefaultFuture内部维护一个全局的Map<Long, DefaultFuture>,由一个定时任务(TimeoutCheckTask)周期扫描,把超时的 Future 以TimeoutException完成并从 Map 中移除。如果超时扫描没跑起来、或者 Future 完成时没有从 Map 里摘除,这个全局 Map 就会单调增长——表现为堆内存缓慢上涨、GC 频率升高、最终 OOM,而 heap dump 里能看到大量DefaultFuture与其持有的请求对象。排查手法:定期打印该 Map 的 size(应与"当前在途请求数"同量级),若持续增长而不回落即为泄漏。同理,服务端也要为「客户端已超时放弃」的请求做处理——此时服务端仍会把结果写回连接,客户端收到后因找不到对应 Future 而直接丢弃,这属于正常现象,但会在日志里留下"response future not found"类的记录,不要误判为故障。 - 【L4】回调执行线程需要设计:响应 IO 线程直接执行用户回调会阻塞网络处理,通常把回调切换到独立业务线程池执行,代价是多一次线程切换。这与『RPC 在网络通信上倾向选择哪种网络 IO 模型?』里"EventLoop 里绝不能做阻塞操作"是同一条纪律:Netty 的 EventLoop 与 Channel 是一对一固定绑定,一个 EventLoop 被回调阻塞,它名下所有连接的读写都会停摆。
🔀 发散问题
异步调用和流式调用是一回事吗? 不是:异步仍是一请求一响应只是不阻塞,流式是一次调用内多条消息,详见本文档『什么是 RPC 流式调用?有哪些模式?』。
超时后服务端才处理完怎么办? 客户端已放弃等待,服务端结果被丢弃;对一致性敏感的业务需要配合幂等与对账机制。
【困难】什么是 RPC 流式调用?有哪些模式?⭐⭐⭐
🎯 目标等级:L3 | ⏱ 建议用时:15 min | 🏷 标签:分布式通信 / 流式调用
💎 关键结论
流式调用打破了"一请求一响应"的限制,允许一次 RPC 调用中多次发送/接收数据,共有 Unary、Server Streaming、Client Streaming、双向流四种模式,基于 HTTP/2 的 Stream 语义实现。理由:大数据量分批传输与实时交互场景下,传统单次请求响应既低效又不自然。
⚡ 记忆卡片
- 口诀:一请求一响应变多请求多响应,四种模式靠 HTTP/2 Stream。
- 关键词:Unary/Server Streaming/Client Streaming/Bidirectional Streaming/StreamObserver
- 链路:传统一问一答不够用 → 基于 HTTP/2 Stream 开放多次收发 → 四种模式覆盖不同方向 → 适配大文件、实时推送等场景
📖 核心知识
流式调用(Streaming Call) 是指在一次 RPC 调用中,允许客户端或服务端多次发送/接收数据,而不是传统的"一请求一响应"模式。流式调用基于 HTTP/2 的 Stream 语义实现。
四种通信模型:
| 模式 | 说明 | 典型场景 |
|---|---|---|
| Unary(一元) | 一次请求,一次响应(传统 RPC) | 普通业务调用 |
| Server Streaming | 一次请求,多次响应 | 大数据量分批返回、实时推送 |
| Client Streaming | 多次请求,一次响应 | 上传文件分块、批量数据采集 |
| Bidirectional Streaming | 双向流,多次请求多次响应 | 实时聊天、实时数据同步、协同编辑 |
Dubbo3 Triple 流式调用示例:
// 服务端流式
public interface GreetService {
    StreamObserver<HelloRequest> sayHelloStream(StreamObserver<HelloReply> responseObserver);
}

// 客户端调用
StreamObserver<HelloRequest> requestObserver = greetService.sayHelloStream(new StreamObserver<HelloReply>() {
    @Override
    public void onNext(HelloReply reply) {
        System.out.println("收到响应: " + reply.getMessage());
    }
    @Override
    public void onCompleted() {
        System.out.println("响应结束");
    }
});
// 发送多次请求
requestObserver.onNext(HelloRequest.newBuilder().setName("A").build());
requestObserver.onNext(HelloRequest.newBuilder().setName("B").build());
requestObserver.onCompleted();
流式调用 vs 异步调用:
- 异步调用:仍然是一请求一响应,只是不阻塞等待结果。
- 流式调用:可以在一次调用中传输多条消息,适合大数据量、实时交互场景。
适用场景:
- 大文件传输(分块流式)
- 实时数据推送(股票行情、IM 消息)
- IoT 设备数据上报
- AI/ML 模型推理结果流式返回
🔬 扩展知识
详情
- 【L3】流式调用的背压(flow control)由 HTTP/2 的流量控制窗口保障:接收方处理能力不足时可缩小窗口,发送方自动降速,避免慢消费者被压垮。
- 【L4】双向流场景下需处理半关闭语义:一端调用 onCompleted 只关闭自己的发送方向,另一方向仍可继续发送,正确管理生命周期是避免资源泄漏的关键。
- 【L4】流式调用让「超时」这个概念失效,必须换成两套新的时间约束:unary 调用配一个总超时即可,但一条长连接上的流可能持续数小时,用「调用超时」去套会导致流被无谓掐断。工程上的替代是:空闲超时(idle timeout,多久没收到消息就断) + 单条消息的处理超时,再加**总量上限(一次流最多多少条消息 / 多大字节)**防止无限流打爆内存。
- 【L4】取消(cancellation)必须能沿调用链传播:客户端断开或主动取消时,服务端要能感知并停止生产数据(gRPC 通过 HTTP/2 的
RST_STREAM帧、Dubbo Triple 通过对应的流关闭语义),否则服务端会继续为一个没人接收的流做无用的计算与查询。多层流式调用(A 流式调 B、B 流式调 C)时,取消要逐层向下传递,这是流式场景特有的资源治理问题。
🔀 发散问题
哪些协议支持流式调用? 需要 HTTP/2 Stream 语义,如 Triple、gRPC;基于 TCP 的 Dubbo2 协议不支持,详见本文档『什么是 Triple 协议?』。
流式和多次普通调用有什么区别? 流式共享同一个调用上下文与连接流,开销更低、天然保序;多次普通调用相互独立,无法保证顺序且开销更大。
【中等】RPC 如何实现泛化调用?⭐⭐
🎯 目标等级:L2 | ⏱ 建议用时:12 min | 🏷 标签:分布式通信 / 泛化调用
💎 关键结论
泛化调用让调用端在没有服务接口 API 的情况下发起 RPC 调用:通过统一的 GenericService 代理,把接口名、分组、方法名、参数全部以字符串/通用类型封装进请求消息发送给服务端。理由:测试平台、轻量网关这类通用入口不可能依赖所有业务方的接口包。
⚡ 记忆卡片
- 口诀:没有接口也能调,字符串描述接口方法参数。
- 关键词:GenericService/
$invoke/接口名+方法名+参数/专属序列化插件 - 链路:调用端无接口 API → 创建 GenericService 代理并指定接口/分组 →
$invoke封装全部调用信息 → 发送请求给服务端 → 专属序列化插件完成编解码
📖 核心知识
在一些特定场景下,需要在没有接口的情况下进行 RPC 调用。例如:
场景一:搭建一个统一的测试平台,可以让各个业务方在测试平台中通过输入接口、分组名、方法名以及参数值,在线测试自己发布的 RPC 服务。

场景二:搭建一个轻量级的服务网关,可以让各个业务方用 HTTP 的方式,通过服务网关调用其它服务。

为了解决这些场景的问题,可以使用泛化调用。
就是 RPC 框架提供统一的泛化调用接口(GenericService),调用端在创建 GenericService 代理时指定真正需要调用的接口的接口名以及分组名,通过调用 GenericService 代理的 $invoke 方法将服务端所需要的所有信息,包括接口名、业务分组名、方法名以及参数信息等封装成请求消息,发送给服务端,实现在没有接口的情况下进行 RPC 调用的功能。
class GenericService {
Object $invoke(String methodName, String[] paramTypes, Object[] params);
CompletableFuture<Object> $asyncInvoke(String methodName, String[] paramTypes);
}
而通过泛化调用的方式发起调用,由于调用端没有服务端提供方提供的接口 API,不能正常地进行序列化与反序列化,我们可以为泛化调用提供专属的序列化插件,来解决实际问题。
🔬 扩展知识
详情
- 【L3】泛化调用的参数通常以 Map 形式描述 POJO(类名 + 字段键值对),服务端序列化插件负责把 Map 还原为真实业务对象,因此泛化调用的性能与安全性(参数校验)都弱于普通调用,适合平台型场景而非业务主链路。
- 【L4】轻量网关用泛化调用时,需要自行完成 HTTP 参数到泛化参数的映射、服务发现与鉴权,本质上泛化调用是网关的"最后一公里"执行器。
🔀 发散问题
为什么泛化调用需要专属序列化插件? 调用端没有业务类定义,常规序列化无法编解码,需要用 Map/通用描述代替 POJO 并在服务端还原。
泛化调用和动态代理是什么关系? 泛化调用同样依赖动态代理生成 GenericService 的代理对象,只是代理拦截后组装的是字符串化的调用信息,详见本文档『RPC 如何将远程调用转为本地调用的?』。
Dubbo 中泛化调用具体怎么用? 通用原理之上,Dubbo 通过 ReferenceConfig 设置 generic=true(或用 @DubboReference 注解开启 generic)发起泛化引用,服务端 GenericFilter 自动完成 Map↔POJO 转换,详见《Dubbo 面试之应用》『Dubbo 的泛化调用如何使用?』。